选拔考量与政策关切博弈模型
全景深度解析与数理推导手册
A Model of Selection and Policy Concerns — 数理建模、贝叶斯更新、命题推导与制度启示
| 论文标题 | A MODEL OF SELECTION AND POLICY CONCERNS (选拔考量与政策关切博弈模型) |
|---|---|
| 论文作者 | Álvaro Delgado-Vega (University of Chicago), Benjamin Shaver (University of Chicago / Northwestern University) |
| 发表期刊 | The Economic Journal, Vol. 136, Iss. 678 (August 2026), pp. 2224–2238 (DOI: 10.1093/ej/ueaf102) |
| JEL 分类号 | D23 (组织行为; 交易成本; 产权), D72 (政治过程: 寻租、选举与立法), D73 (官僚体系与公共组织行政过程) |
一、 全文总结与核心理论贡献
1.1 现实问题背景与历史典故引言
在许多层级组织、政党派系以及政企博弈中,“政策或项目的制定者(Ideas Person)”与“政策落地的执行者(Implementation Person)”往往并非同一个人,且二者经常处于潜在的晋升竞争(Rank-Order Competition)关系中。例如:公司的现任首席执行官(CEO)提出了一项企业转型战略,必须由被视为其潜在接班人的高级执行副总裁来推动执行;若战略失败,董事会可能罢免CEO并提拔该副总裁。又如:大都市雄心勃勃的激进派市长提出了一项学前教育法案,需要来自同党但立场温和的州长提供财政资金支持,而州长深知市长未来可能成为其竞选连任的有力挑战者。
这种微妙的竞争合作博弈在历史上最经典的案例莫过于1797年拿破仑·波拿巴(Napoleon Bonaparte)远征埃及事件。当时拿破仑刚在意大利用兵大获全胜,声望如日中天,成为法国当时执政的督政府(The Directory)最大的政治威胁。督政府民调低迷、统治脆弱。当拿破仑向督政府游说请求远征埃及时,督政府深知征服埃及对法国的地缘战略价值极高(具有共同的政策偏好),但更为关键的是其背后的政治选拔考量(Selection Concerns):如果督政府掣肘或拒绝,拿破仑会继续留在巴黎威胁政权;如果督政府全力资助拿破仑远征,若拿破仑获胜,督政府可以借由提供粮草军队而“分担功劳(Share Credit)”;若拿破仑在埃及惨败,则由于督政府已倾力相助,失败的责任将完全归咎于拿破仑个人能力,使其“声誉满意地受损(Reputation Satisfyingly Tarnished)”,从而化解其政治威胁。因此,政治竞争非但没有诱发督政府的暗中破坏,反而强化了其倾力协助拿破仑的激励!
1.2 论文核心理论贡献
Álvaro Delgado-Vega 与 Benjamin Shaver 发表在顶刊《The Economic Journal》(2026) 的这篇重磅论文,通过构建一个包含委托人(Principal,即政策设计者)、代理人(Agent,即执行协助/破坏者)与评选委员会(Committee)的三方动态博弈模型,得出了三大颠覆性理论贡献:
【理论突破一:竞争与协助的逆转效应】 (1)颠覆了传统序位锦标赛理论(Rank-Order Tournaments)的经典结论。在传统锦标赛文献(如 Lazear, 1989; Dye, 1984; Falk et al., 2008)中,由于代理人的产出取决于自身努力与相对破坏,扩大胜出奖金差距(Prize Spread )必然导致代理人将精力从生产性协助转向破坏性掣肘(Sabotage)。然而本文证明,当代理人的行动会内生改变政策结果对委托人能力的“贝叶斯信息诊断度”时,增大选拔奖金 反而会扩大代理人主动协助(Help)的参数区间!代理人协助的动机在于“事后推卸失败责任(Shift Blame)”或“事后分担成功功劳(Share Credit)”。
【理论突破二:内生议程设置与选拔考量杠杆】 (2)揭示了选拔考量下的内生议程设置与政策勒索优势。在既有关于政治破坏的研究中(如 Hirsch & Kastellec, 2022; Kang, 2022),政策往往是外生给定的。本文将政策议程 内生化。委托人面临核心权衡:要么做出政策让步以换取协助,要么坚持自身偏好而招致破坏。研究证明,当代理人具有选拔考量时,委托人能够“战略性利用”代理人想推卸责任或分享功劳的野心,以更小的政策让步换取其全力协助。尽管这在客观上增加了代理人被委员会选拔的概率,但委托人从政策偏好中获得的净收益严格大于选拔概率下降的损失。
【理论突破三:平庸选才(Mediocracy)的全新微观基础】 (3)为政治经济学与公司治理中的“平庸统治/次优选才(Mediocracy)”提供了全新的微观博弈机理。既有文献认为领导者任用平庸之辈是因为高能力下属具有更好的外部机会(Mattozzi & Merlo, 2015)或信息优势带来的背叛风险(Egorov & Sonin, 2011)。本文证明,领导者的期望效用随代理人的先验能力呈现非单调变化:与能力势均力敌的下属合作会导致必然的掣肘;与毫无威胁的平庸之辈合作虽无被取代之虞,但对方也缺乏协助激励;唯有与“中等/平庸能力(Mediocre)”的代理人合作,领导者才能最大化撬动其推卸责任的野心,从而实现委托人全局期望效用的最大化!
二、 数理模型构建与公理化设定
2.1 参与人、类型空间与博弈时序
模型包含一个组织内部的三类参与人:委托人(Principal,代指 ,女性人称代词 she)、代理人(Agent,代指 ,男性人称代词 he)以及评选委员会(Committee)。
• 类型与先验分布:每个主体 拥有未知的客观能力类型 ,其中 代表高能力(High Type), 代表低能力(Low Type)。令 表示外生给定的先验能力概率。
• 博弈的三阶段动态时序(Timing):
阶段 1(议程设置阶段 Agenda-setting stage):委托人公开选择一项政策议程 。
阶段 2(政策执行阶段 Policy stage):代理人公开观测到政策 后,选择是否全力协助执行()或是暗中破坏/掣肘()。随后,政策结果随机生成:成功记为 ,失败记为 ,成功概率由技术函数 决定。
阶段 3(选拔评价阶段 Selection stage):委员会公开观测到代理人的行动决策 以及政策的最终成败结果 。委员会运用贝叶斯法则更新对委托人能力的后验信念,并将晋升奖励/未来领导权分配给期望能力更高的一方,选拔结果记为 。
2.2 技术成功率函数与信息诊断性公理
政策成功概率为 。作者对成功率函数施加了两条核心公理化假设:
(i)单调性公理:政策成功概率严格递增于委托人的能力 以及代理人的协助决策 。即:高能力和全力协助均能提高胜率。
(ii)单调似然比与信息诊断性公理(Informativeness Condition):
① 失败在代理人“协助”下更具信息诊断性(Failure Informativeness):似然比 关于协助决策 弱递增。即:在下属全力协助下如果依然遭遇惨败,这极大程度表明领导者自身能力存在严重缺陷(Fail Big)。
② 成功在代理人“破坏”下更具信息诊断性(Success Informativeness):似然比 关于协助决策 弱递减。即:在下属严重掣肘和破坏下如果依然取得奇迹般成功,这高度确凿地证明了领导者自身具有超凡的卓越才能(Succeed Alone)。
在线附录中,作者证明该信息公理等价于要求成功率函数的对数超模性受限,即 。一个具有代表性的可加线性规范为:
其中 ,满足 。只要能力与协助之间的互补性满足 (特别地,当 即完全替代时恒成立),公理(ii)即被完美满足。
2.3 贝叶斯后验概率演化与严格排序
给定委托人先验能力 ,预期政策成功概率为:
委员会观测到执行决策 和结果 后,利用贝叶斯法则更新对委托人能力的后验概率。定义成功时的后验概率为 ,失败时的后验概率为 。具体表达式推导如下:
根据信息公理(ii),无论政策最终是成是败,代理人的“协助()”都会系统性拉低委员会对委托人能力的评估!因此,后验信念在单位区间 上构成了严格的五段序位关系(论文公式 1):
2.4 【图1解析】委托人能力类型的贝叶斯更新图谱
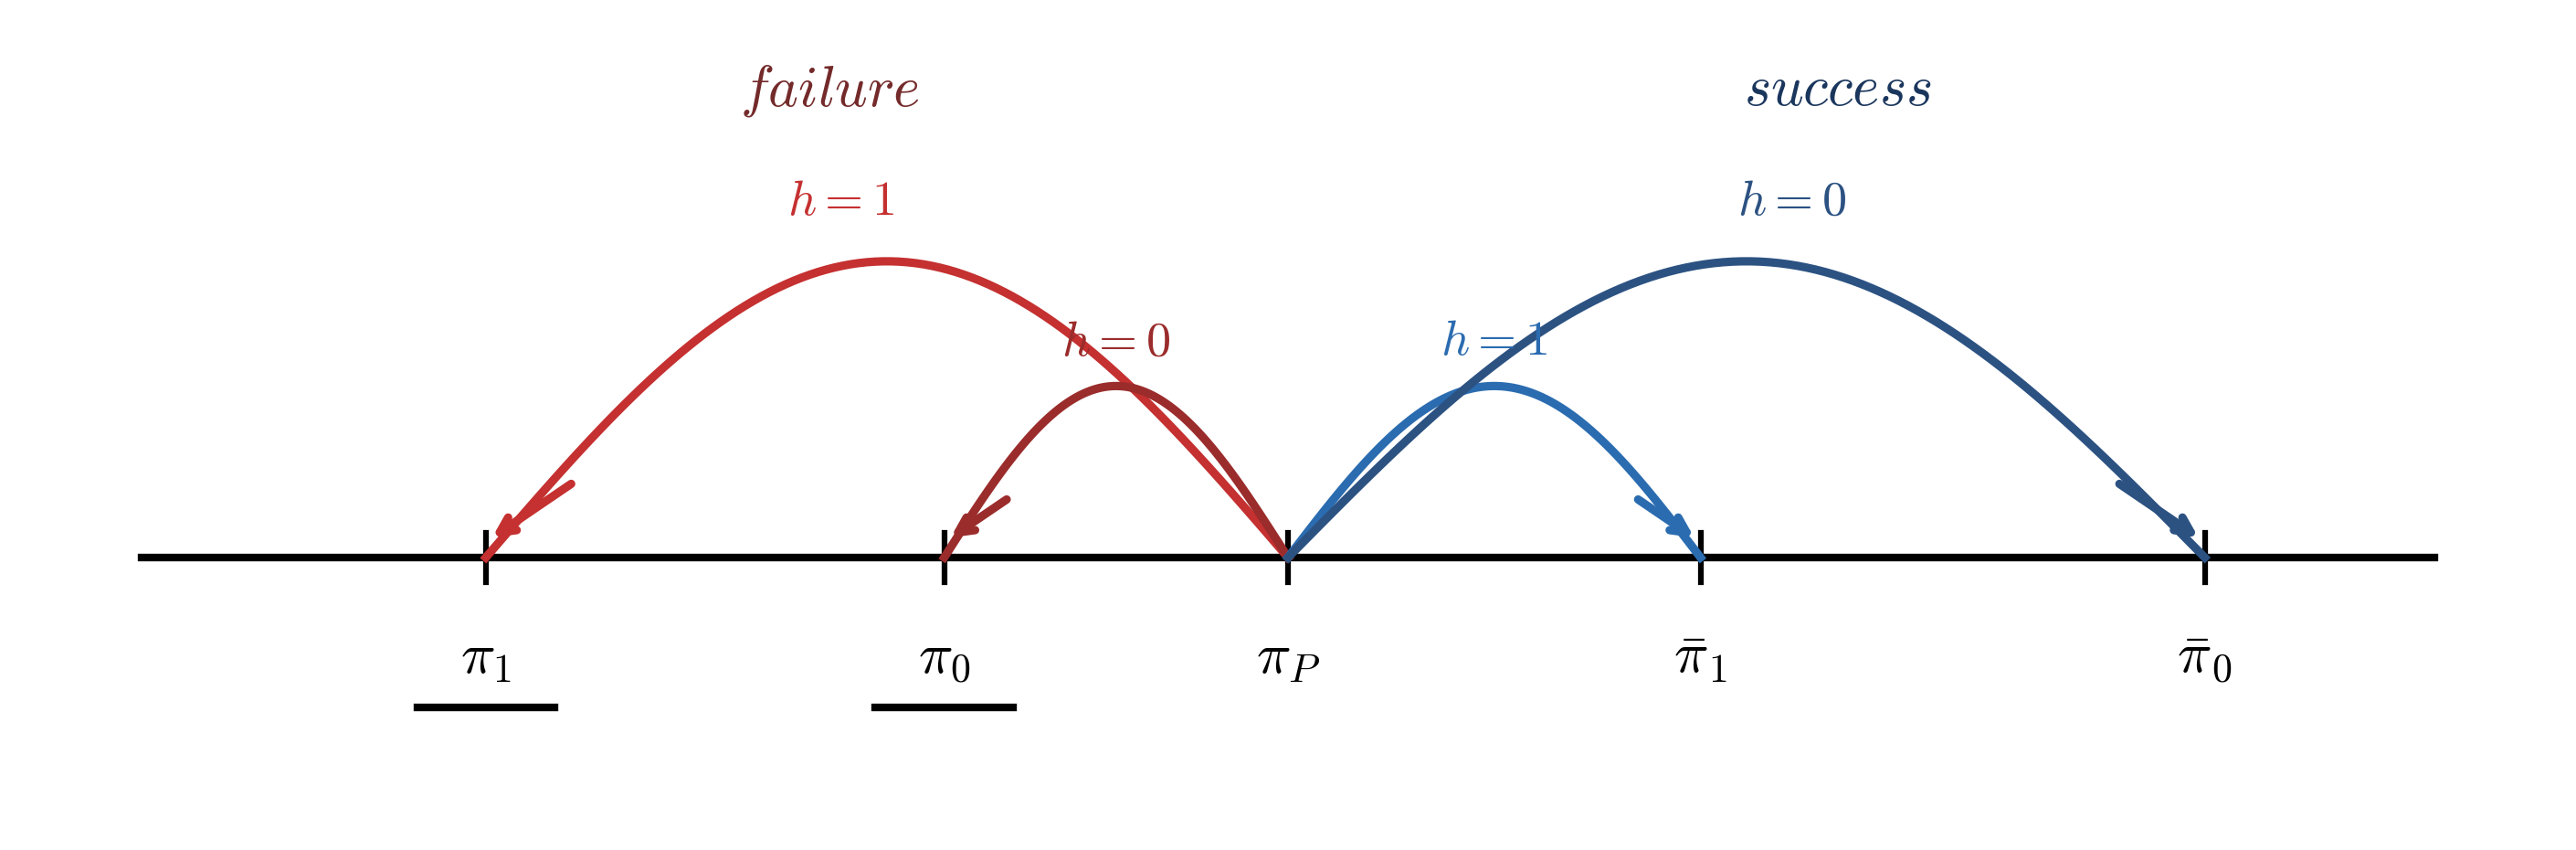
图 1:委托人能力类型的贝叶斯后验概率更新路径(Updating on the Principal's type)
【图1的数理与经济学深度图解】:
1. 失败分支(左侧红色弧线):当政策失败()时,后验信念均下降至先验 以下。若代理人协助(),后验能力大幅坠落至最低点 ;若代理人破坏(),委员会意识到失败可能源于下属掣肘,因而对委托人的惩罚较轻,后验停留在较高的 。这直观展现了代理人协助所带来的“推卸责任机制(Blame-Shifting)”——协助放大了失败对领导者能力的负面暴露。
2. 成功分支(右侧蓝色弧线):当政策成功()时,后验信念均上升至先验 以上。若代理人破坏(),委托人在逆境中取得成功,后验能力跃升至最高点 (孤胆英雄效应);若代理人协助(),功劳被下属分流,后验仅上升至相对温和的 。这直观展现了代理人协助所带来的“分担功劳机制(Credit-Sharing)”——协助稀释了成功对领导者能力的正面彰显。
2.5 报酬函数、效用结构与核心参数假定
各参与人兼具“政策偏好关切(Policy Concerns)”与“职位选拔考量(Selection Concerns)”。
• 政策执行收益:若政策失败,标准化收益为 。若政策成功,委托人与代理人的政策收益分别为:
其中 代表双方对政策成功具有共同利益的公共价值维度; 代表双方存在利益冲突的分歧维度。委托人的理想政策点为 ,而代理人的理想政策点为 。参数 衡量了双方分歧的广度。
• 选拔晋升收益:若主体 在第三阶段被委员会选拔为下一任领导人(),获得外生职位租金 。参与人 的总效用函数为:
核心理论假定汇总 (Assumptions 1 - 3) 假定 1 (Assumption 1): 。即职位的选拔奖励严格大于代理人从政策成功中获得的纯公共偏好收益。这确保了选拔考量能够对代理人的行为产生实质性战略驱动。 假定 2 (Assumption 2): 且 。即政策既存在共同利益,又存在实质性的政策分歧维度。 假定 3 (Assumption 3): 。即政策分歧上限足够大,保证委托人面临真实严峻的权衡:要么通过政策让步换取协助,要么坚持自身偏好而承受破坏。 |
|---|
三、 委员会选拔规则与引理 1 全景推导
3.1 委员会决策法则
评选委员会的目标是选拔预期能力更高的候选人。由于代理人的能力 不影响政策成败,委员会对代理人能力的评估恒等于先验概率 。委员会在观测到政策结果及代理人决策后,更新对委托人的后验概率 。选拔规则为:若 ,选拔委托人();若 ,选拔代理人();平局时按固定概率破平。
引理 1 (Lemma 1): 委员会选拔决策区间的全景分类 (i) 极端分离区间 (Far Enough): 若 或 ,委员会选拔完全独立于政策结果: (a) 当 时,委员会始终选拔委托人 (); (b) 当 时,委员会从不选拔委托人 (始终选 )。 (ii) 势均力敌区间 (Close Enough): 若 ,委员会选拔完全取决于政策成败:当且仅当政策成功时选拔委托人 ()。 (iii) 中度竞争区间 (Intermediate): 选拔同时取决于政策结果与代理人的执行决策: (a) 若 ,委员会选拔委托人,除非政策在代理人协助下依然失败 (即仅在 重大失败时选 A); (b) 若 ,委员会仅在政策遭代理人破坏却依然成功时才选拔委托人 (即仅在 孤胆成功时选 P)。 |
|---|
3.2 【图2解析】基于先验能力的委员会选拔边界
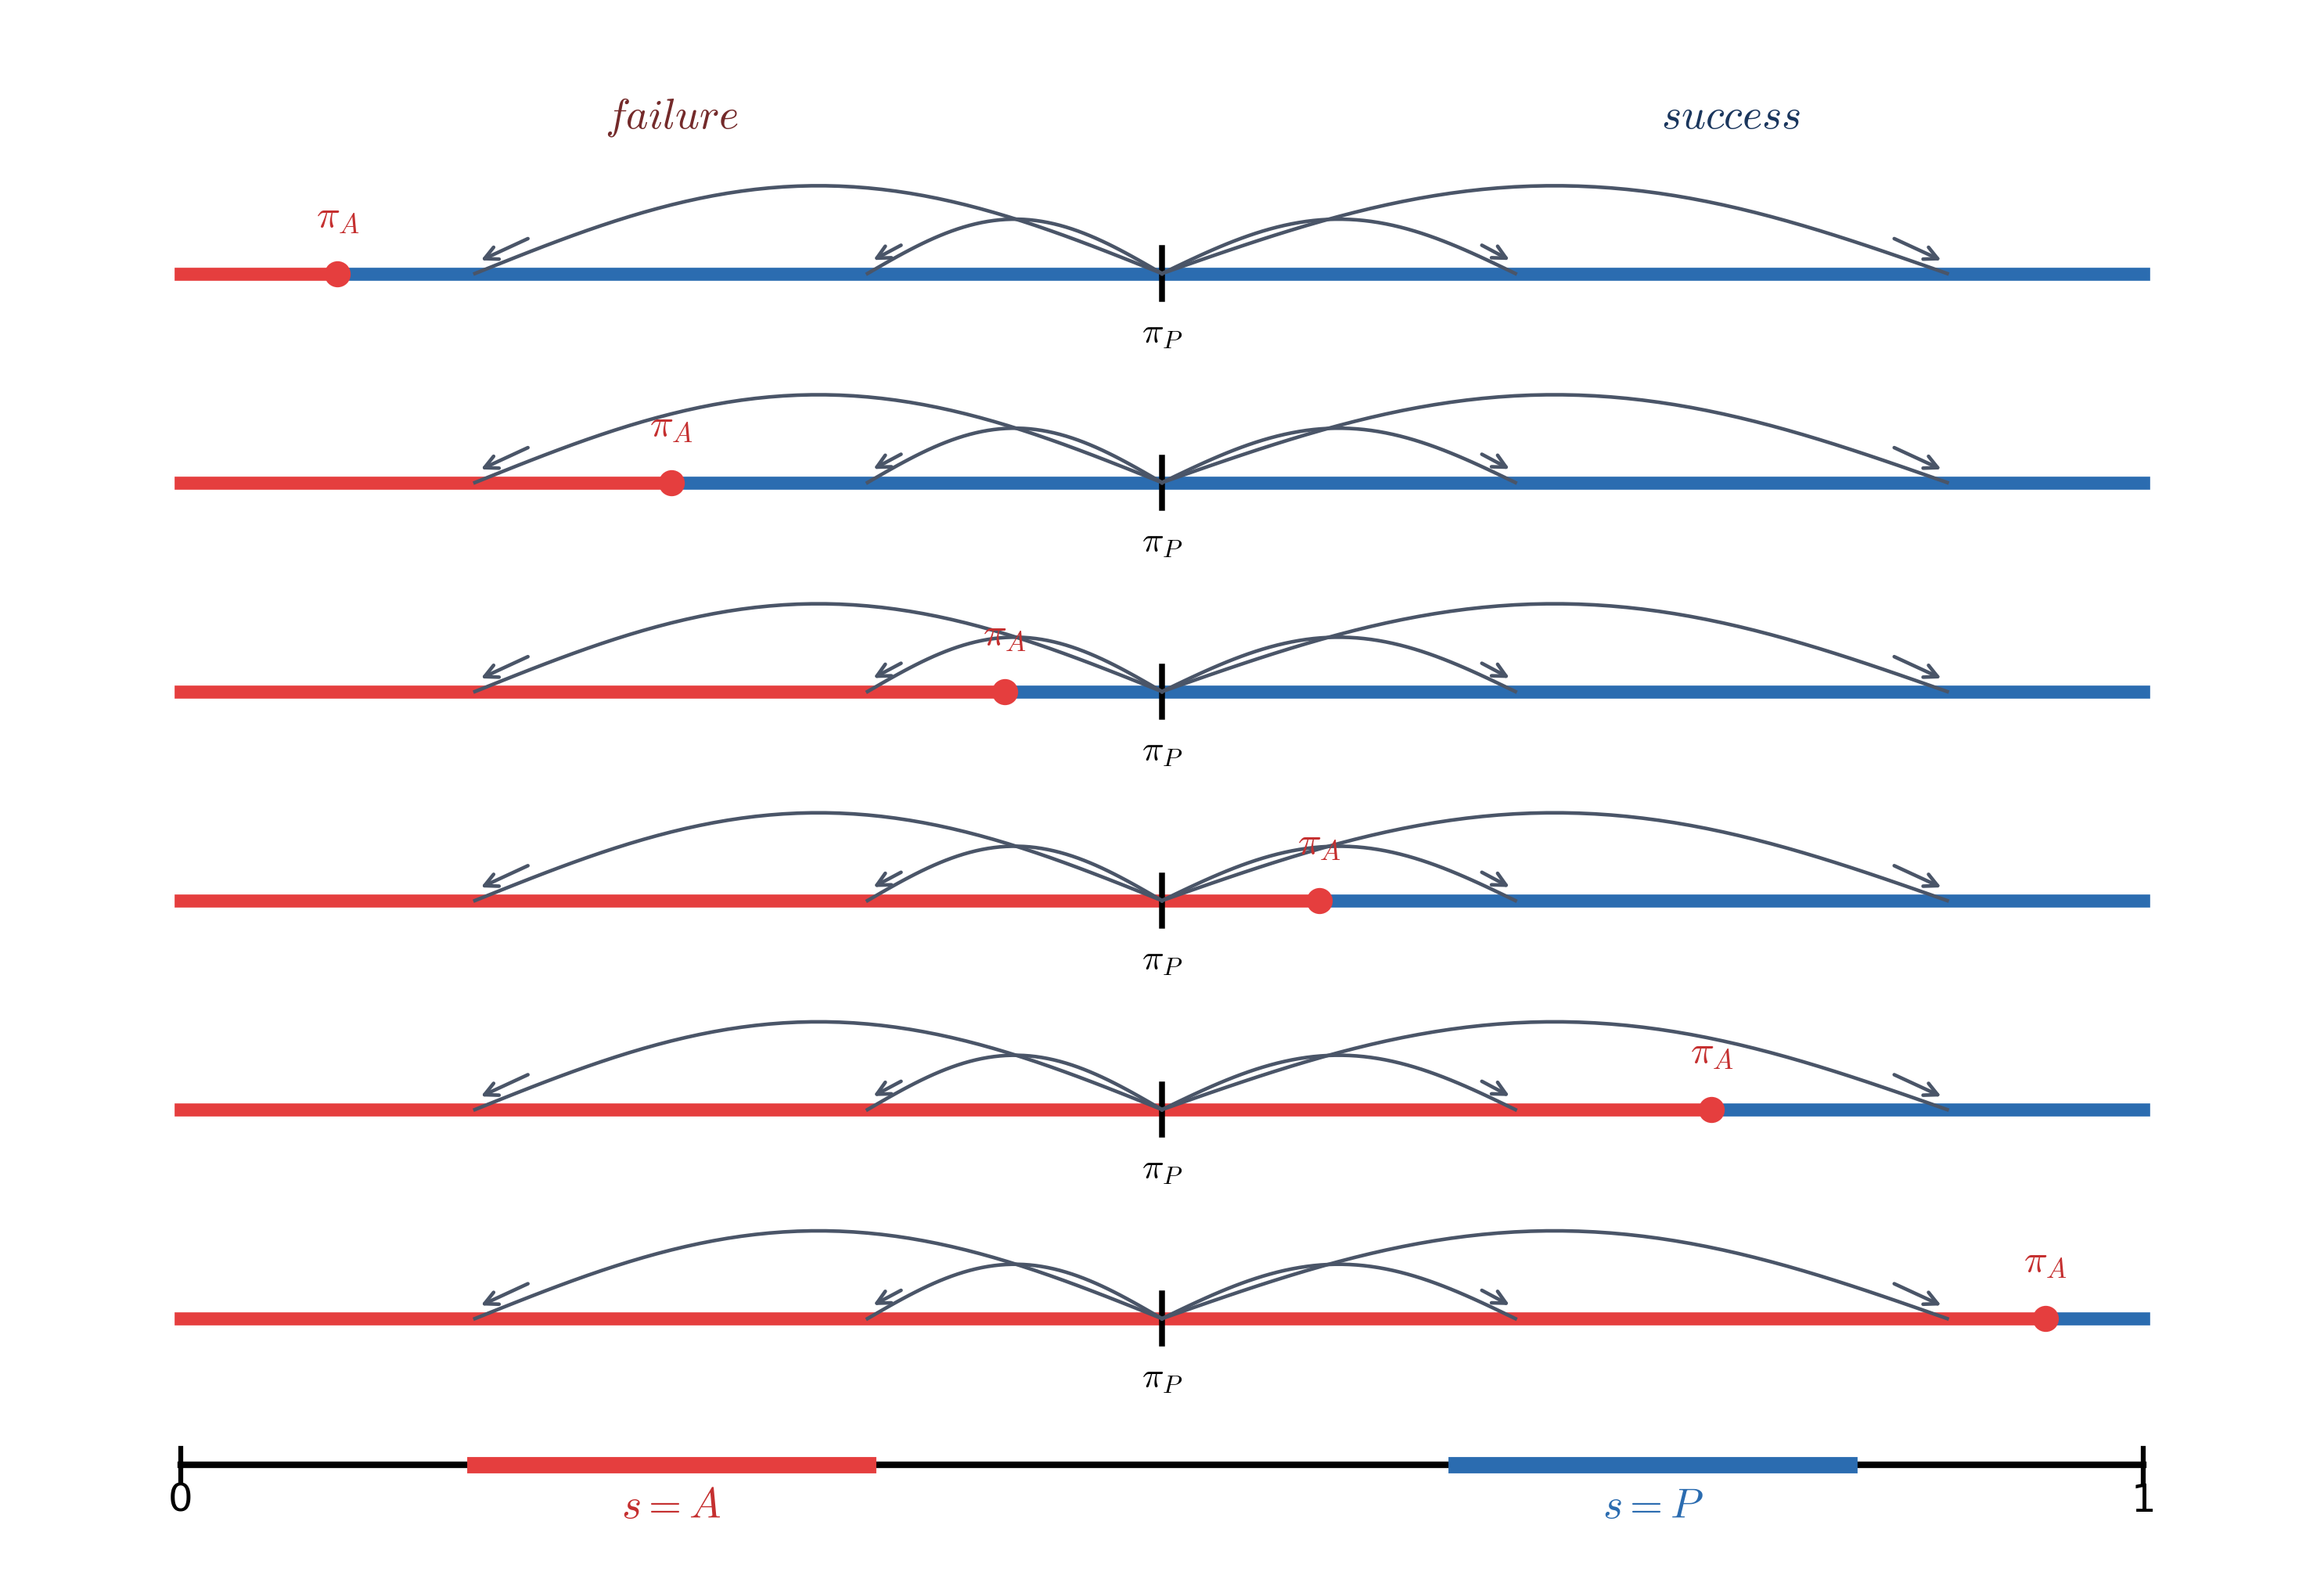
图 2:给定委托人与代理人先验能力下的委员会选拔决策全景(Committee's selection decision)
【图2的几何构造与选拔逻辑】:
图2从上至下展示了代理人先验能力 处于6个不同区间时,后验信念与选拔结果的对照关系。红色粗线区间代表后验能力低于 (选拔代理人 ),深蓝色粗线区间代表后验能力高于 (选拔委托人 )。
引理1清晰地划分了代理人面临的战略博弈环境:在情况(i)中,不存在选拔博弈,代理人纯粹基于政策偏好行动;在情况(ii)中,失败无论如何都导致代理人上位,因而代理人具有极强的暗中破坏冲动;而在情况(iii)的两个中间区域,代理人行动 成为左右委员会判断的关键杠杆,这为通过选拔考量激励合作奠定了数理基石。
四、政策偏好一致基准(x̄ = 0):命题 1 与推论 1 深度推导
4.1 命题 1 的数理推导与均衡表述
当 时,政策分歧消失,双方政策偏好完全一致:。代理人只需比较选择协助()与破坏()下的期望效用 。在引理1划分的各个先验区间中,数理推导如下:
• 区间 1:。委员会始终选拔委托人,代理人无法获得职位奖励 。
因此,当且仅当 时,代理人选择协助 。
• 区间 2:。若协助(),重大失败时代理人被选拔获得 ;若破坏(),委员会始终选拔委托人。
令差值大于等于0,解得协助条件为 :
• 区间 3:。政策成功选委托人,失败选代理人。
由假定 1(),可知 恒成立。因此代理人必然选择破坏 。
• 区间 4:。若协助(),代理人始终上位获得 ;若破坏(),仅在成功时委托人上位。
令差值大于等于0,解得协助条件为 :
• 区间 5:。代理人始终上位,选拔收益在协助与破坏下均为 ,协助条件退化为 。
命题 1 (Proposition 1): 偏好一致下的完美贝叶斯均衡 几乎处处存在唯一的纯策略完美贝叶斯均衡: (i) 若 ,当且仅当 时 ;委员会始终选拔委托人; (ii) 若 ,当且仅当 时 ;若 ,成则选P败则选A;若 ,始终选P; (iii) 若 ,必有 ,且成则选P败则选A; (iv) 若 ,当且仅当 时 ;若 ,始终选A;若 ,成则选P败则选A; (v) 若 ,当且仅当 时 ;委员会始终选拔代理人。 |
|---|
4.2 推论 1:锦标赛激励反转效应
对临界阈值 和 关于职位奖金 求偏导数:
推论 1 (Corollary 1): 协助阈值对职位奖金的单调递减性 临界阈值 与 严格递减于职位奖金 。即:增大职位奖金 ,使阈值变得更加负,从而严格扩大了代理人选择协助执行的参数空间! |
|---|
【推论1的经济学意义】:在 Lazear (1989) 奠定的经典锦标赛理论中,增加奖金差距必然加剧破坏。但本文证明,在贝叶斯学习环境下,奖金 赋予了代理人强烈的声誉动机——协助能使代理人在失败时成功转嫁责任( 机制),或在成功时稀释对手光环( 机制)。即使某项政策会给代理人带来负的内在收益(),为了追求更大的晋升奖励 ,代理人也会积极支持并协助推进该政策!
五、政策偏好分歧拓展(x̄ > 0):结果 1–3 与命题 2 深度推导
5.1 结果 1:势均力敌下的无法妥协困境
在区间 内,对于任意政策 ,代理人的协助与破坏效用差为:
因为 且 (假定 1),上式恒严格小于0。这意味着委托人无论做出多大的政策妥协(即便令 达到代理人理想点),也无法换取代理人的协助。委托人理性地放弃妥协,直接设定自身最偏好的政策 ,均衡中必然遭受破坏 。
结果 1 (Result 1): 无法妥协区间 若 ,不存在任何能诱导协助的政策妥协。委托人最优策略为 ,代理人均衡破坏 。 |
|---|
5.2 结果 2:无选拔考量下的政策让步权衡
当 或 时,选拔结果与政策成败无关。代理人协助条件简化为:
委托人偏好更大的 ,因此能换取协助的最优让步政策为边界点 。委托人权衡如下两项选择:
• 选择妥协 换取协助 :委托人期望政策收益为 ;
• 坚持自我 承受破坏 :委托人期望政策收益为 。
结果 2 (Result 2): 无选拔考量下的让步决策 若 或 ,当且仅当 时,委托人妥协选择 且 ;否则选择 且 。 |
|---|
5.3 结果 3:撬动选拔考量的战略性让步
在存在选拔互动的中间区间,委托人可以利用代理人的选拔野心,以更小的让步幅度换取协助:
(i)推卸责任区间():代理人协助条件为 。解得诱导协助的最优政策为:
此时委托人只需做出较小让步( 更加偏向委托人)。委托人权衡 与 的期望效用:
(ii)分担功劳区间():代理人协助条件为 。解得诱导协助的最优政策为:
委托人权衡 与 的期望效用:
结果 3 (Result 3): 撬动选拔考量的政策均衡 (i) 若 ,当且仅当 时, 且 ;否则 且 ; (ii) 若 ,当且仅当 时, 且 ;否则 且 。 |
|---|
5.4 命题 2 的严格数理证明与机制剖析
委托人撬动代理人的选拔考量虽然能减少政策让步,但代价是自身被选拔的概率下降。命题2给出了极为深刻的结论:
命题 2 (Proposition 2): 撬动选拔考量的绝对比较优势 对于任意给定的委托人 :若委托人在无法撬动选拔考量时( 或 )弱偏好于获取协助;则在能够撬动选拔考量时( 或 ),委托人严格偏好于获取协助! |
|---|
【命题2的严格代数推导】:
定义无选拔考量下获取协助的净效用增益为 。设 。
1. 计算在区间 下获取协助的净增益 :
将 代入上式展开并整理:
由于 且 ,附加项 恒严格为正!因此 。
2. 计算在区间 下获取协助的净增益 :
同理,附加项 恒严格为正!因此 。
【核心经济机制解析】:为什么委托人在选拔考量下的获利能力更强?关键在于政策让步与选拔激励在结构上的根本不对称性!因为政策即使在破坏下也有 的概率成功,纯粹的政策让步使得代理人在协助和破坏时均能享受更大的政策果实(让步激励发生双向外溢,具有死重损失);然而,选拔考量产生的胜率提升是严格以协助为条件(Contingent Incentive)的——代理人只有真正提供协助,才能改写委员会的后验评价体系。这一条件性激励消除了激励泄漏,使委托人获取协助的成本显著降低!
六、 次优选才(Mediocracy)与效用非单调性:命题 3 全景推导
6.1 命题 3 的数理表述与证明
当委托人面对潜在的下属候选人池 时,其期望效用函数 如何随 变化?
命题 3 (Proposition 3): 次优选才定理与效用非单调性 考虑先验能力为 的委托人与候选代理人 的博弈: 1. 委托人的期望效用在能够撬动选拔考量的平庸区间 达到全局最大值; 2. 对于任意分歧度 ( 为全破坏截断阈值),委托人的期望效用关于 是非单调的。 |
|---|
【命题3的数理证明】:
我们分段考察委托人的均衡期望效用:
• 若 (极弱下属):委托人即便获得协助,效用为 。
• 若 (平庸下属):委托人撬动推卸责任动机,效用为 。
对比可知,平庸区间效用严格高于极弱区间,净高出 !
• 若 (强势潜在接班人):代理人必然掣肘破坏,委托人效用跌落至低谷 。
因此,委托人效用先在平庸区间达到顶峰,随后在势均力敌区间断崖式暴跌,呈现鲜明的非单调倒 U 型 / 阶梯震荡特征。
6.2 【图3解析】委托人期望效用数值模拟双图
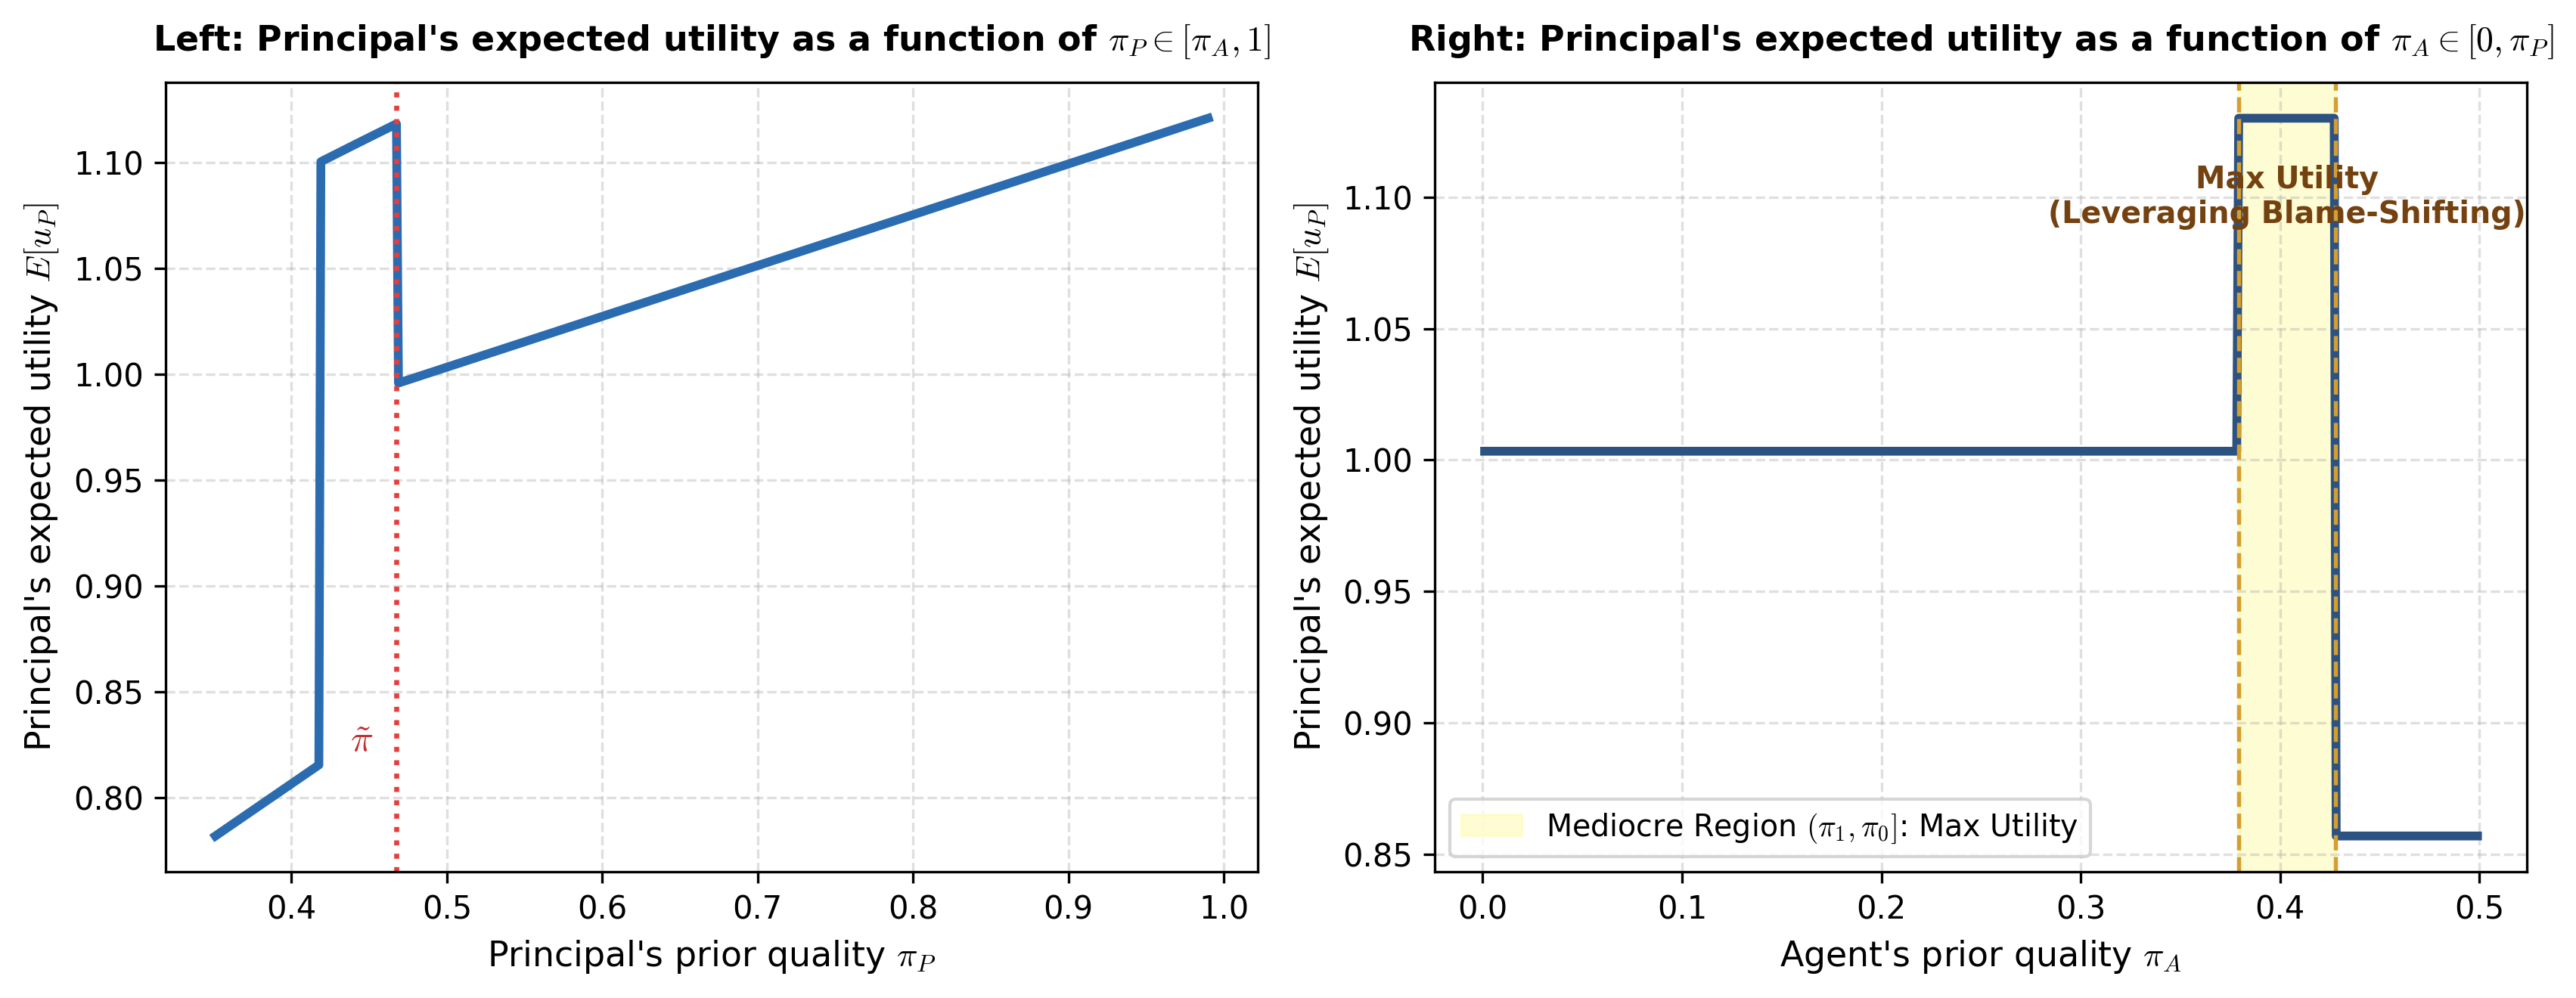
图 3:委托人期望效用数值模拟(左图:随自身能力 $\pi_P$ 变化;右图:随代理人能力 $\pi_A$ 变化)
【图3的数值参数与经济学深度图解】:
设定参数:。
• 右图分析(下属选拔视角):当领导者从 中挑选搭档时,既不会挑选能力逼近自己的高威胁者(,导致严重内耗破坏),也不会挑选能力极差的庸才(,缺乏杠杆筹码),而是精确选择落入黄色高亮“平庸区间 ”的下属。这类下属唯有在领导者重大失败时才有机会被提拔,因而具有最强烈的动机去全力协助以转嫁失败风险,使领导者获取最大化效用。
• 左图分析(自身能力视角):委托人自身能力 提升虽然总体上有利,但在机制转换点 处会出现异常的断崖式跌落。原因在于当自身能力跨过临界值后,选拔格局发生跃迁,委托人无法再利用下属的推卸责任动机,必须退回到纯粹依靠大幅政策让步的低效状态。
七、 全文结论总结与制度启示
7.1 全文理论核心要点回顾
本文通过内生化信息披露结构与政策议程设置,解构了组织内部序位竞争与协作之间的复杂互动:
1. 竞争并不必然导致暗中破坏。当代理人意识到其协助行为能够内生改写评选委员会对领导者能力的归因逻辑时,协助成为分担功劳与推卸责任的理性选择。
2. 拥有议程设置权的领导者能够将下属的晋升野心转化为政策红利,通过微小让步达成高效协助。
3. 组织内部的“平庸任用(Mediocracy)”并非仅仅源于领导者的自私嫉妒,而是在特定信息归因结构下实现跨期协作激励的内生均衡结果。
7.2 企业管理与公司治理启示
【启示一:高管团队梯队搭建】 (1)重构高管接班人计划与关键岗位配置。企业在设立“联席CEO”或选拔“潜在接班人(Heir Apparent)”时,若二者能力与声望过于接近,极易诱发严重的执行层阻滞与政治内耗。董事会应当认识到,搭配具有一定声誉差距、但具备执行能力的副职,更有利于重大转型战略的平稳落地。
【启示二:项目复盘与责任归因机制】 (2)考核机制与失败归因的解耦设计。董事会在评估失败项目时,若简单将失败全盘归咎于项目主导者,实际上是在为协助者创造“推卸责任”的博弈筹码;而如果能够更精准地审计执行过程中的实际贡献,就能防止代理人利用制度漏洞进行策略性配合。
7.3 政治经济学与公共治理启示
【启示三:跨层级府际博弈】 (1)跨层级政府间的法案合作与财政博弈。中央与地方、州长与市长在推行区域发展或社会保障政策时,政策内容的分歧往往交织着未来选举的选拔考量。处于强势地位的领导者可以通过定制法案利益点,巧妙引导潜在政治对手从“抵制者”转变为“共同背书者”。
【启示四:内阁合作与派系整合】 (2)多党联合政府与内阁部长任用逻辑。在议会制国家的联合政府中,首相往往倾向于任命非核心派系的温和派成员掌控重要执行部门,利用其希望通过内阁政绩确立党内地位的诉求,换取对核心宏观议程的支持。
7.4 未来研究拓展方向
作者在结语中指出了两大极具前景的拓展方向:
第一,将模型拓展至无限期重复博弈(Infinite-horizon Dynamic Game),研究长期声誉积累如何改变委托人与代理人在生命周期各阶段的协助与破坏动态;
第二,赋予委托人解雇代理人(Firing Power)或重组团队的权力,考察解雇威胁如何与选拔考量相互交织,进一步丰富组织契约理论的内涵。
参考文献在线入口
点击按钮前往 DOI、出版社或作者公开页面。外部页面将在新窗口打开。
Delgado-Vega, Álvaro, and Benjamin Shaver. 2026. “A Model of Selection and Policy Concerns.” The Economic Journal 136(678): 2224–2238. DOI: 10.1093/ej/ueaf102.
围绕这篇论文继续讨论
您如何评价《A Model of Selection and Policy Concerns》的研究问题、模型设定或管理启示?欢迎留下观点,也可用快捷互动表达阅读感受。
读者留言
正在读取留言…