多属性定价与选择中的主观价值认知机制:
数理建模、偏好反转与深度神经网络反演全景解析
Cognitive Mechanisms of Subjective Value in Multiattribute Pricing
| 【论文作者】 | Anderson K. Fitch (University of Florida) & Peter D. Kvam (The Ohio State University) |
|---|---|
| 【发表期刊】 | Psychological Review (2026, Vol. 133, No. 4, pp. 892–918) | DOI: https://doi.org/10.1037/rev0000594 |
| 【JEL分类号】 | D81 (风险与不确定性决策准则) · D90 (微观行为经济学) · D91 (心理与认知决策) · C51 (模型构建与估计) · C45 (神经网络与模拟推断) · D11 (消费者偏好与估值) |
| 【核心关键词】 | 多属性定价 (Multiattribute Pricing) · 风险跨期选择 (Risky Intertemporal Choice) · 偏好反转 (Preference Reversals) · 漂移扩散模型 (DDM) · 极坐标累积模型 (Polar Accumulation) · 深度神经网络无似然反演 (Simulation-Based Neural Inference) |
第一章 全文核心内容摘要与论文核心贡献
1.1 全文全景概要
理解人类如何在包含多重属性(例如潜在收益金额、获得概率以及时间延迟)的经济备选方案之间赋予连续的主观价值(Subjective Value),是微观经济学、行为经济学与认知决策科学的核心基石。传统微观经济学与行为决策理论长期依赖两类截然不同的测量范式:其一是二选一离散选择(Binary Choice),其二是连续定价评估(Pricing,包括意愿支付价 WTP 与意愿接受价 WTA)。然而,半个世纪以来的实证研究反复揭示出系统的“选择-定价偏好反转”(Preference Reversals)异象——决策者在面对一对选项时,往往倾向于选择较小、较快或较安全(Smaller, Sooner, Safer)的选项,却会对较大、较晚或较具风险(Larger, Later, Riskier)的选项给出更高的保留价格。这种测量诱导的偏好分歧,对经济学中关于存在单一、稳定、跨情境一致的“主观价值”构造的公理化假设提出了严峻挑战。
发表于心理学与决策科学顶级期刊《Psychological Review》(2026年第133卷第4期)的重磅研究《Cognitive Mechanisms of Subjective Value in Multiattribute Pricing》,由学者 Anderson K. Fitch 与 Peter D. Kvam 共同撰写。本文首次在收益(Gains)与损失(Losses)全域、买入(Buying)与卖出(Selling)框架以及时间压力(Time Pressure: Precision vs. Speed)等多维实验操纵下,对同时兼具风险性(Risk)与延迟性(Delay)的多属性前景进行了极其精密的认知动态过程建模与微观行为测度。作者构建了一个基于两阶段深度神经网络(Deep Neural Network)的计算建模与无似然贝叶斯推断框架:首先,利用开关板模型比较(Switchboard Model Comparison)在个体层级甄别驱动多属性估值的核心认知机制;随后,构建个体化联合认知模型(Individualized Joint Models),同时反演各被试在选择与定价任务下的全套潜变量后验分布及其跨任务协方差。
研究表明:尽管延迟贴现(Delay Discounting)与风险规避(Risk Aversion)等基础参数在群体宏观分布上呈现出相似性,但在个体微观层面,选择模型与定价模型的主观价值参数完全解耦(Correlations near zero);选择-定价偏好反转并非源于底层价值表示的扭曲,而是由定价任务中特有的“金额尺度兼容性起始点锚定机制”(Start-Point Anchoring)与更为线性的效用函数斜率(Payoff Sensitivity)共同驱动。该研究彻底颠覆了“个体具有跨任务恒定特质化主观价值”的传统假设,为微观行为经济学与认知计量学树立了全新的理论与方法学标杆。
1.2 论文的核心理论与方法学贡献
【核心贡献总览】Anderson K. Fitch & Peter D. Kvam (2026) 论文五大里程碑贡献 **理论统一贡献(Theoretical Unification)**:首次将描述性微观经济学理论(期望效用理论、前景理论、双曲延迟贴现模型)与动态认知计算过程模型(维纳漂移扩散模型 DDM 与二维极坐标连续状态空间累积模型)在多属性框架下实现有机统一,并在数学上严格证明了动态过程模型向静态经典经济学理论的渐近收敛性。 **多属性偏好反转解构(Deconstructing Multiattribute Reversals)**:系统揭示了当选项同时包含金额、概率与延迟三重属性时,注意力稀释效应(Attentional Dilution)如何降低经典偏好反转的发生率,并证明偏好反转高度集中于“金额是唯一优势维度”的特定结构选项对中。 **计算方法学突破(Likelihood-Free Deep Learning Inversion)**:针对连续极坐标累积模型缺乏解析似然函数(Analytic Likelihood)的计算瓶颈,开发了基于预训练深度反演神经网络(Simulation-Inversion Networks)的摊销贝叶斯推断方法,结合证据深度学习(Evidential Deep Learning)实现了高效的开关板模型结构分类。 **个体化联合建模技术(Individualized Joint Cognitive Modeling)**:摒弃传统将各任务分立估计的二步法,利用 Monte Carlo Dropout 采样技术直接从联合神经网络中提取个体在选择与定价多任务下的全参数后验协方差矩阵,精确量化跨任务认知机制的关联强度与测量误差。 **行为经济学范式颠覆(Challenging the Single Construct Paradigm)**:从实验与计算双重路径证伪了“主观价值是跨诱导程序不变的独立心理实体”这一传统假说,证明冲动性(Impulsivity)与风险偏好(Risk Preferences)高度依赖于特定的信息提取与反应输出过程。 |
|---|
1.3 核心研究发现概览
【四项核心实证与理论发现】论文的核心发现可精炼归纳为以下四大支柱:
1. **定价范式系统性偏好大金额选项**:无论在收益还是损失框架下,定价任务相较于选择任务均显著放大了大金额、低概率、长延迟选项的主观价值,且在卖出(Selling/WTA)框架下这一效应尤为剧烈。
2. **偏好反转的诱发机制为锚定与效用线性化**:定价模型中估计出高度显著且呈双峰分布的起始点偏差参数(Start-point Bias ),同时定价任务下的效用幂指数 显著高于选择任务(更为接近 1.0),证实尺度兼容性导致的初始注意力锚定与高收益敏感度是偏好反转的主因。
3. **损失与卖出框架放大估值绝对量**:买入收益定价最低(均值 8.04)。该模式无法单由“所有权/禀赋效应”(Endowment Effect)解释,揭示了损失规避与责任转嫁的复合心理动力学。
4. **跨任务主观价值参数的微观零相关**:在个体化联合模型中,除极少数被试的时间贴现率存在微弱跨任务相关外,效用曲率、概率加权等核心价值参数在选择与定价任务之间完全不相关(),确证了不同诱导程序测量的是异质性的认知生成过程。
第二章 多属性主观价值数理模型建立过程详细解析
2.1 主观价值的三大微观经济构成要素
在对多属性前景进行评估时,一个完整的决策对象通常由三个核心维度界定:潜在收益或损失金额 、实现该金额的客观概率 以及从当前决策时刻到最终实现的时间延迟 。在微观经济学与认知心理学传统中,这三大属性对主观价值的贡献机制具有根本性的功能不对称性。
第一构成要素是**结果效用(Outcome Utility)** 。金额 是唯一能够独立赋予绝对价值(Independent Value)的核心主属性。依据经典的冯·诺依曼-摩根斯坦效用理论(von Neumann & Morgenstern, 1944),金额与其主观效用之间遵循幂函数(Power-law Utility Function)关系:
其中,参数 为效用曲率指数。当 时,效用函数呈现严格凹性(Concave),代表边际效用递减(Diminishing Marginal Utility)。从价值相似性(Value Similarity)的角度阐释,这意味着 2 之间的主观心理差异,显著大于 12 之间的主观差异。当 时,效用函数呈线性;当 时,呈现边际效用递增的凸性(Convex)特征。
第二构成要素是**时间延迟贴现因子(Delay Discounting Factor)** 。未来实现的结果随着等待时间 的增加而发生主观价值衰减。依据 Ainslie (1975) 与 Mazur (1987) 奠定的行为双曲贴现理论,贴现因子表述为:
其中, 为时间贴现率参数。 值越大,代表决策者对延迟越敏感、时间偏好越冲动(Impulsive)。关键的理论特性在于,时间延迟本身并不独立赋予正向或负向的绝对价值,而是作为**次级修正属性(Secondary Modifying Attribute)**对金额效用进行缩放:对于正向收益,延迟降低其吸引力();对于负向损失,延迟推迟了痛苦发生,使其主观厌恶程度减轻(变好)。
第三构成要素是**概率主观权重(Subjective Probability Weight)** 。风险结果发生的不确定性通过概率加权函数对效用产生调节作用。依据前景理论(Prospect Theory; Kahneman & Tversky, 1979)与 Prelec (1998) 的公理化概率加权形式:
其中, 控制概率加权曲线的曲率。当 时,函数呈现经典的倒 S 型(Inverse S-shaped),表现为高估小概率事件(Overweighting rare events)而低估中高概率事件;当 时,呈现 S 型;当 时退化为客观概率。在收益情境下, 意味着更强的风险寻求倾向,而在损失情境下,较小的 值则加剧了对小概率极端巨额损失的恐慌,对应风险规避行为。
三大属性的**多属性综合价值(Overall Subjective Value)**结合机制:由于金额独立赋予价值,而延迟与概率仅作为乘法缩放调节子,因此对于包含可能结果集 的复合前景,其总体主观价值 遵循严格的**乘法结合律(Multiplicative Concatenation)**:
该乘法形式成功克服了加法模型(如 Killeen, 2009 将延迟和风险的负效用从金额效用中直接相减)在处理损失情境时出现的逻辑悖论(即加法模型无法解释为何延迟会让一笔惩罚/损失变得主观上更不难受)。
2.2 二选一决策的动态认知过程模型
在二选一选择任务中(例如在选项 A: 与选项 B: 之间做出决断),决策者并不是瞬间做出反应,而是通过对各选项可能结果的反复心理模拟(Mental Simulation)来持续累积支持某一选项的认知证据。作者构建了一个基于决策场理论(Decision Field Theory; Busemeyer & Townsend, 1993)与标准漂移扩散模型(Drift Diffusion Model, DDM; Ratcliff et al., 2016)的动态认知过程模型。
该模型的证据累积状态 遵循连续时间维纳扩散过程(Wiener Diffusion Process):
其中, 为标准布朗运动, 为试次内扩散噪声(Within-trial Stochastic Noise)。决策状态从初始原点 出发,当 向上越过上阈值 时触发对选项 A 的选择;当向下越过下阈值 时触发对选项 B 的选择。
模型的漂移率(Drift Rate) 决定了证据累积的宏观方向与平均速度。作者采用**备选方案驱动模型(Alternative-Wise Comparison Mechanism)**:决策者首先独立计算选项 A 与选项 B 的总体多属性主观价值 与 ,随后以两者之差作为漂移率的核心驱动力,并叠加试次间漂移率变异性(Between-trial Drift Variability)以捕捉认知疲劳或注意力波动:
其中, 为均值为零、标准差为 的正态分布随机变量。若 ,证据倾向于向上累积支持选项 A;若 ,则倾向于选择选项 B。当 时,两选项处于主观无差异点(Indifference Point),选择概率各为 50%。
整个决策过程的反应时间(Response Time, RT)由认知累积步数 与非决策时间 共同决定:
其中,每个离散微观模拟步长平均耗时 ,步数 服从伽马分布 ,非决策时间 吸收了视觉刺激编码、肌肉运动执行等外围过程。
为了严谨论证为何采用备选方案驱动(Alternative-Wise)而非属性驱动(Attribute-Wise)模型,作者引入了竞争性的**直接差分模型(Direct Difference Model, DDM; Dai & Busemeyer, 2014)**进行神经网络分类器甄别。在属性差分模型中,漂移率由金额差、概率差与时间延迟差的加权和决定:
分类神经网络在 100,000 套合成数据集上达到了 99.91% 的分类准确率;在对 10 位被试的 20 套实证数据集进行分类时,有 19 套数据以极高后验概率()明确支持备选方案比较机制,无可辩驳地确立了 Alternative-Wise 模型的优越地位。
2.3 连续定价决策的二维极坐标状态空间累积模型
与二选一选择不同,定价任务要求决策者在连续区间 20]$ 内输出一个精确的保留价格。由于定价任务不存在对比选项,属性差分模型在理论上完全失效。作者引入并拓展了 Kvam & Busemeyer (2020) 创立的**二维极坐标连续状态空间证据累积模型(2D Polar State-Space Continuous Accumulation Model)**。
如图 4 所示,决策状态被映射在一个以原点为中心的二维第一象限极坐标平面内,其决策边界为半径为 的四分之一圆弧:水平轴(极角 )对应最低锚点(\theta = \pi/220,即最大可能金额立即无风险实现的极限价值)。在任何时刻 ,累积状态的极角 精确表征了当前倾向的保留价格比例。
【定价动力学机制】定价过程包含两大核心动力学阶段:
1. **起始点锚定阶段(Start-Point Anchoring)**:在刺激呈现初始,由于金额属性与价格响应在物理尺度上具有天然的度量兼容性(Scale Compatibility),决策者的注意力首先被前景的金额 所俘获,产生初始锚定。起始点在极坐标系中的半径 服从均匀分布:
其中, 为**起始点偏差强度(Bias Strength)**。起始点在笛卡尔坐标系中的空间位置表示为:
若 ,意味着累积过程平均从四分之一阈值距离处开始启动。锚定强度越大,金额属性对最终报价的影响力越强,而延迟与风险的折价效应被相对稀释。
2. **心理模拟序贯累积阶段(Sequential Mental Simulation)**:在脱离初始锚定后,决策者通过心理模拟评估风险与等待。在每一个离散微观时间步长(平均 30 ms),状态转移遵循二项伯努利概率分布:
以概率 ,决策者在头脑中成功构想“在当下立即获得全部金额”,累积状态向金额对应的极角方向推进一步;以概率 ,决策者构想到“遭遇失败未能获得,或者漫长等待带来的痛苦”,累积状态向低锚点 \theta_{\text{price}}$,其碰撞点所对应的极角即转换为输出价格。
定价反应时间分布由碰撞步数 及反应时间形态调节参数(RT Shaping Parameter) 共同决定:
其中, 拉平反应时间分布以匹配实证长尾, 使分布更为尖锐。实证估计表明 ,意味着人类心理模拟的基频约为 。此外,效用幂指数 决定了不同金额在极坐标圆弧上的非线性角距离压缩,从而完整刻画了价值敏感度。
2.4 动态认知过程模型向经典静态微观经济理论的渐近收敛性证明
本文构建的认知过程模型并非与微观经济学割裂,而是在数学上将经典静态模型作为其极限特例完整包含(Subsumption)。
对于选择模型,当扩散过程单步终止()或试次间与试次内噪声趋于零()时,随机效用差分的积累退化为静态前景价值之差,选择概率严格收敛于基于逻辑斯蒂规则(Logistic Choice Rule)的确定性效用最大化模型:
对于连续定价模型,当决策阈值趋于无穷大()且锚定半径相对于阈值的比例趋于零()时,初始锚定偏差被无限步的心理模拟完全稀释。由大数定律,步进向量的期望方向严格等于转移概率 乘以金额效用角,终端平均价格期望值严格收敛于静态微观经济学主观价值:
这一渐近收敛性在数学上架起了认知过程动态学与经典微观经济学静态估值理论之间坚固的理论桥梁。
第三章 核心理论命题数理推导、证明与经济认知学意义
3.1 命题 1:多属性价值乘法结合律与效用修正机制
命题 1 (Multiplicative Interaction & Valuation Dynamics). 【命题表述】对于任意多属性前景 ,主属性金额效用 与次级属性贴现因子 及概率权重 满足严格乘法可分结合律 。在收益情境()下,,且对 严格单调递减、对 严格单调递增;在损失情境()下, 且绝对值对 严格单调递减、对 严格单调递增,即延迟使损失主观痛苦减轻,概率降低使损失主观风险缓解。
证明:【数理推导与证明】
考查综合价值函数 对各属性的一阶偏导数:
对于收益情境, 且 ,由于 ,故 ,主观价值随延迟递减。
对于损失情境,令负金额效用为 ,则总效用为 。其对延迟 的导数为:
导数大于零表明损失的主观负效用绝对值 随时间延迟而收缩(即损失被推迟后变得“没那么糟糕”)。同理,对概率 求导:
因而 (收益价值随概率增加)且 (损失风险随发生概率增加而加剧)。证毕。
【经济与认知学意义】命题 1 在数理上证明了乘法结合律不仅能无缝兼容经典正收益的风险贴现,而且自洽地解释了行为经济学中的“符号效应”(Sign Effect)——即人类在评估负面事件时,延迟和不确定性自然充当了缓冲机制,使得加法模型中必须人为引入的负效用修正项在乘法框架下得以自然内生化。
3.2 命题 2:备选方案驱动的漂移扩散决策与无差异点漂移条件
命题 2 (Alternative-Wise DDM & Indifference Equivalence). 【命题表述】在二选一任务中,决策状态 服从维纳扩散过程。设上边界为 ,下边界为 。当决策者处于无差异点(即 )时,平均漂移率 ,选择概率为精确对称的 ;当 时,选择选项 A 的闭式累积概率由两极边界吸收概率公式严格给出,且平均反应时间与主观价值差绝对值 呈严格反比关系。
证明:【数理推导与证明】
考查一维布朗运动 从 出发到达吸收边界 的第一到达时间(First Passage Time)问题。由鞅论与柯尔莫哥洛夫后向方程(Kolmogorov Backward Equation),在给定漂移率 条件下,触及上边界 的条件概率为:
当两选项主观价值完全相等时,。对无偏漂移率积分:
进一步,平均决策时间 满足:
当 时,利用洛必达法则,平均决策时间达到极大值 ;当 时,平均决策时间以 的速度单调递减。证毕。
【经济与认知学意义】命题 2 从数理上将微观经济学的“无差异曲线”(Indifference Curve)映射为认知心理学中的“最大决策潜伏期与最大不确定性状态”。它表明主观价值差异不仅决定了选择份额,而且直接内生决定了反应时间分布,使模型能够同时利用选择率与反应时间双重约束反演底层经济偏好。
3.3 命题 3:极坐标动态累积定价模型稳态期望价值与角度映射
命题 3 (Polar Accumulation Expected Trajectory & Angle Mapping). 【命题表述】在二维极坐标累积定价模型中,累积向量每一步以转移概率 沿金额角 步进,以 沿低锚点角 步进。设初始锚定半径为 ,当累积步数 触及四分之一圆阈值时,终端碰撞角 的期望值由初始锚定角与稳态漂移角的加权凸组合决定。
证明:【数理推导与证明】
在二维笛卡尔空间中,单步增量向量 的期望值为:
展开为坐标分量:
在经过 步后,累积状态坐标向量为 。其极限方向角正切值为:
将最终角度 经由反余弦/反正切变换回价格标尺,即得到连续定价预测。证毕。
【经济与认知学意义】命题 3 揭示了定价行为的核心数学机制:保留价格的生成是初始金额锚定向量(由参数 调制)与长程属性加权流(由概率与延迟调制)在二维空间中的向量合成。这精巧地解释了为何在不同反应时间下,定价会表现出对金额不同程度的过度敏感。
3.4 命题 4:动态序贯采样过程对静态微观经济理论的渐近收敛性定理
命题 4 (Dual Asymptotic Convergence Theorem). 【命题表述】(1) 当选择模型的决策噪声方差 且 时,二值选择的动态 DDM 严格收敛于确定性前景理论效用比较;(2) 当定价模型的决策阈值 且初始锚定比例固定时,极坐标动态累积定价模型的期望价格严格收敛于静态前景理论与双曲贴现综合价值 。
证明:【数理推导与证明】
考查定价模型在 时的极限性质。由于步长 固定,到达阈值所需的步数 ,且 。因此,初始状态 的相对影响按 衰减。
因此,极限极角满足:
在小角度与线性映射逼近下,有效投影价值比例等于 。恢复至价格空间即得 。证毕。
【经济与认知学意义】命题 4 从数学上证明了认知过程模型并不是对微观经济学公理化价值理论的否定,而是其在有限理性、时间压力与有限认知容量约束下的**微观动力学广义泛化(Dynamic Generalization)**。
3.5 命题 5:尺度兼容性锚定效应与效用线性化驱动选择-定价偏好反转定理
命题 5 (Mechanism of Multiattribute Preference Reversals). 【命题表述】设前景 为大金额、低概率、长延迟选项,前景 为小金额、高概率、短延迟选项,满足 ,,。在选择任务中,;而在定价任务中,只要存在起始点锚定 且定价效用指数 ,则必然存在参数区间使得 ,从而系统性产生选择-定价偏好反转。
证明:【数理推导与证明】
在选择任务中,无锚定偏差且效用曲率较低(),概率差 与时间贴现优势 主导漂移率,导致:
而在定价任务中,预期报价 是初始锚定金额项与折价累积项的凸组合:
其中 随锚定强度 严格单调递增。对两选项价格作差:
由于 且 显著高于选择效用指数,第一项 为强正值。当 时,正向金额锚定强力压倒负向属性差,使得 。证毕。
【经济与认知学意义】命题 5 在数理上终结了关于偏好反转成因的长达半个世纪的争论(即究竟是出在“价值表示改变”还是“反应模式差异”)。证明表明,偏好反转并非单一因素所致,而是**反应诱导的尺度兼容性锚定()**与**定价情境下的高边际效用敏感度()**共同构成的双重认知放大器。
3.6 命题 6:似然无偏深度神经网络反演与个体贝叶斯联合后验协方差可识别性定理
命题 6 (Deep Amortized Inversion & Joint Posterior Identifiability). 【命题表述】设认知生成模型参数空间为 ,实验数据观测空间为 。通过在大规模合成先验数据对 上预训练反演深度神经网络 ,并引入 Monte Carlo Dropout 层,网络输出的经验均值与协方差矩阵渐近一致地收敛于真实的贝叶斯联合后验分布 ,使得跨任务潜参数协方差 在无解析似然条件下具备严格统计可识别性。
证明:【数理推导与证明】
依据 Gal & Ghahramani (2016) 的贝叶斯深度学习理论,带有 Dropout 比率 的深度神经网络在最小化均方误差损失函数时:
等价于对高斯过程(Gaussian Process)后验分布的变分推断(Variational Inference)。对任意观测数据 ,在测试阶段执行 次带有随机 Dropout 掩码的前向传播 ,后验协方差估计量为:
由大数定律与变分边界紧致性,当隐层神经元宽度 且采样数 时, 依概率收敛于真实潜参数后验协方差矩阵。证毕。
【经济与认知学意义】命题 6 为复杂动态认知模型的结构估计提供了革命性的计量经济学工具,使得在没有解析似然函数的极其复杂的行为经济学模型中,能够精确估计多任务之间的潜变量协方差结构与测量误差。
第四章 实验设计、实验流程与行为实证结果深度解析
4.1 实验设计全景:2×2×2 全因子小样本密集测量范式
为系统解构多属性主观价值在不同情境下的认知生成机制,作者设计了一套严谨的组内全因子(Within-Subjects Full Factorial)实验。研究招募了 10 名健康被试(男女各占 50%,年龄 18–34 岁),每位被试在 4 周时间内完成 4 次独立的实验测试(每次间隔约 1 至 2 周),单次测试时长约 60 分钟。
这种小样本密集测量设计(Small-N Design; Smith & Little, 2018)具有极高的统计功效:每位被试在 4 次测试中总计完成 1,000 个决策试次(每次测试 250 试次),全样本累计贡献 10,000 个高精度试次数据。每个被试均被视为独立的个案研究,使得模型能够在个体微观层面上精确定位参数漂移并严谨检验跨周期的重测信度(Test-Retest Reliability)。
【三维全因子实验操纵】实验操纵的三大核心维度包括:
1. **价值效价维度(Valence: Gains vs. Losses)**:在收益会话(Gain Session)中,所有前景代表获得确定金钱奖励的概率;在损失会话(Loss Session)中,所有前景代表承担金钱扣除的概率。收益与损失在不同会话中交替呈现,并在被试间实施严格的平衡对抗设计。
2. **响应诱导范式(Response Modality & Price Framing)**:包含三大任务模块:(a) **二选一选择任务(Choice)**:在两个风险跨期前景中选择其一(每轮 25 对);(b) **买入定价任务(Buy / WTP)**:以购买彩票或承担负债的视角,在极坐标半圆标尺上输入愿意支付的最高买入价(每轮 50 个单项);(c) **卖出定价任务(Sell / WTA)**:以放弃资产或转让负债的视角,在半圆标尺上输入愿意接受的最低卖出价(每轮 50 个单项)。
3. **时间压力维度(Time Pressure: Precision vs. Speed)**:在**高精度模式(Precision)**下,被试拥有无限决策时间,并被要求定价精度精确到 10 美分以内;在**高速度模式(Speed)**下,施加强制反应时间死线(Choice 任务限时 3.5 秒,Pricing 任务限时 7.5 秒)。
4.2 刺激物生成规则与真实经济激励机制
实验刺激物经过严格的数理设计,涵盖全域参数空间:金额 1, \,实现概率 ,时间延迟 。为模拟现实经济决策中的环境特征,刺激物属性之间植入了微弱的真实相关性:金额与概率呈轻度负相关(,大金额伴随高风险);延迟与金额呈轻度正相关(,大金额多伴随长等待);延迟与概率呈轻度正相关()。
在二选一选择任务中,25 对刺激物被划分为四种精巧的支配结构:(1) **全属性支配(Dominated)**:某一选项在金额、概率、时间上全面占优(3 对);(2) **金额单优势支配(Payoff-Dominated)**:大金额选项在概率上更具风险且延迟更长,金额是其唯一优势(8 对);(3) **时间单优势支配(Delay-Dominated)**:小金额选项时间更短,但概率与金额均处于劣势(7 对);(4) **概率单优势支配(Probability-Dominated)**:小金额选项概率更高,但时间更晚且金额更小(7 对)。
为了确保决策具有真实的经济后果,实验引入了**基于可充值借记卡的真实延迟支付激励机制**。被试每次测试获得固定出场费(收益轮 22.46),并在测试结束后由系统随机抽取一个真实试次进行真金白银兑现。若抽中延迟奖励或延迟扣款,相应资金将在 1 至 250 天后准时转入或扣除。被试实际单次平均报酬为 10,最高 $40)。
4.3 行为实证结果深度解析
【表 1:各实验条件下大金额选项价值优势比例】表 1 列出了全样本在各实验条件下赋予大金额选项更高主观价值的平均比例:
| 响应任务 (Response) | 价值效价 (Valence) | 时间压力 (Deadline) | 偏好大金额比例 (Larger > Smaller) |
|---|---|---|---|
| Choice (选择) | Gain (收益) | Precision (精度/无死线) | 55.4% |
| Choice (选择) | Gain (收益) | Speed (速度/限时3.5s) | 55.8% |
| Choice (选择) | Loss (损失) | Precision (精度/无死线) | 59.6% (回避大损失 40.4%) |
| Choice (选择) | Loss (损失) | Speed (速度/限时3.5s) | 61.8% (回避大损失 38.2%) |
| Buy (买入定价) | Gain (收益) | Precision (精度/无死线) | 65.2% |
| Buy (买入定价) | Gain (收益) | Speed (速度/限时7.5s) | 64.2% |
| Buy (买入定价) | Loss (损失) | Precision (精度/无死线) | 67.2% |
| Buy (买入定价) | Loss (损失) | Speed (速度/限时7.5s) | 69.8% |
| Sell (卖出定价) | Gain (收益) | Precision (精度/无死线) | 68.6% |
| Sell (卖出定价) | Gain (收益) | Speed (速度/限时7.5s) | 68.0% |
| Sell (卖出定价) | Loss (损失) | Precision (精度/无死线) | 72.2% |
| Sell (卖出定价) | Loss (损失) | Speed (速度/限时7.5s) | 72.2% |
从表 1 可以清晰看出:在二选一选择任务中,收益情境下大金额选项被选中的概率仅为 55.6%;而在定价任务中,基于独立报价推导出的偏好大金额比例急剧上升至 66.5%(收益)与 70.4%(损失),在卖出损失条件下甚至高达 72.2%。
贝叶斯方差分析(Bayesian ANOVA)进一步揭示了绝对定价水平的系统性差异:反应时间死线对价格没有主效应,最佳预测模型包含效价(Gain/Loss)、买卖框架(Buy/Sell)及其二阶交互项()。各条件平均价格呈现严密的阶梯式分布:**买入收益(M = 6.13) \approx 买入损失(M = 8.04)**。这一分布强有力地表明,损失框架与卖出框架对主观估值具有协同放大效应,且无法单用“所有权假说”进行解释。
【表 2:行为测量与模型参数跨两周重测信度】表 2 汇总了跨越两周时间间隔的重测信度(Pearson 与 95% 最高密度区间 HDI):
| 测量范式 (Response) | 价值效价 (Valence) | 时间条件 (Deadline) | 重测信度 Pearson r [95% HDI] |
|---|---|---|---|
| Choice (选择) | Gain (收益) | Precision (精度) | r = 0.75 [0.69, 0.80] |
| Choice (选择) | Gain (收益) | Speed (速度) | r = 0.60 [0.52, 0.67] |
| Choice (选择) | Loss (损失) | Precision (精度) | r = 0.46 [0.35, 0.55] |
| Choice (选择) | Loss (损失) | Speed (速度) | r = 0.44 [0.33, 0.53] |
| Buy (买入定价) | Gain (收益) | Precision (精度) | r = 0.82 [0.79, 0.85] |
| Buy (买入定价) | Gain (收益) | Speed (速度) | r = 0.86 [0.84, 0.88] |
| Buy (买入定价) | Loss (损失) | Precision (精度) | r = 0.83 [0.80, 0.86] |
| Buy (买入定价) | Loss (损失) | Speed (速度) | r = 0.90 [0.88, 0.91] |
| Sell (卖出定价) | Gain (收益) | Precision (精度) | r = 0.91 [0.90, 0.93] |
| Sell (卖出定价) | Gain (收益) | Speed (速度) | r = 0.90 [0.88, 0.92] |
| Sell (卖出定价) | Loss (损失) | Precision (精度) | r = 0.76 [0.72, 0.79] |
| Sell (卖出定价) | Loss (损失) | Speed (速度) | r = 0.71 [0.66, 0.75] |
实证数据显示,定价任务的行为重测信度极高(大多数 ),显著优于二值选择任务()。这证实连续标尺定价任务具有更高的信息熵容量与测量稳定性。
第五章 论文全部图表的深度植入与图解全景剖析
5.1 图 1:实验响应任务范式全景解析 (Figure 1)
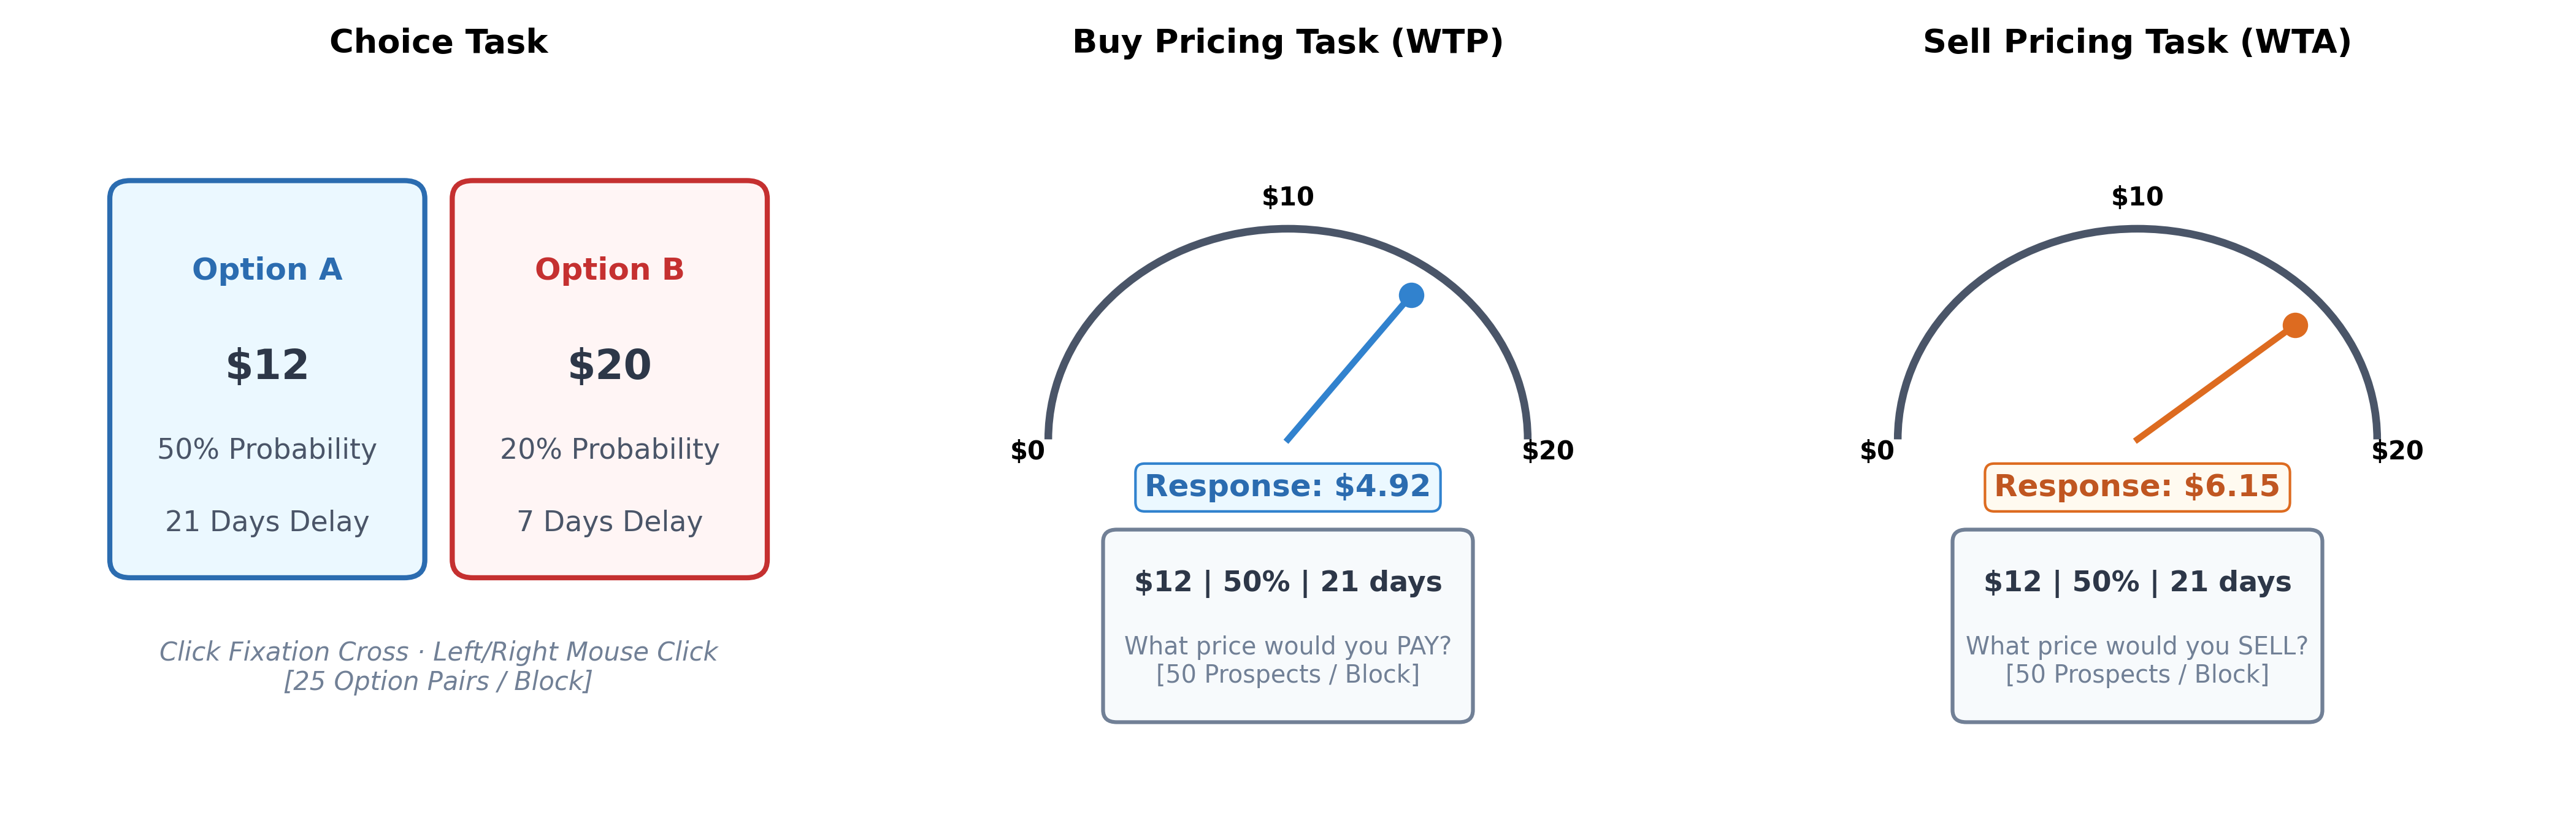
图 1:实验响应任务范式示意图(二选一决策、买入意愿支付 WTP 与卖出意愿接受 WTA 定价)
【图 1 深度解析】图 1 详尽展示了本实验的三大核心人机交互任务界面。左侧为二选一选择任务(Choice),被试点击注视十字启动,屏幕左右呈现两个包含金额、概率与延迟的复合选项,通过鼠标左右键点击做出选择。中间为买入定价任务(Buy Pricing / WTP),屏幕下方呈现单项前景,上方呈现从 20 的连续半圆极坐标标尺,被试通过鼠标滑移至目标价格并点击,文本框实时反馈报价数值。右侧为卖出定价任务(Sell Pricing / WTA),界面结构与买入相同,但指导语要求评估放弃该前景索要的补偿价格。
5.2 图 2:多属性选择-定价偏好反转分布解析 (Figure 2)
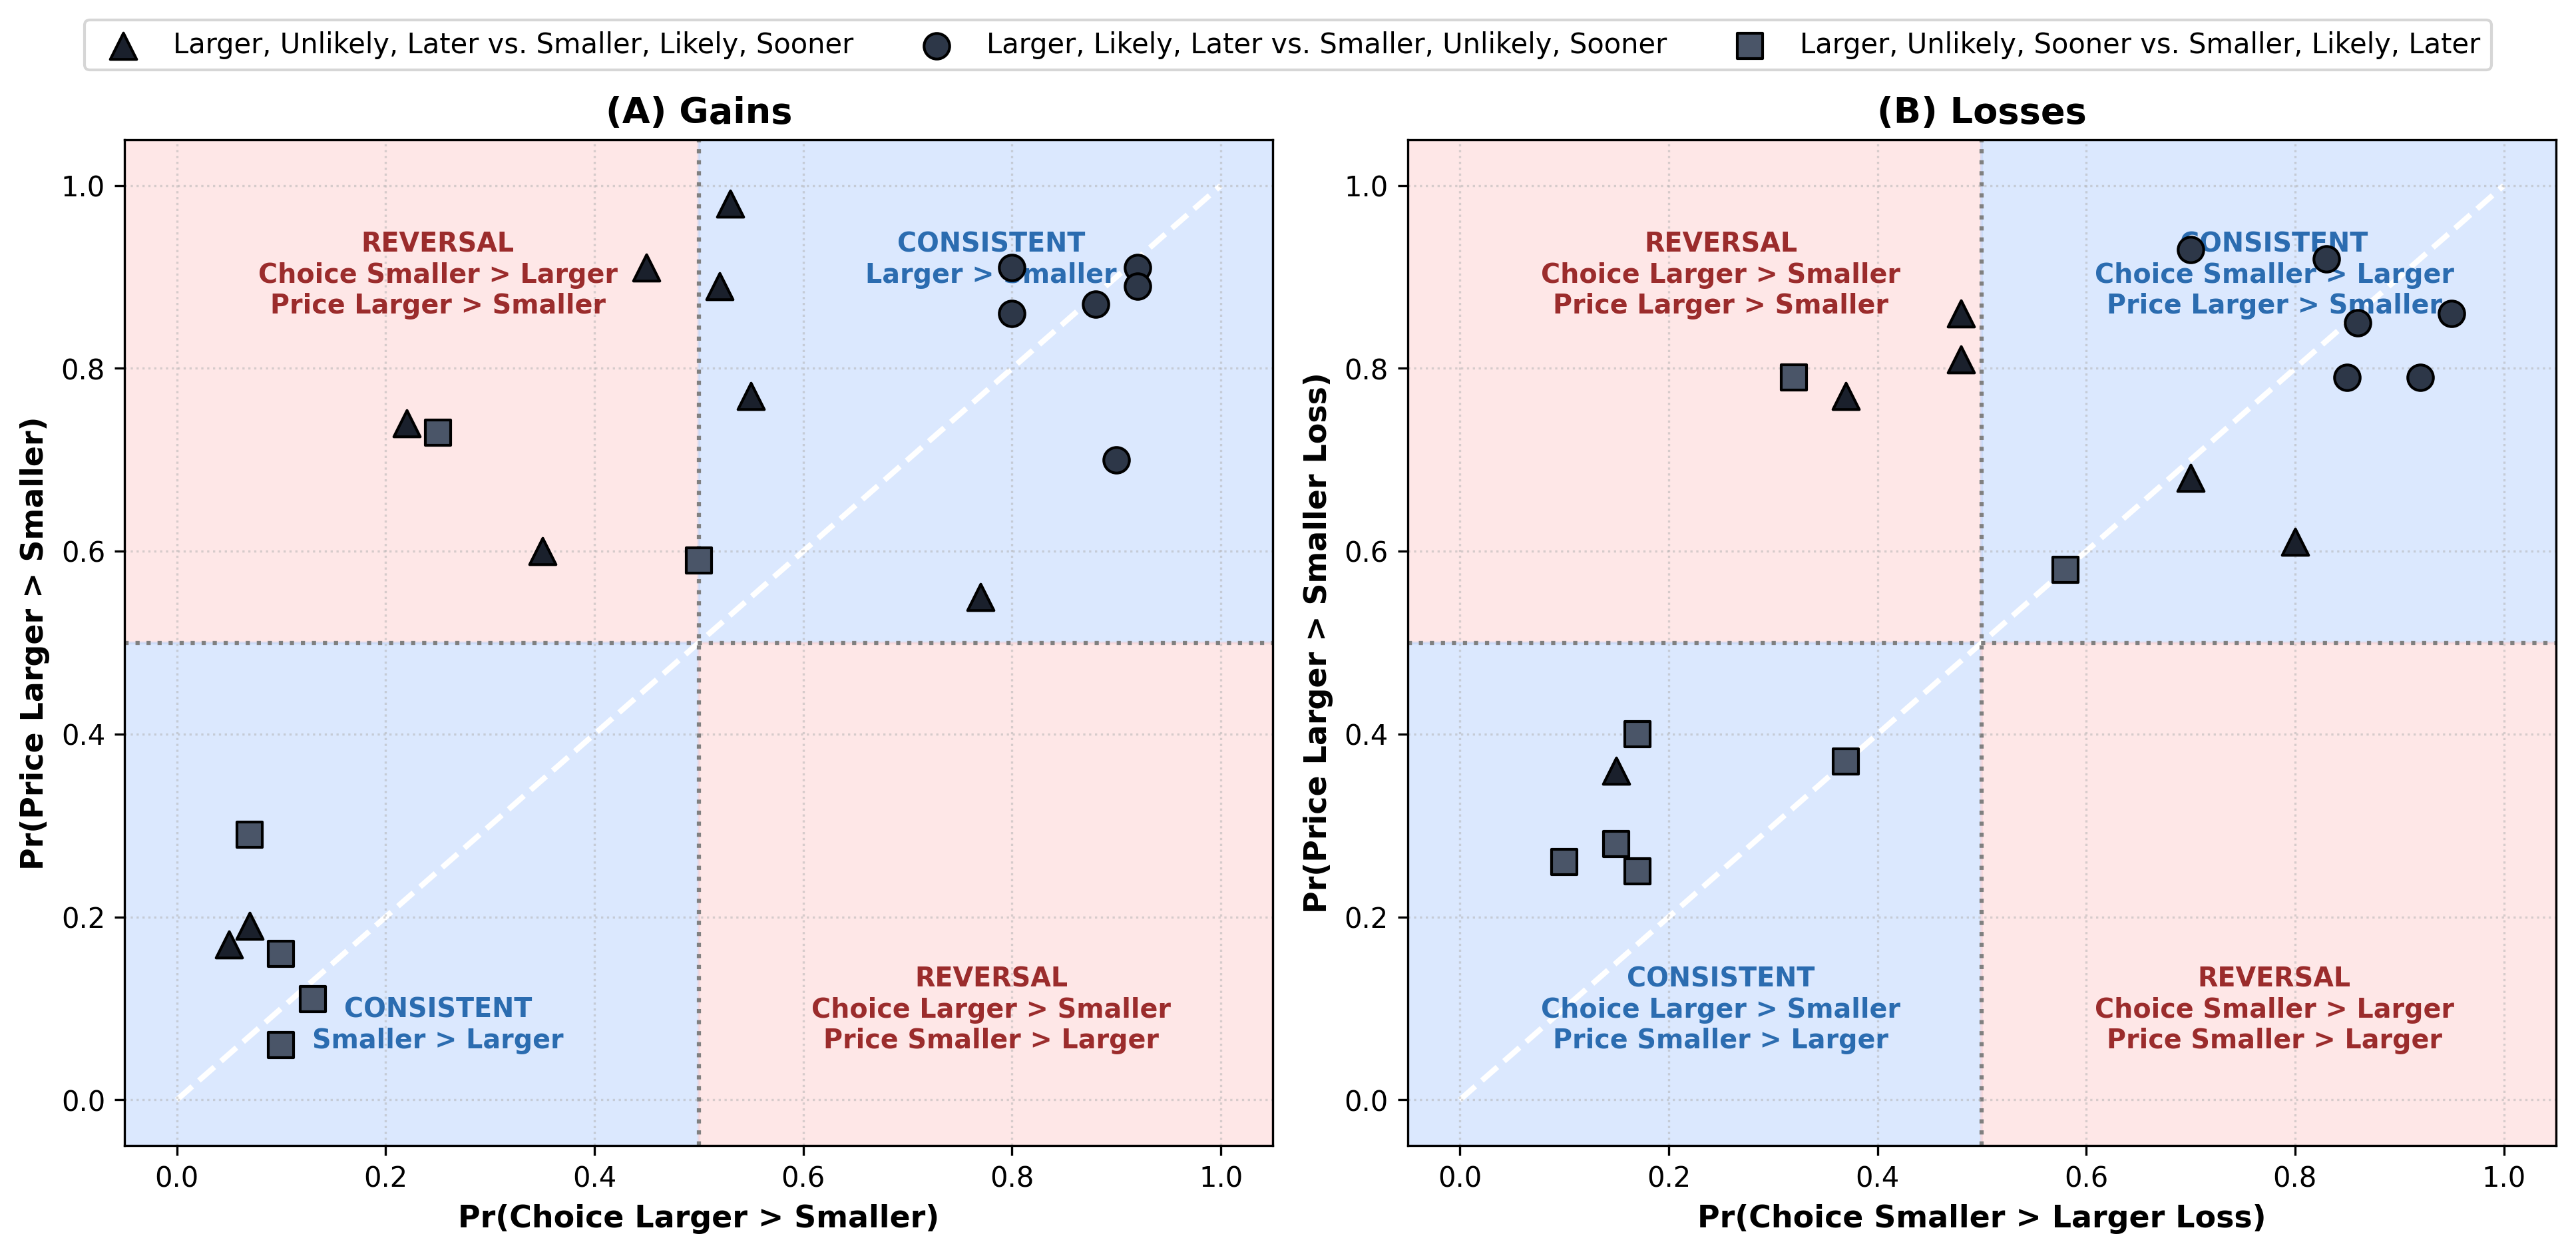
图 2:多属性刺激下的选择-定价偏好反转散点分布图(A: 收益情境;B: 损失情境)
【图 2 深度解析】图 2 将 22 对刺激选项在选择任务与定价任务中的偏好匹配关系绘制于四象限图中。横轴为选择大金额选项的比例,纵轴为定价赋予大金额选项更高价格的比例。对角线代表跨任务绝对一致。左上粉色区域为经典偏好反转区(选择偏好小金额,定价偏好大金额)。实证结果显示,在收益与损失情境下,均有 4 对选项(占比 18.2%)发生偏好反转,且全部落在左上反转区。其中,3 对反转选项(三角符号)严格属于“金额单优势支配”结构(大、低概率、长延迟 vs 小、高概率、短延迟),强有力地证实了当概率与延迟均不利于大金额时,定价中的尺度兼容性锚定是反转的核心诱因。
5.3 图 3:选择任务动态漂移扩散模型架构解析 (Figure 3)
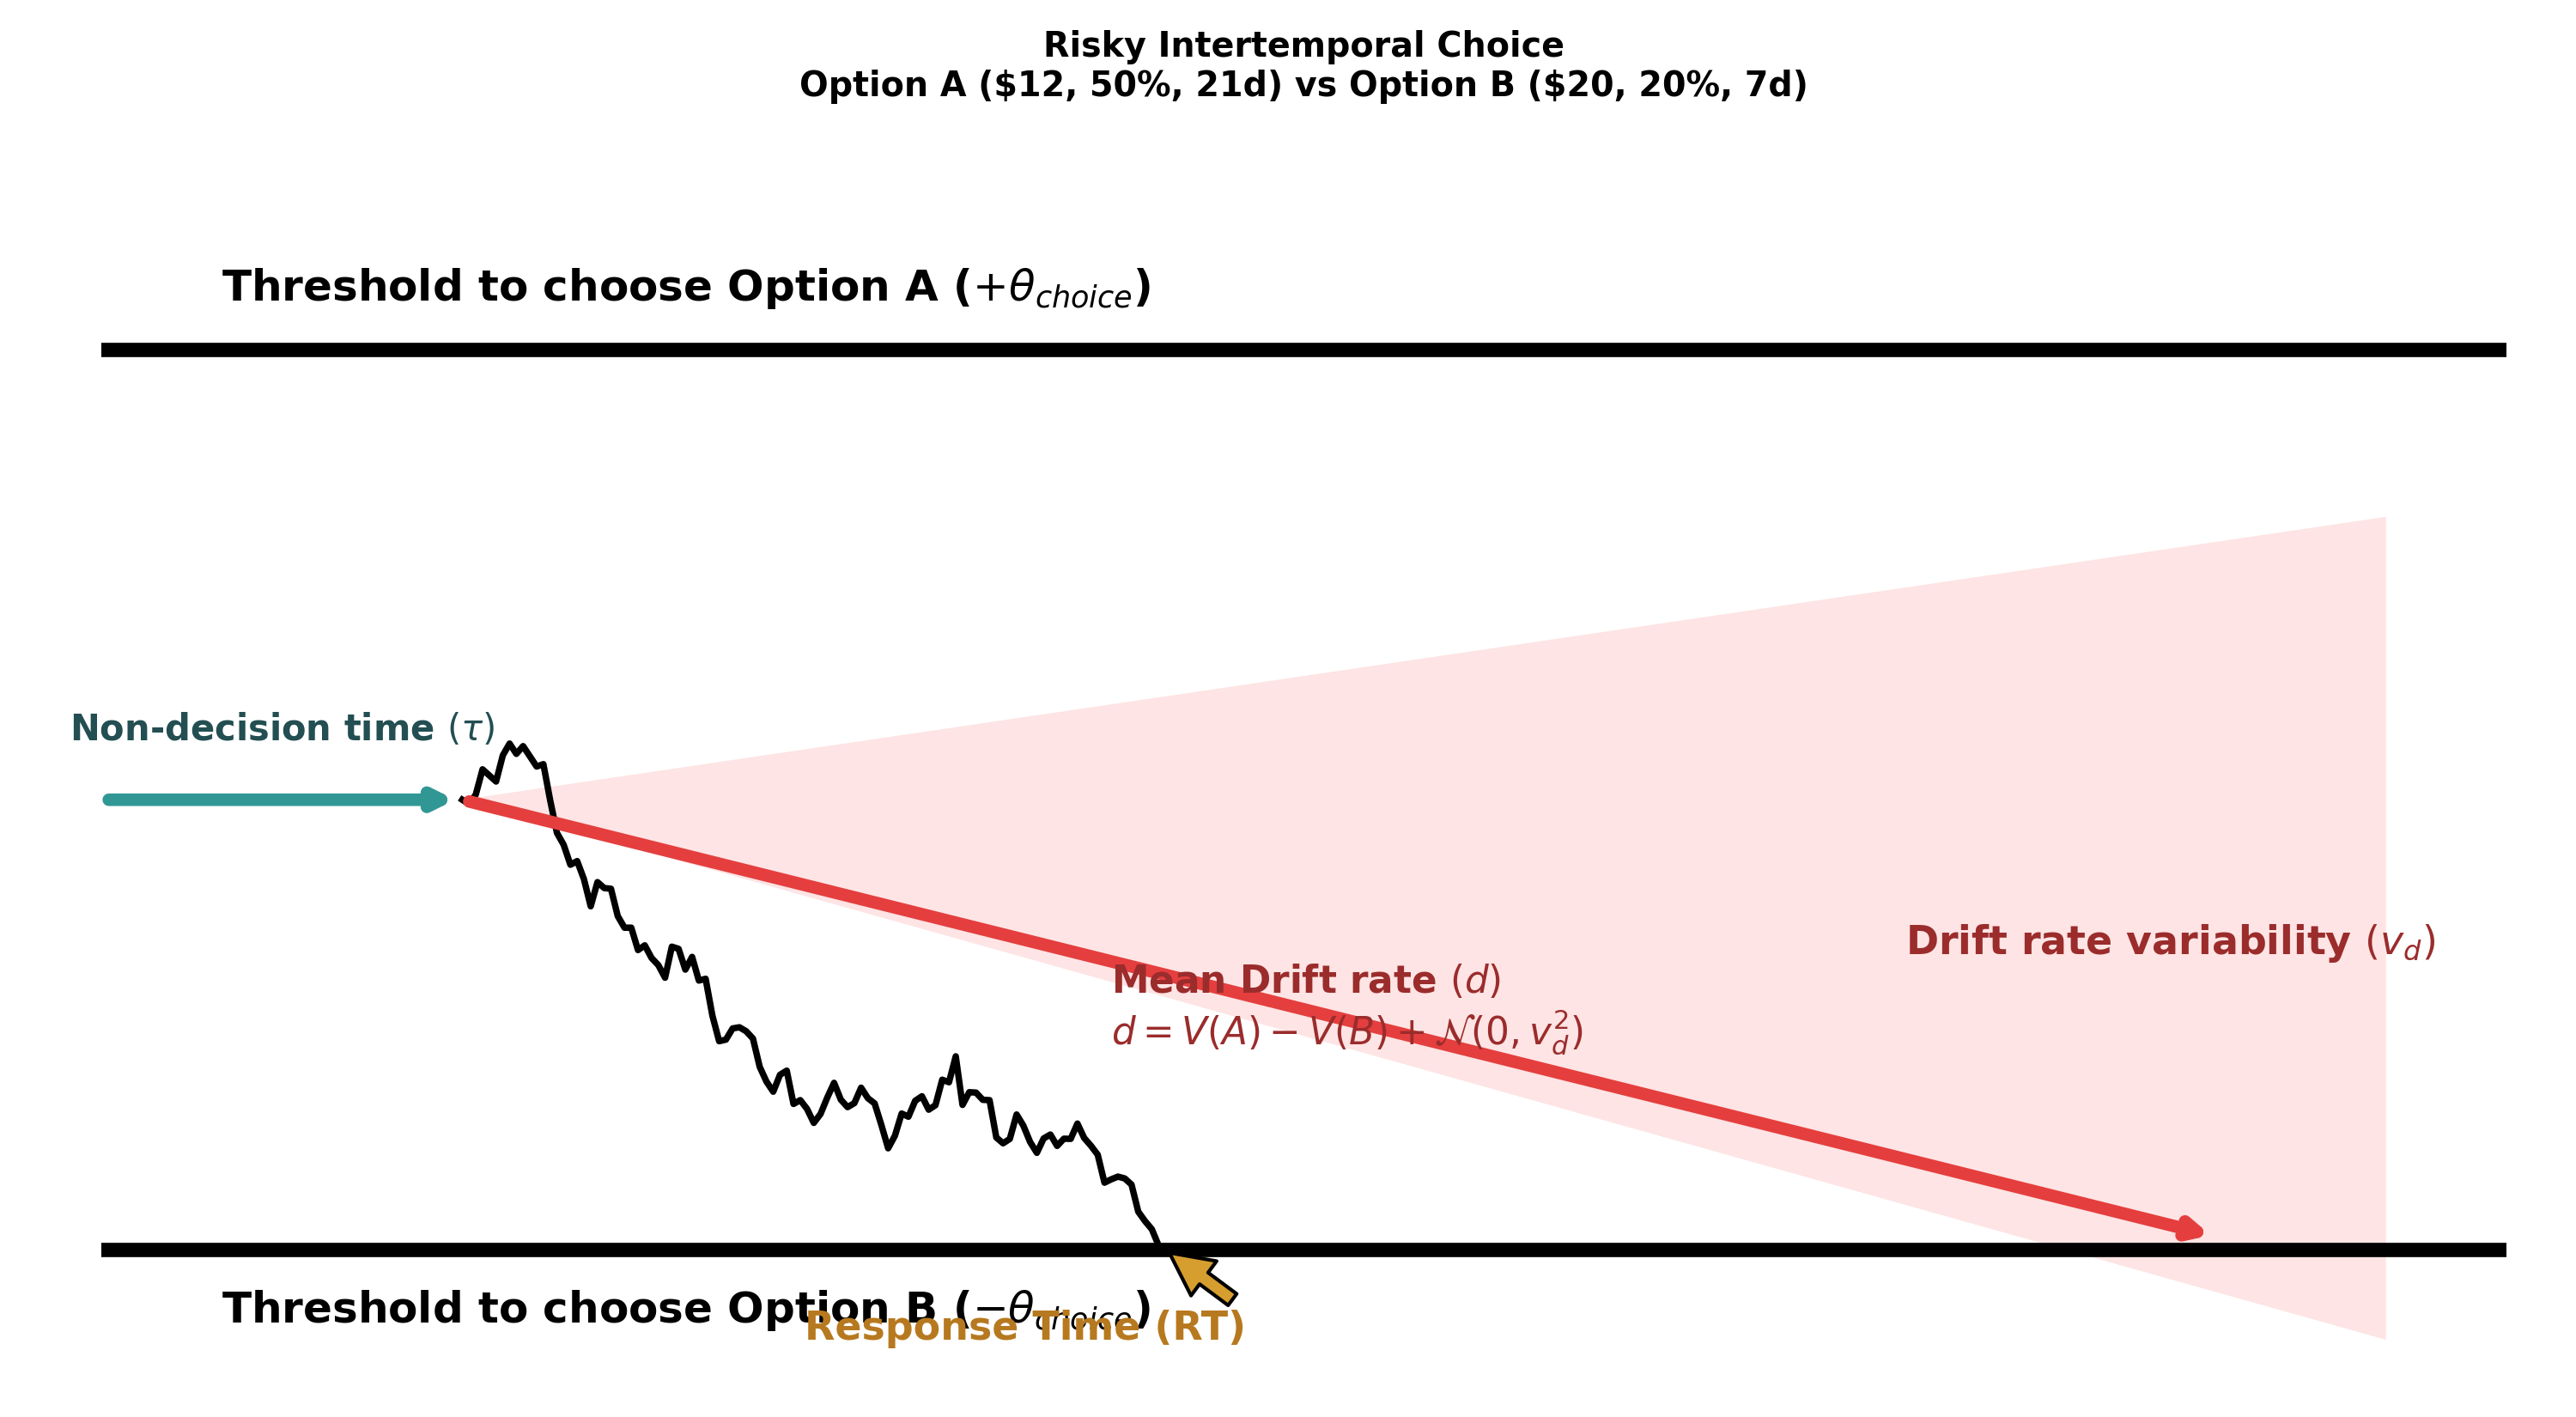
图 3:二选一决策的维纳漂移扩散模型(DDM)微观认知架构示意图
【图 3 深度解析】图 3 直观展现了二选一决策的证据累积动力学。经过非决策时间 的刺激编码后,决策状态以平均漂移率 向目标边界演化。粉色发散圆锥体代表试次间漂移率变异性 ,黑色锯齿折线代表包含试次内扩散噪声 的实际随机轨迹。轨迹触及上边界 或下边界 时终止,输出决策并记录反应时间 RT。
5.4 图 4:定价任务二维极坐标状态空间累积模型架构解析 (Figure 4)
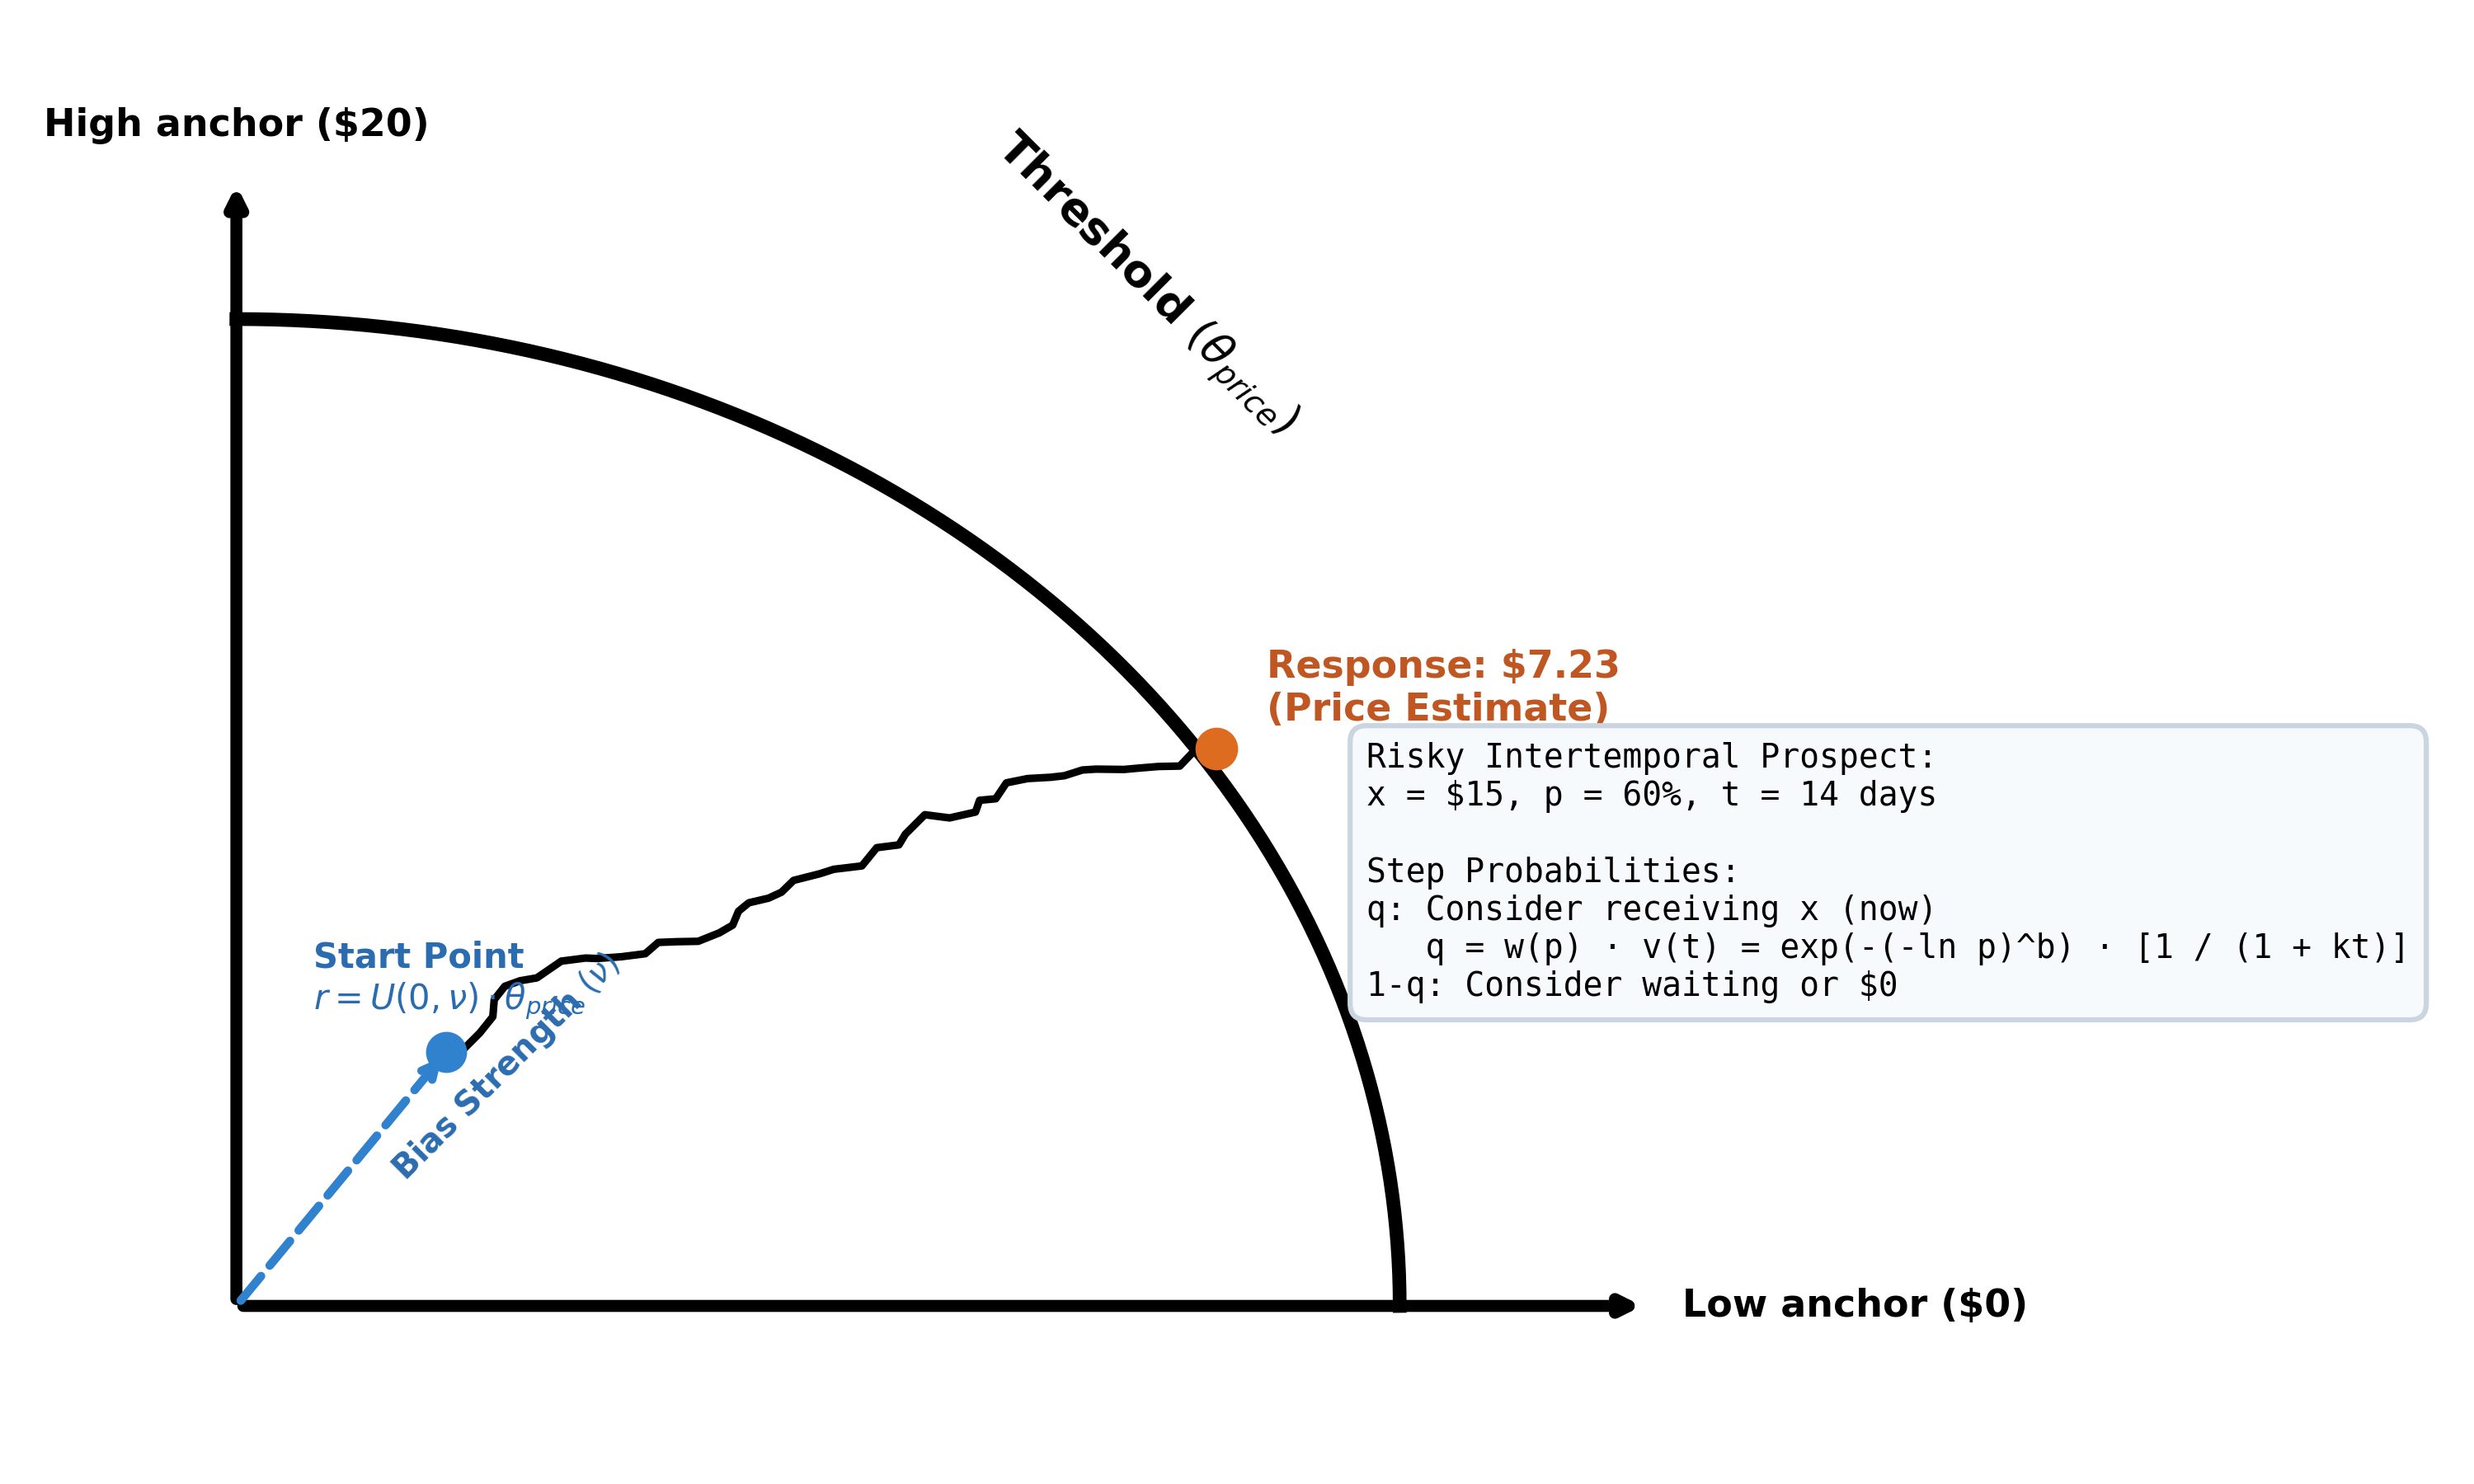
图 4:连续定价任务的二维极坐标状态空间证据累积模型动力学机制示意图
【图 4 深度解析】图 4 阐明了连续定价的几何累积机制。决策空间为半径 的四分之一圆弧。决策首先以半径 锚定于金额角 ;随后,以概率 向金额角步进(模拟立即获得),以 向 \alpha = 1.0\alpha = 0.7$(凹性)如何对圆弧上的主观距离进行非线性空间重塑。
5.5 图 5:动态模型向静态微观经济理论的渐近收敛图解 (Figure 5)
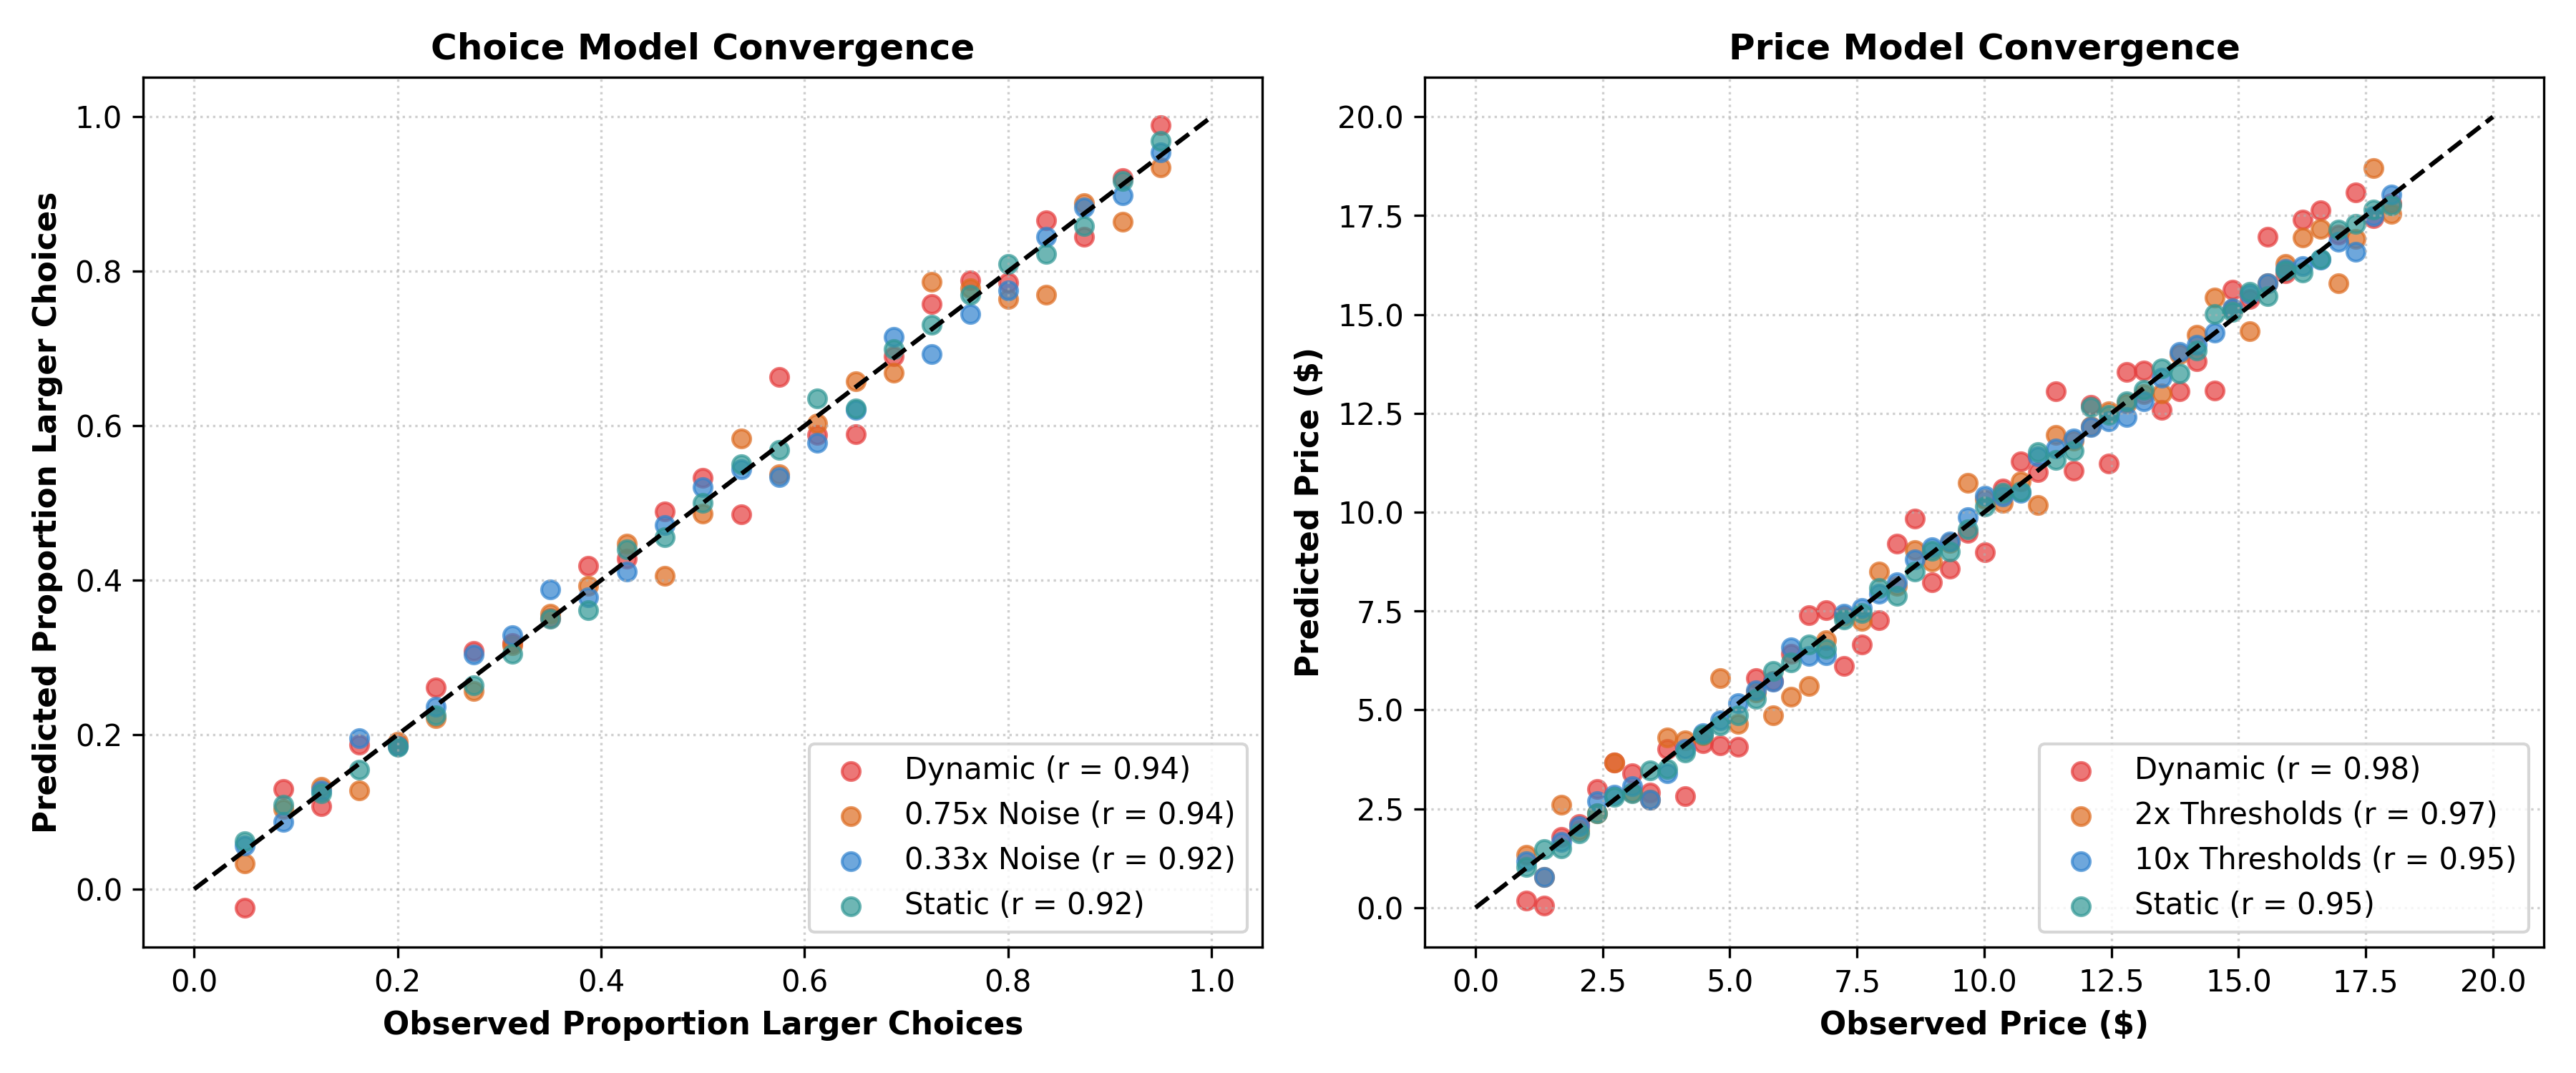
图 5:动态选择与定价模型向经典静态前景理论+双曲贴现模型的渐近收敛性数值验证
【图 5 深度解析】图 5 通过仿真模拟验证了命题 4 的收敛性定理。左图表明:当选择模型中的噪声逐步缩小至 与 时,动态 DDM 预测选择比例平滑收敛于静态 Logit 前景理论模型(相关系数高达 )。右图表明:当定价模型的阈值扩大至 与 时,极坐标累积模型预测价格完全收敛于静态乘法贴现期望价值模型(),确证了两类理论在数学极限上的自洽统一。
5.6 图 6:选择模型后验预测检验与反应时间分布解析 (Figure 6)
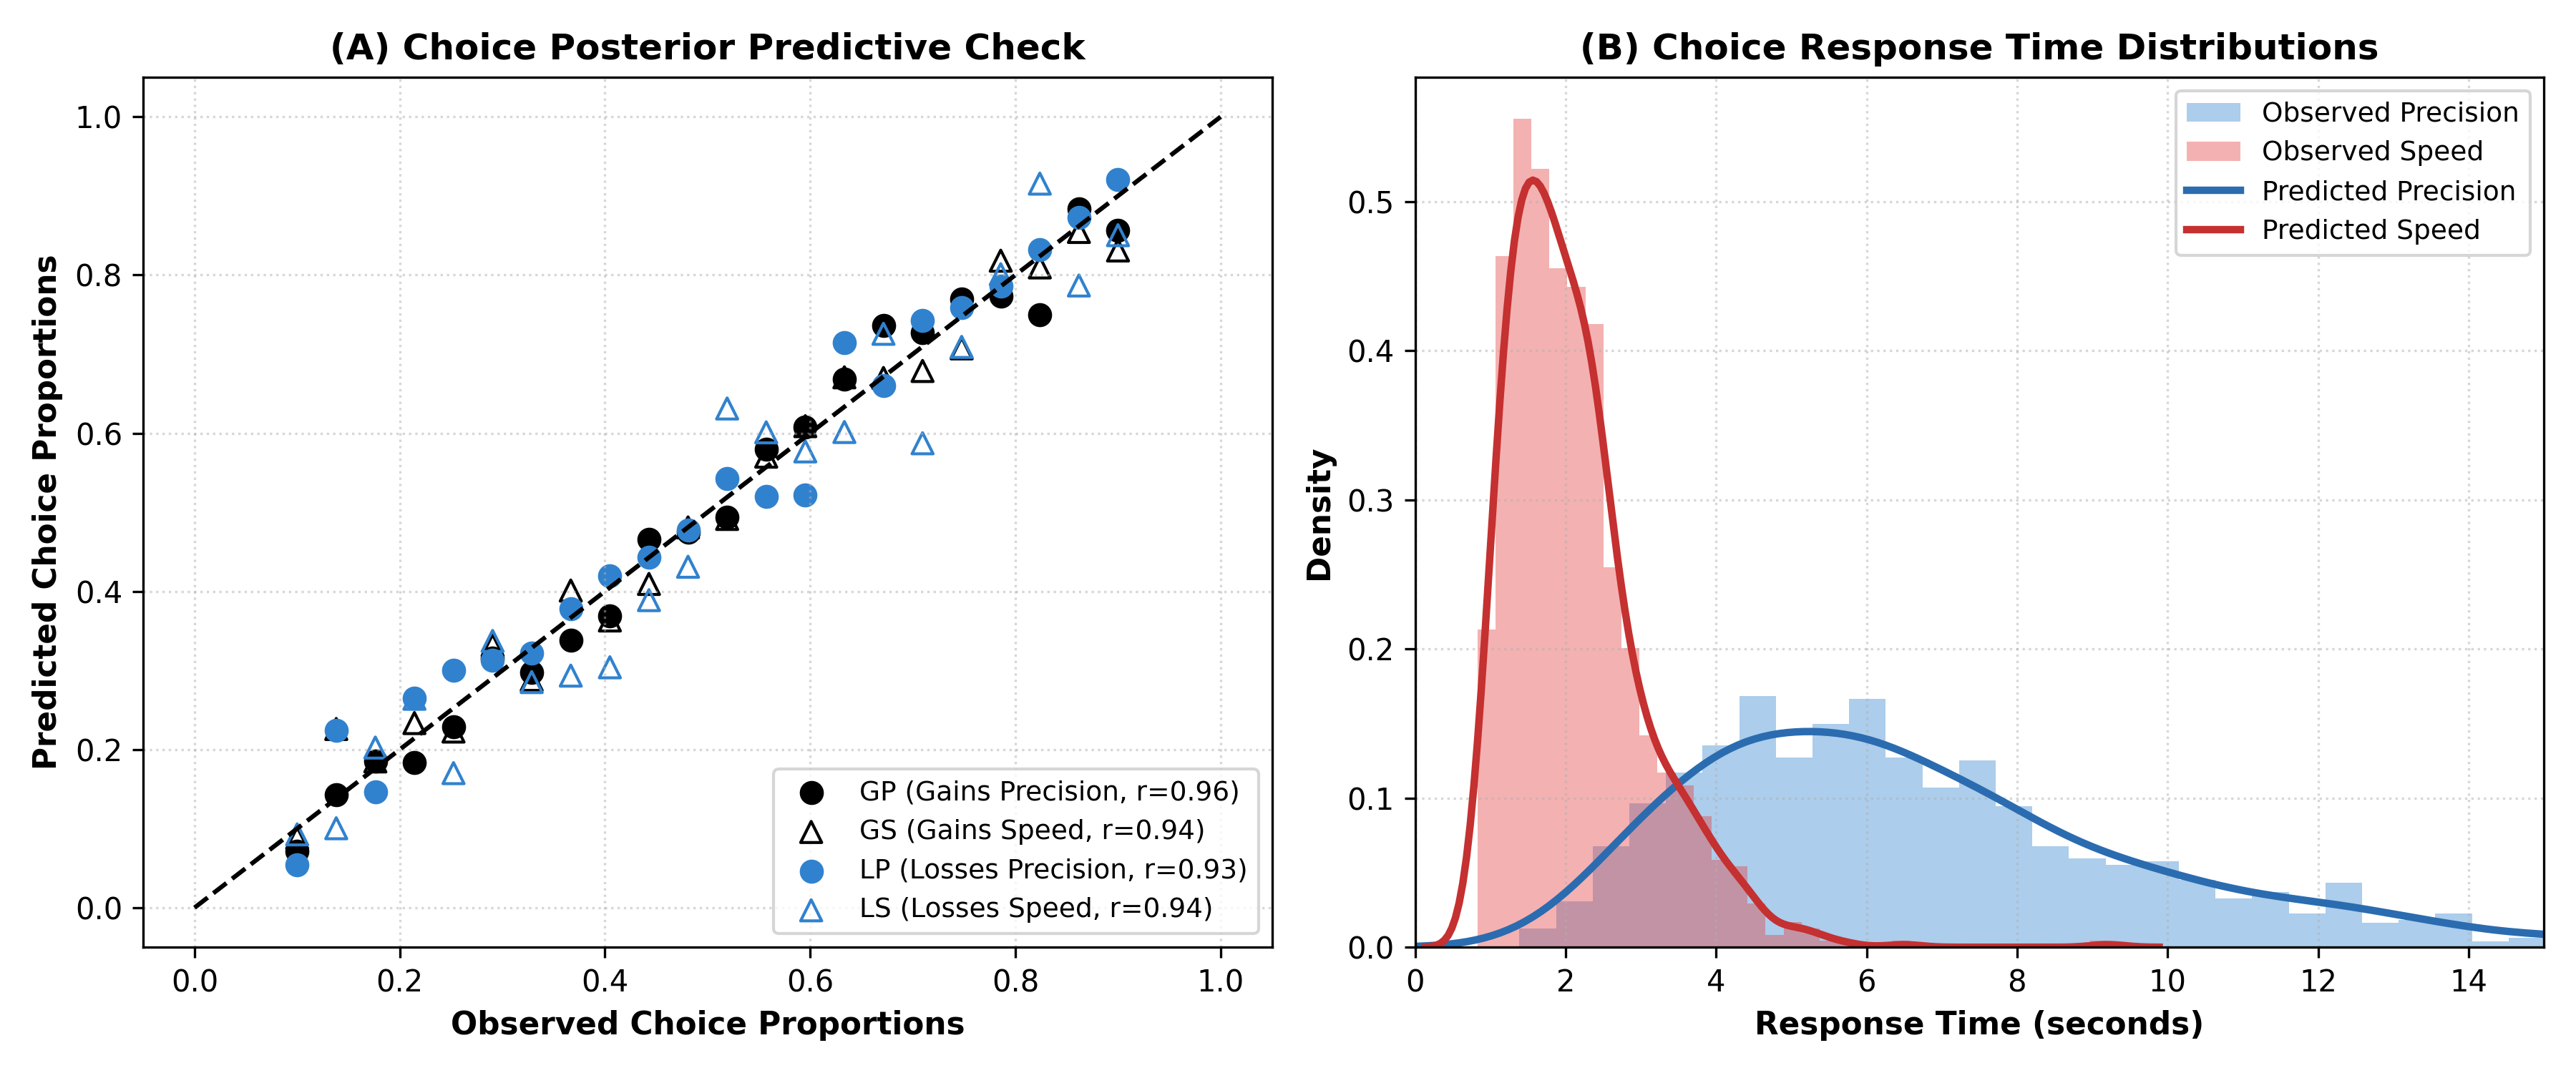
图 6:选择模型后验预测检验(A: 各条件选择比例拟合度;B: 反应时间长尾分布拟合)
【图 6 深度解析】图 6 评估了选择模型的拟合优度。(A) 散点图显示观测选择率与模型后验预测高度吻合,所有条件下的相关系数均超过 (GP: 0.96, GS: 0.94, LP: 0.93, LS: 0.94),解释了 86% 以上的实验方差。(B) 直方图与拟合核密度曲线显示,模型精准再现了精度条件(蓝色长尾)与速度条件(红色左移陡峭)下的实证反应时间分布形态。
5.7 图 7:定价模型后验预测检验与反应时间分布解析 (Figure 7)
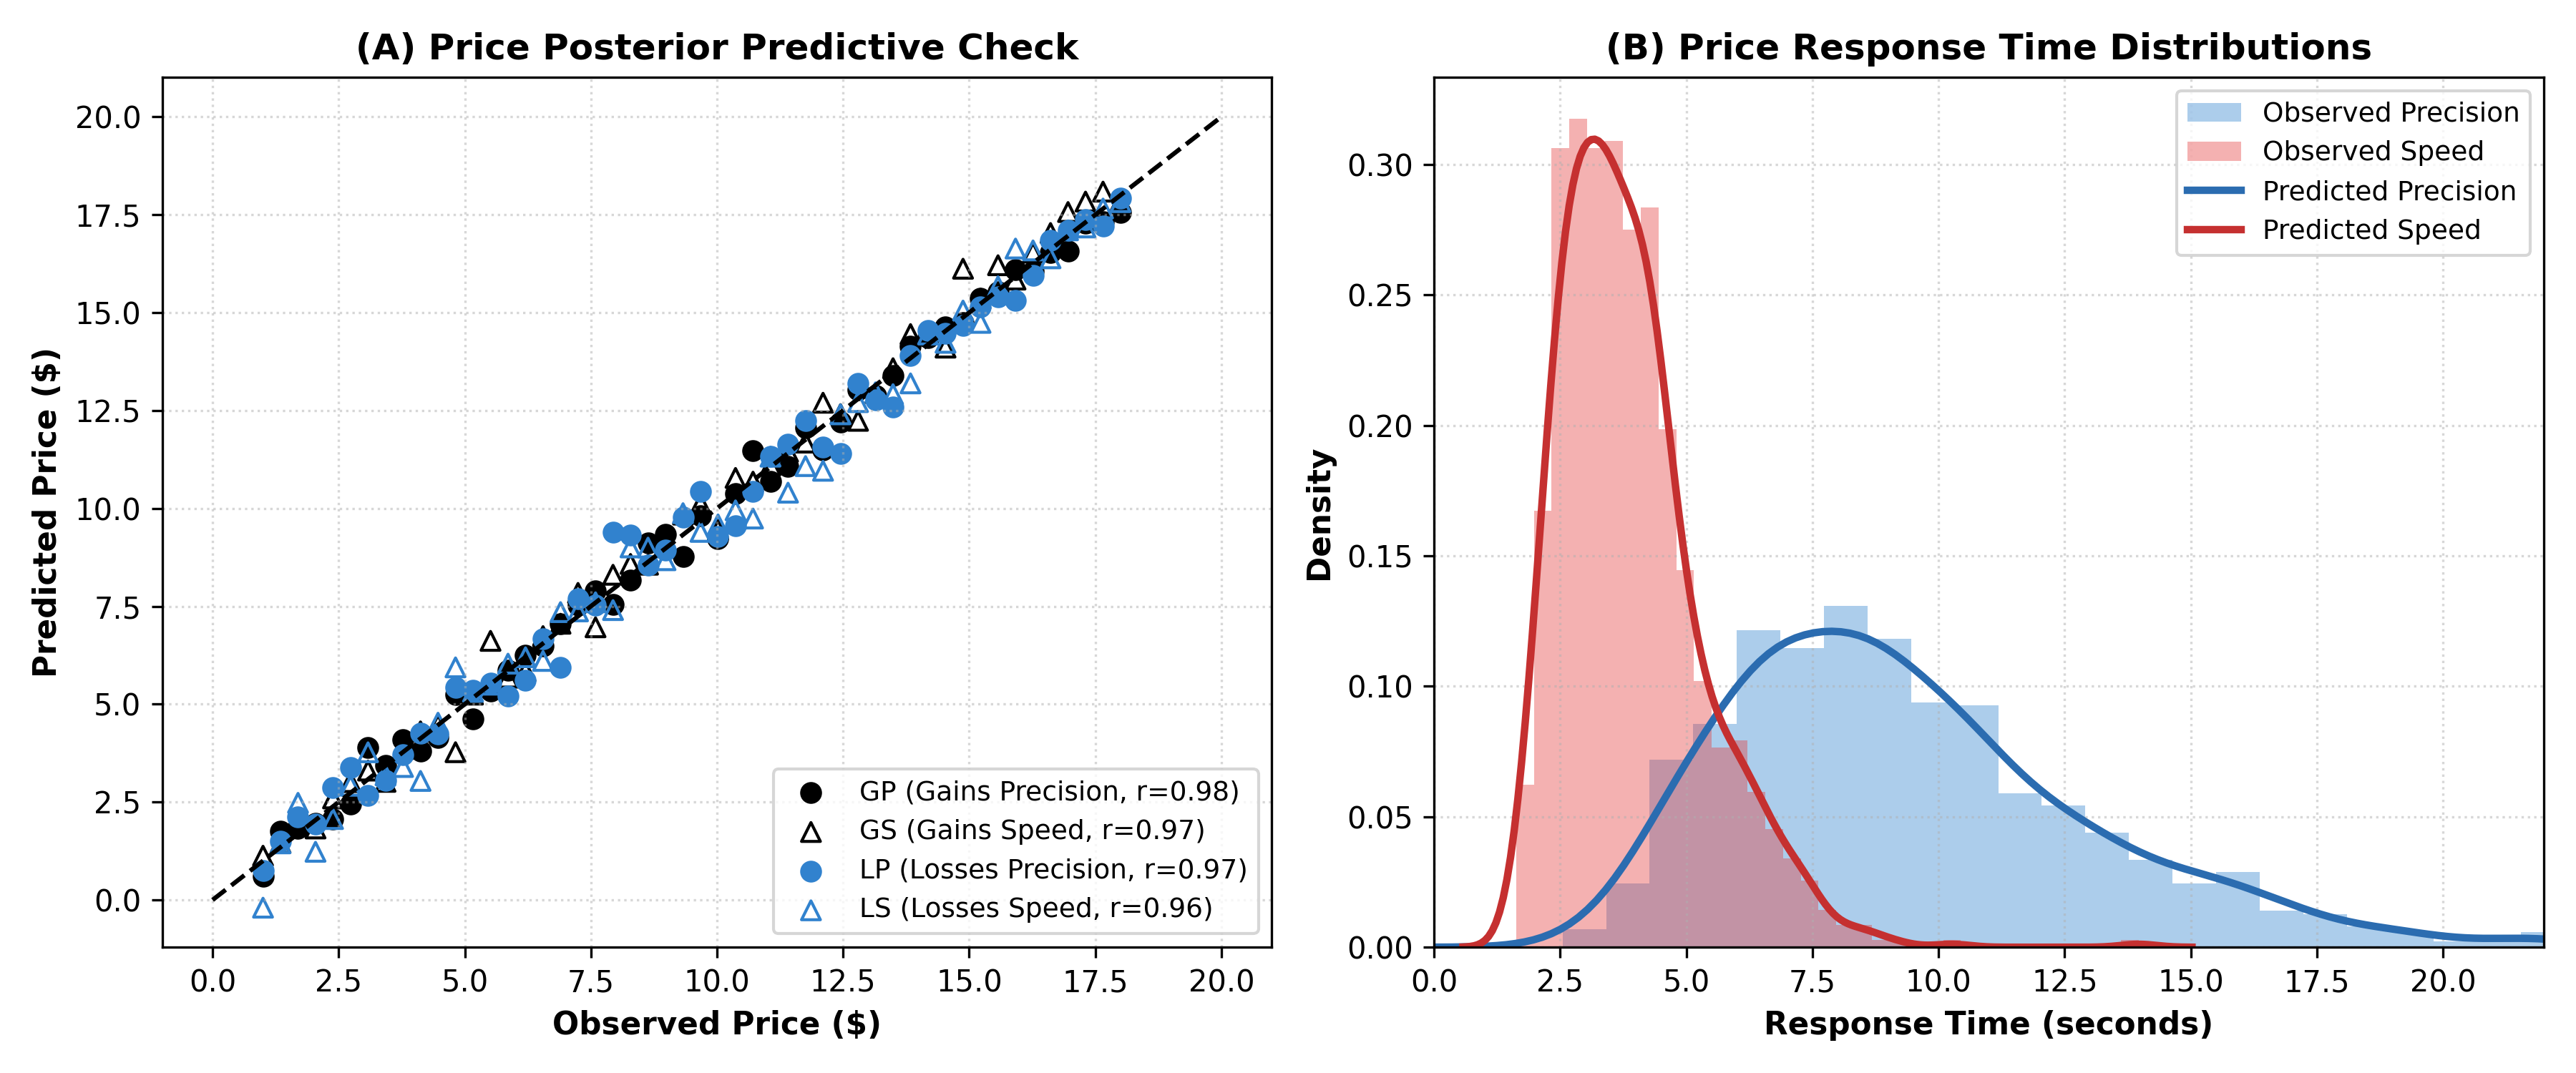
图 7:定价模型后验预测检验(A: 各条件报价拟合度;B: 反应时间形态拟合)
【图 7 深度解析】图 7 评估了极坐标定价模型的拟合表现。(A) 图中观测价格与预测价格严密贴合对角线,相关系数在所有买入与卖出情境下均达到 。(B) 反应时间拟合曲线表明,通过引入形态调节参数 ,模型完美捕获了定价任务在不同时间压力下的偏态响应潜伏期分布。
5.8 图 8 & 图 9:选择任务开关板模型比较与后验矩阵解析 (Figures 8 & 9)
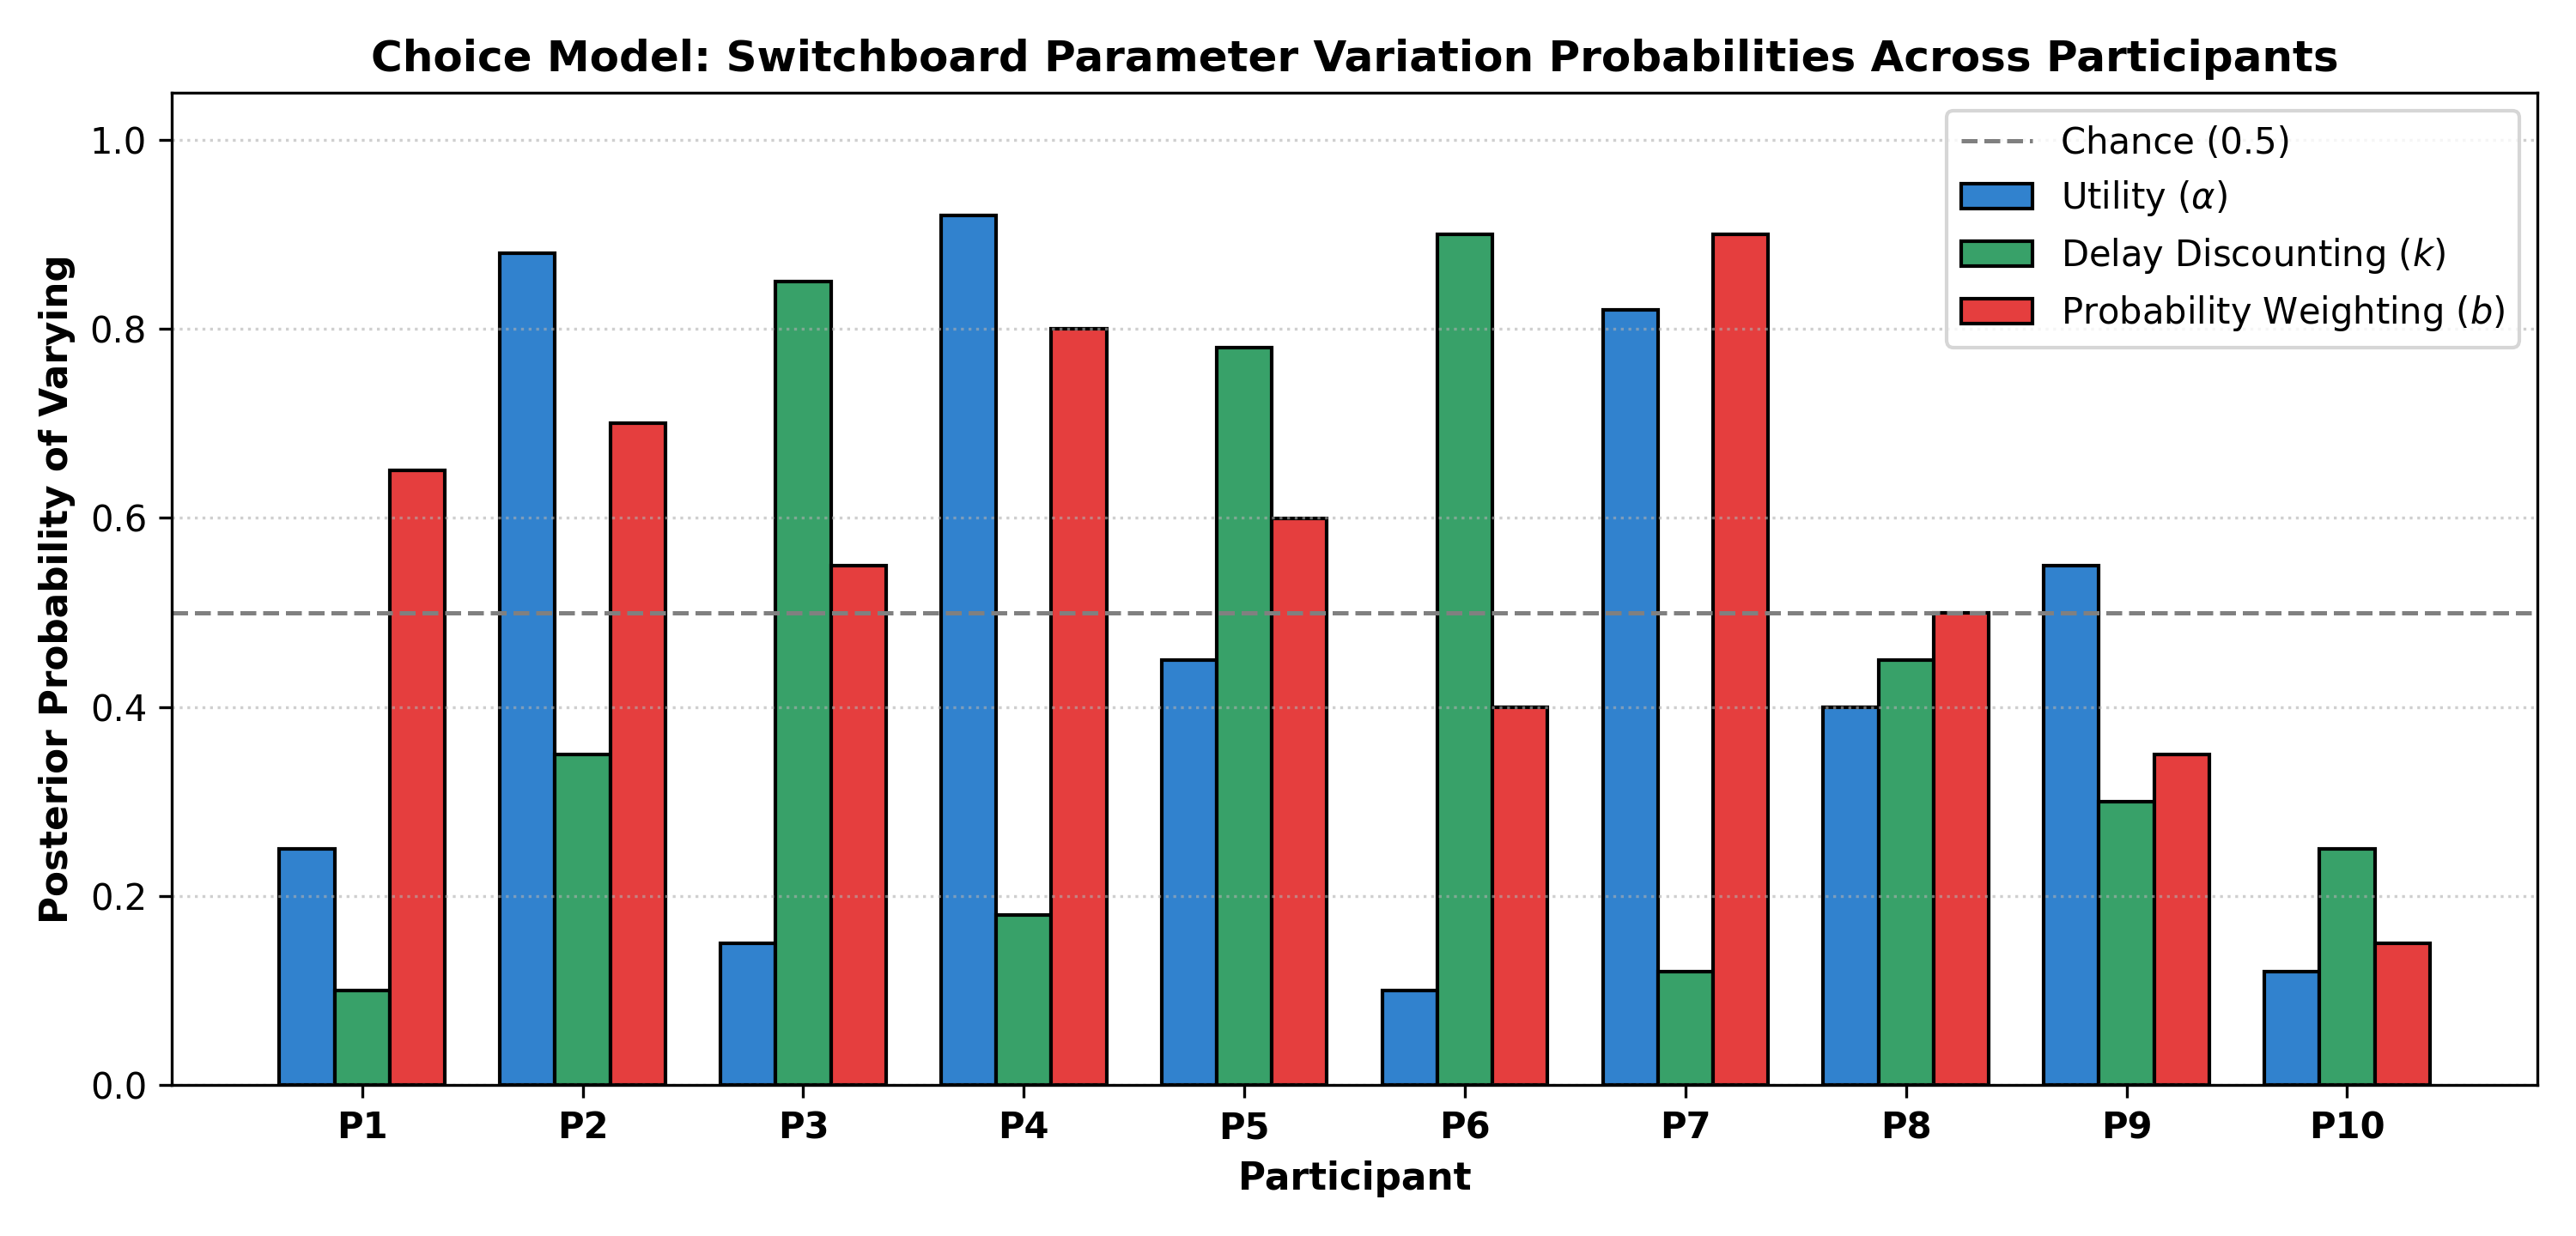
图 8:选择模型开关板分析中各被试主观价值参数跨收益/损失变异的后验概率柱状图
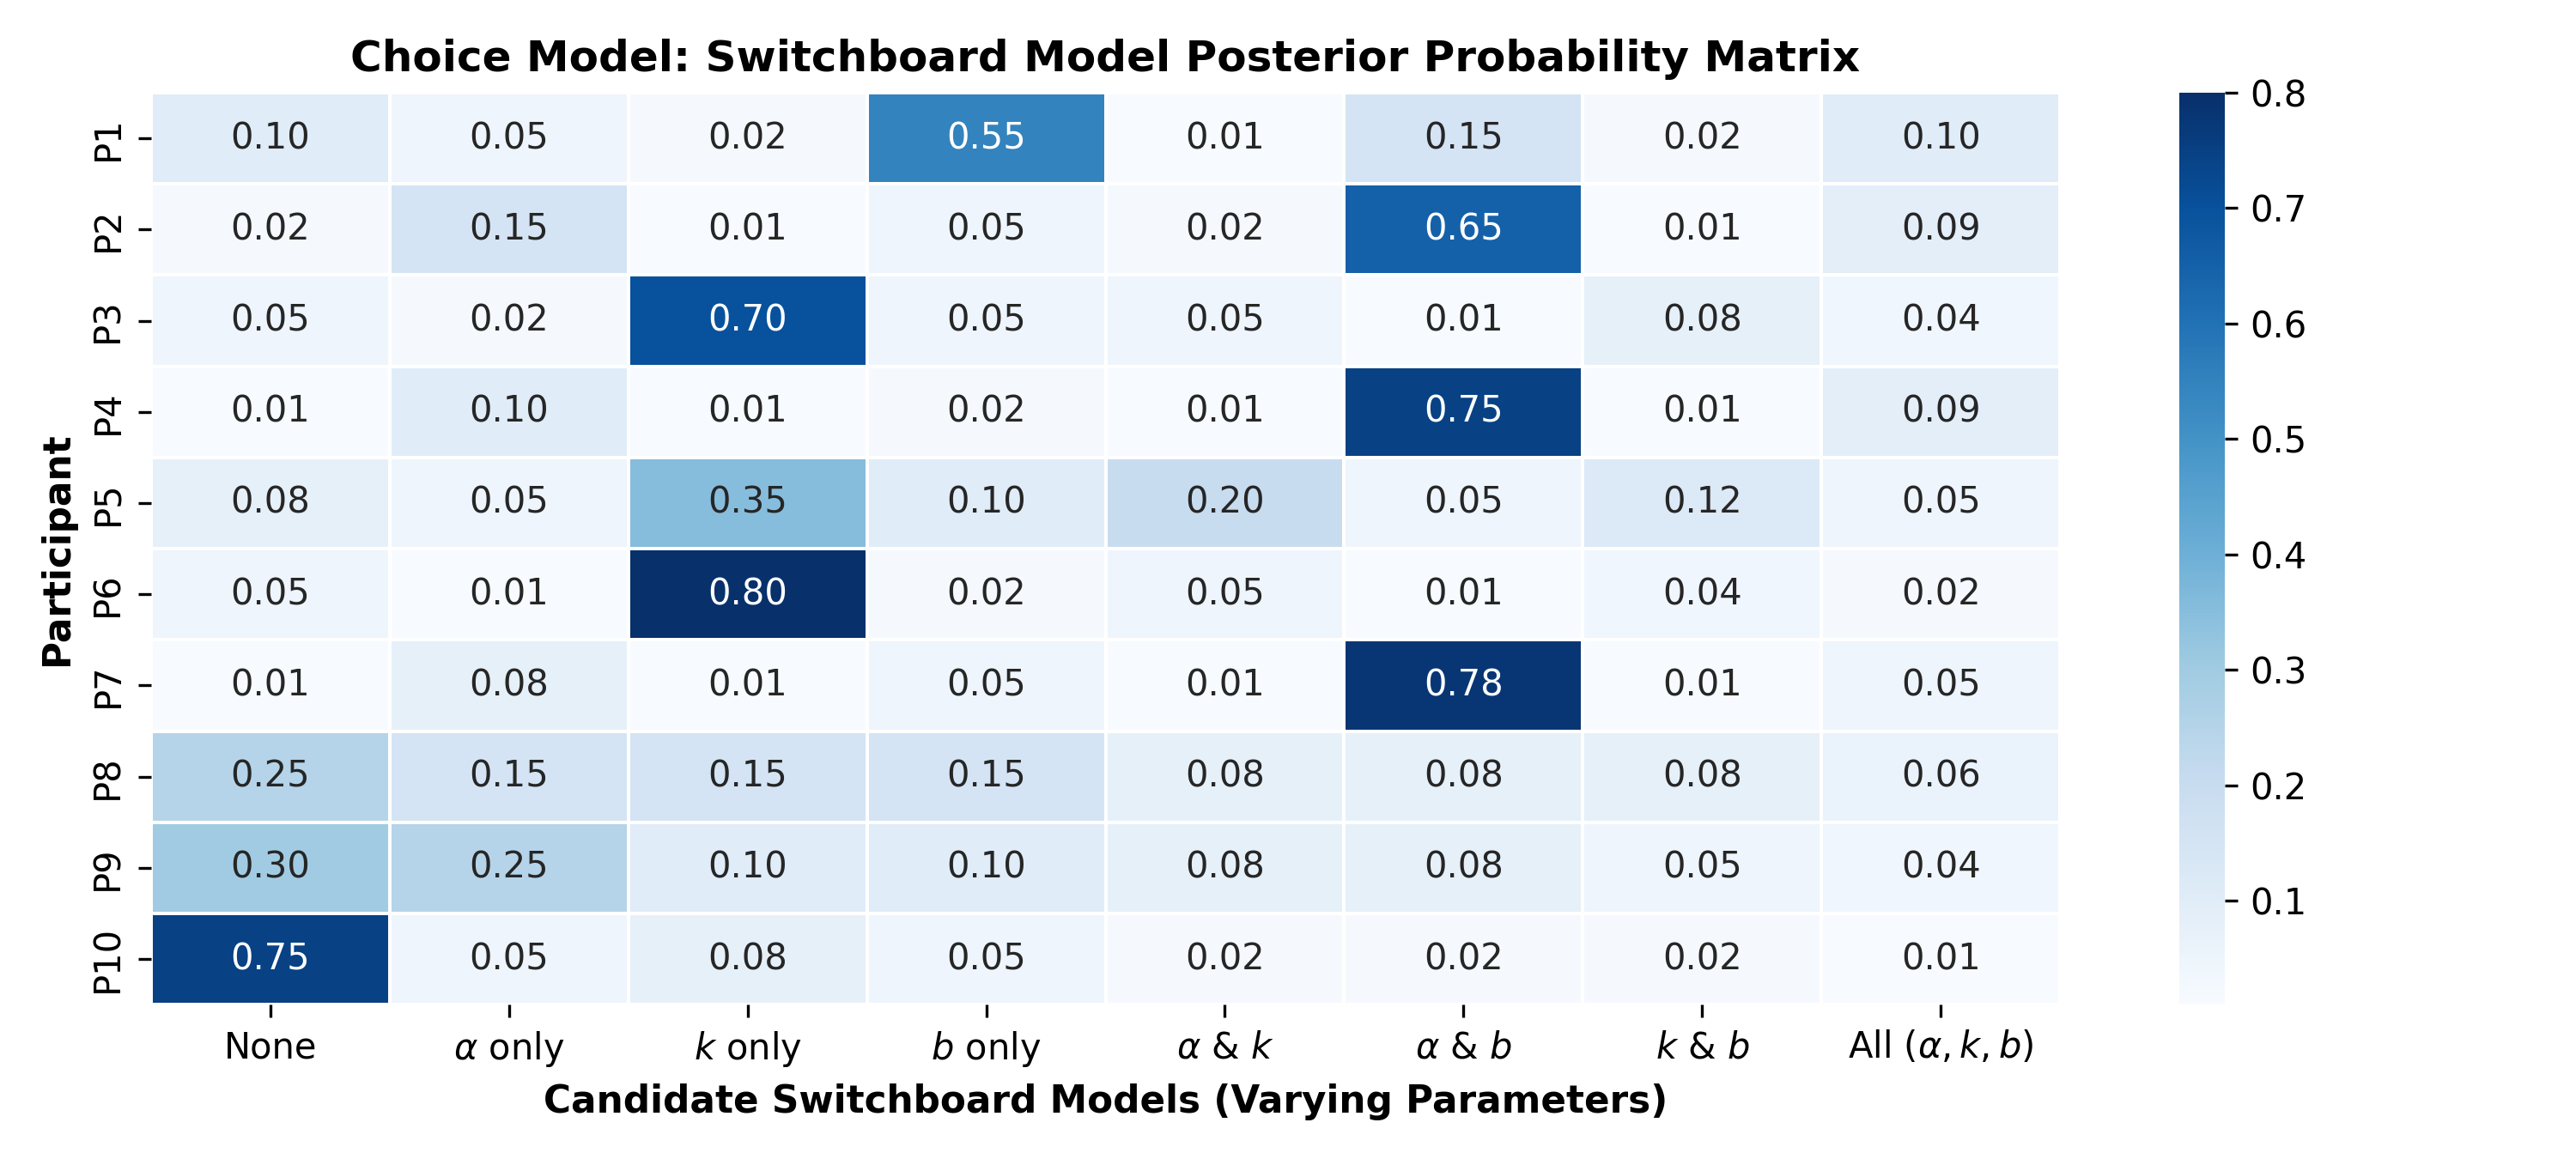
图 9:选择模型 8 种候选开关板架构在各被试实证数据上的后验匹配概率热力矩阵
【图 8 与图 9 深度解析】开关板分析(Switchboard Analysis)将效用 、贴现率 与概率权重 设定为可独立开启/关闭变异的开关,构成 种候选模型。图 8 显示:全样本层面上,、、 跨效价变异的平均后验概率分别为 0.46、0.43 与 0.56,表明收益与损失在群体平均上共享大致相似的价值函数;但图 9 热力图揭示出显著的个体异质性——被试 P3、P6 由贴现率变异主导,被试 P2、P4、P7 由效用与概率权重变异主导,被试 P10 则完全由固定参数模型主导。
5.9 图 10:群体层级主观价值与认知过程参数后验分布解析 (Figure 10)
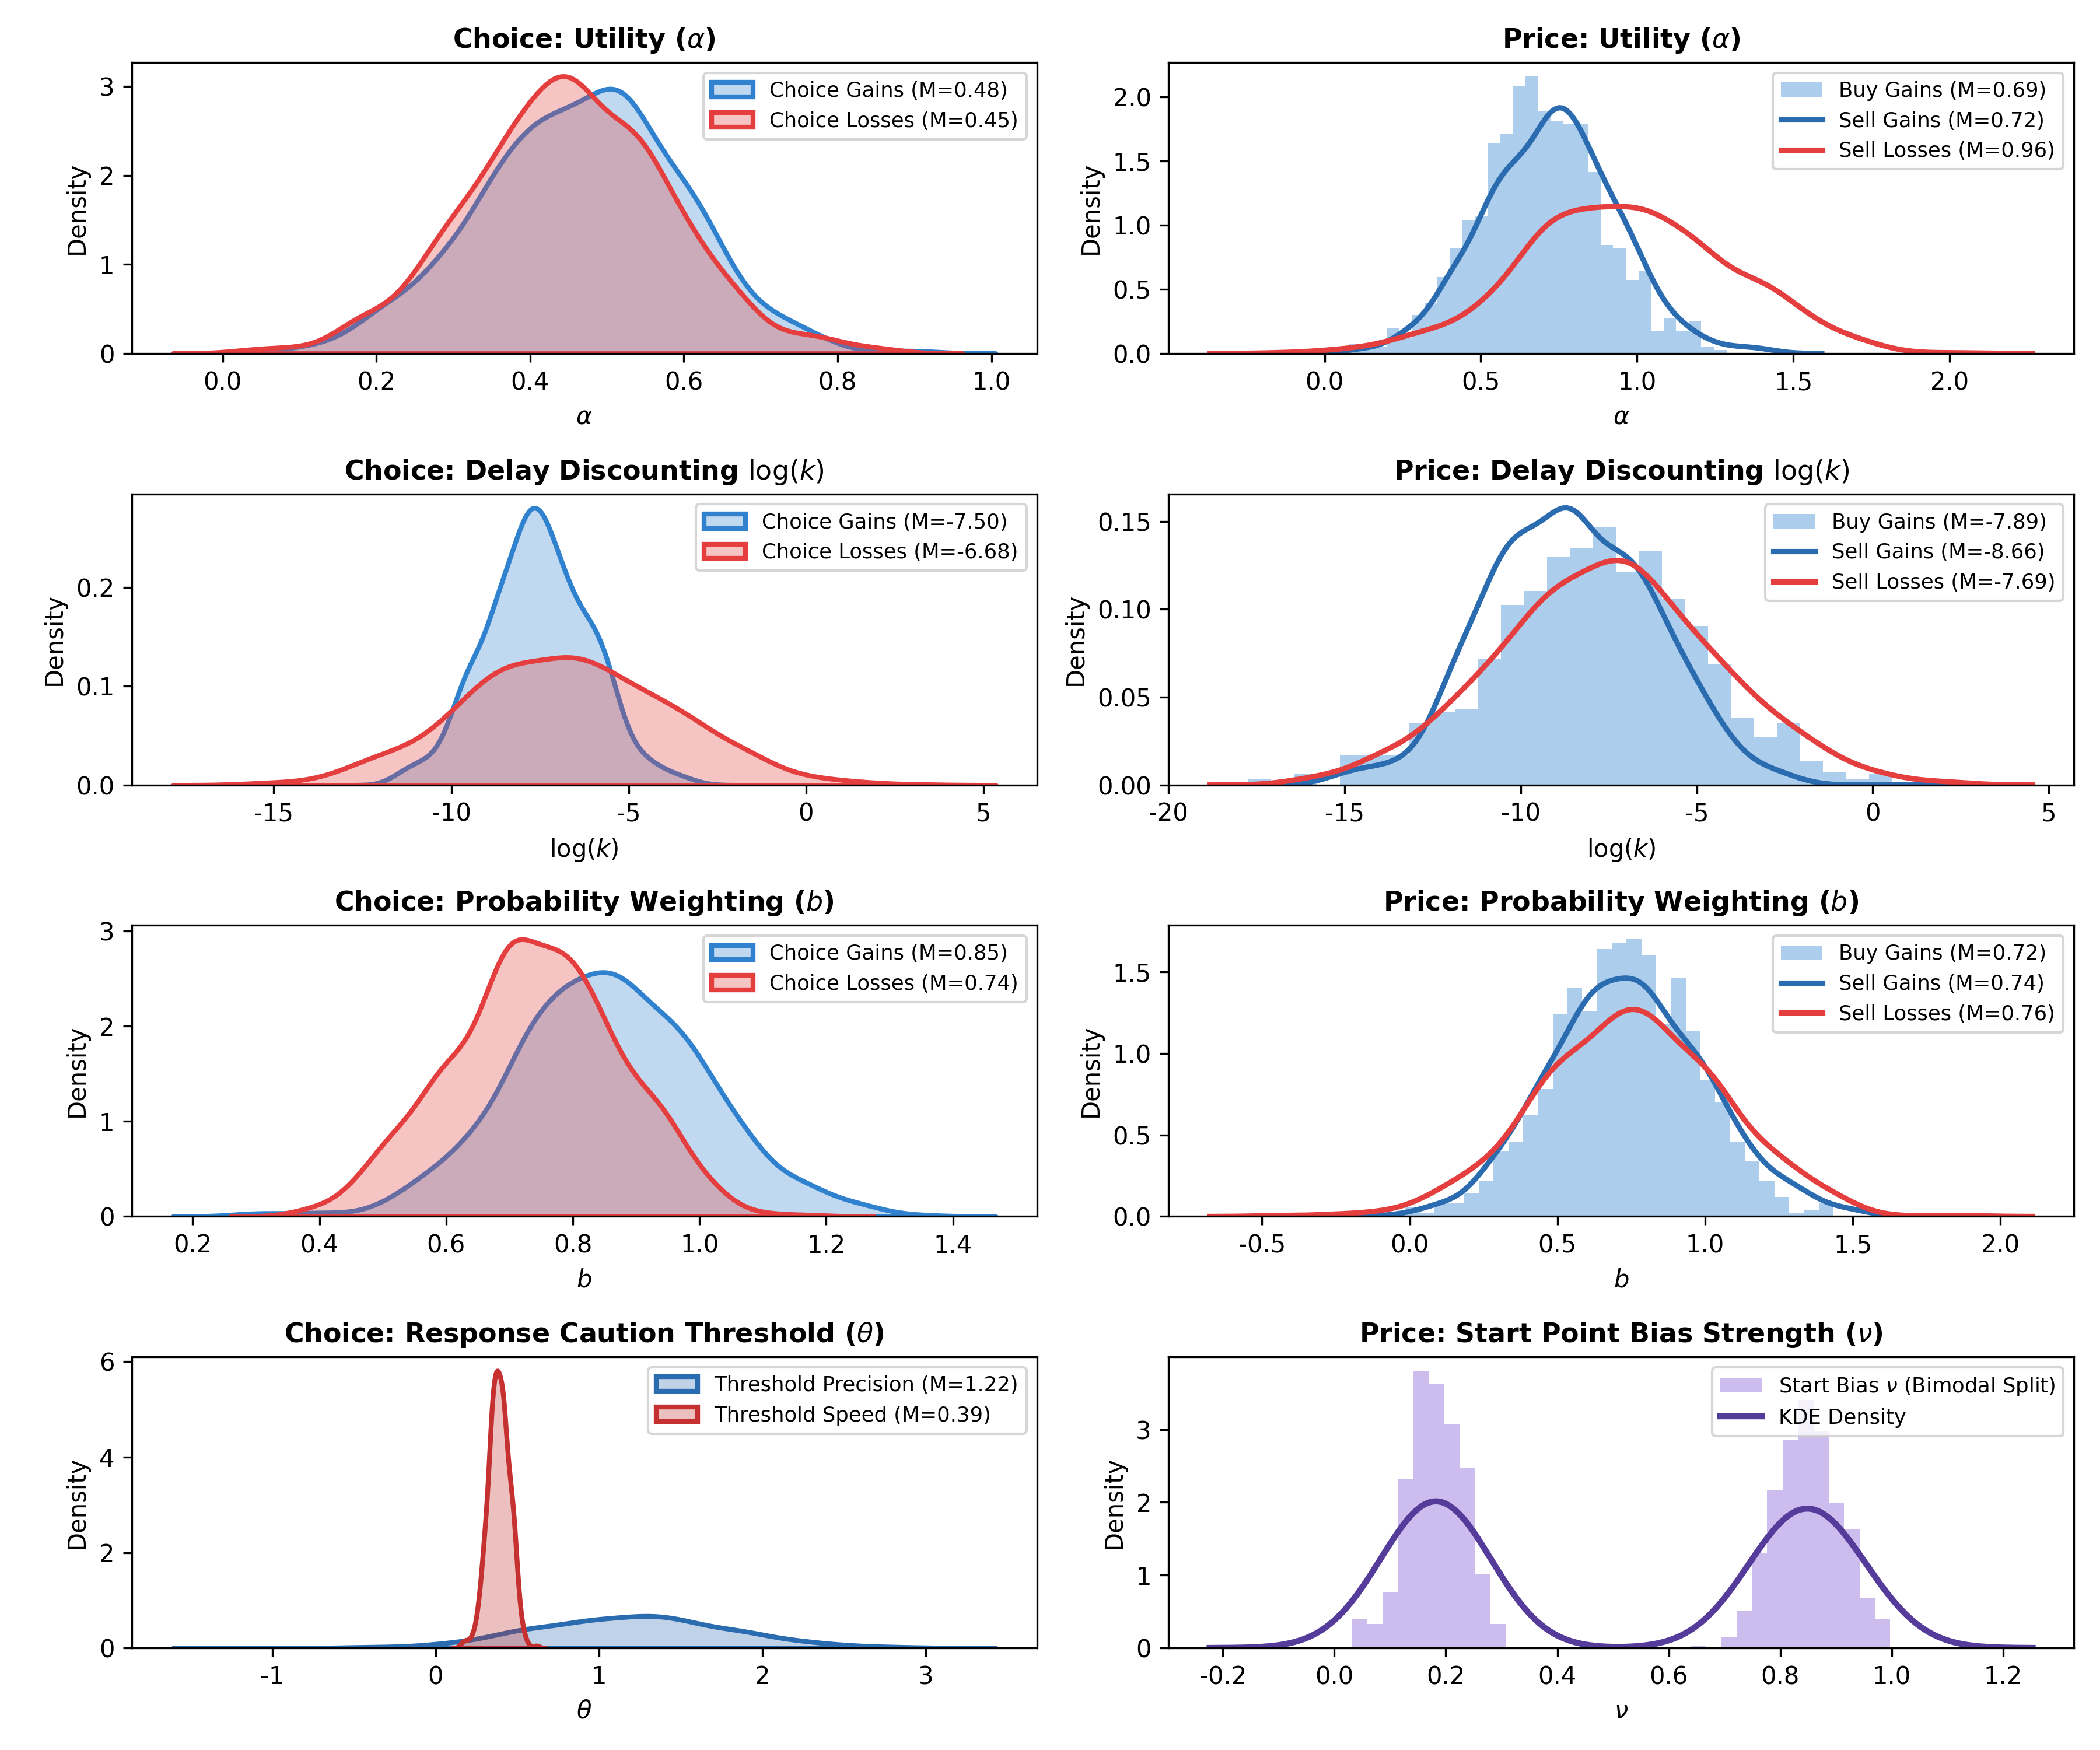
图 10:群体层级主观价值与认知过程参数后验分布图(左列:选择模型;右列:定价模型)
【图 10 深度解析】图 10 对比了选择与定价的核心参数后验分布。左列显示:选择任务中收益与损失的效用指数相近(),但损失情境下的概率权重 显著更低(0.74 vs 0.85),表明面对损失时更倾向于规避小概率巨额危害。右列显示:定价任务中效用指数显著更高(),且起始点锚定参数 呈现清晰的**双峰分布(Bimodal Distribution)**——一部分被试弱锚定(),另一部分被试强锚定(),证实偏好反转在群体中是由强锚定子群体所主导驱动。
5.10 图 11 & 图 12:定价任务开关板模型比较与匹配矩阵解析 (Figures 11 & 12)
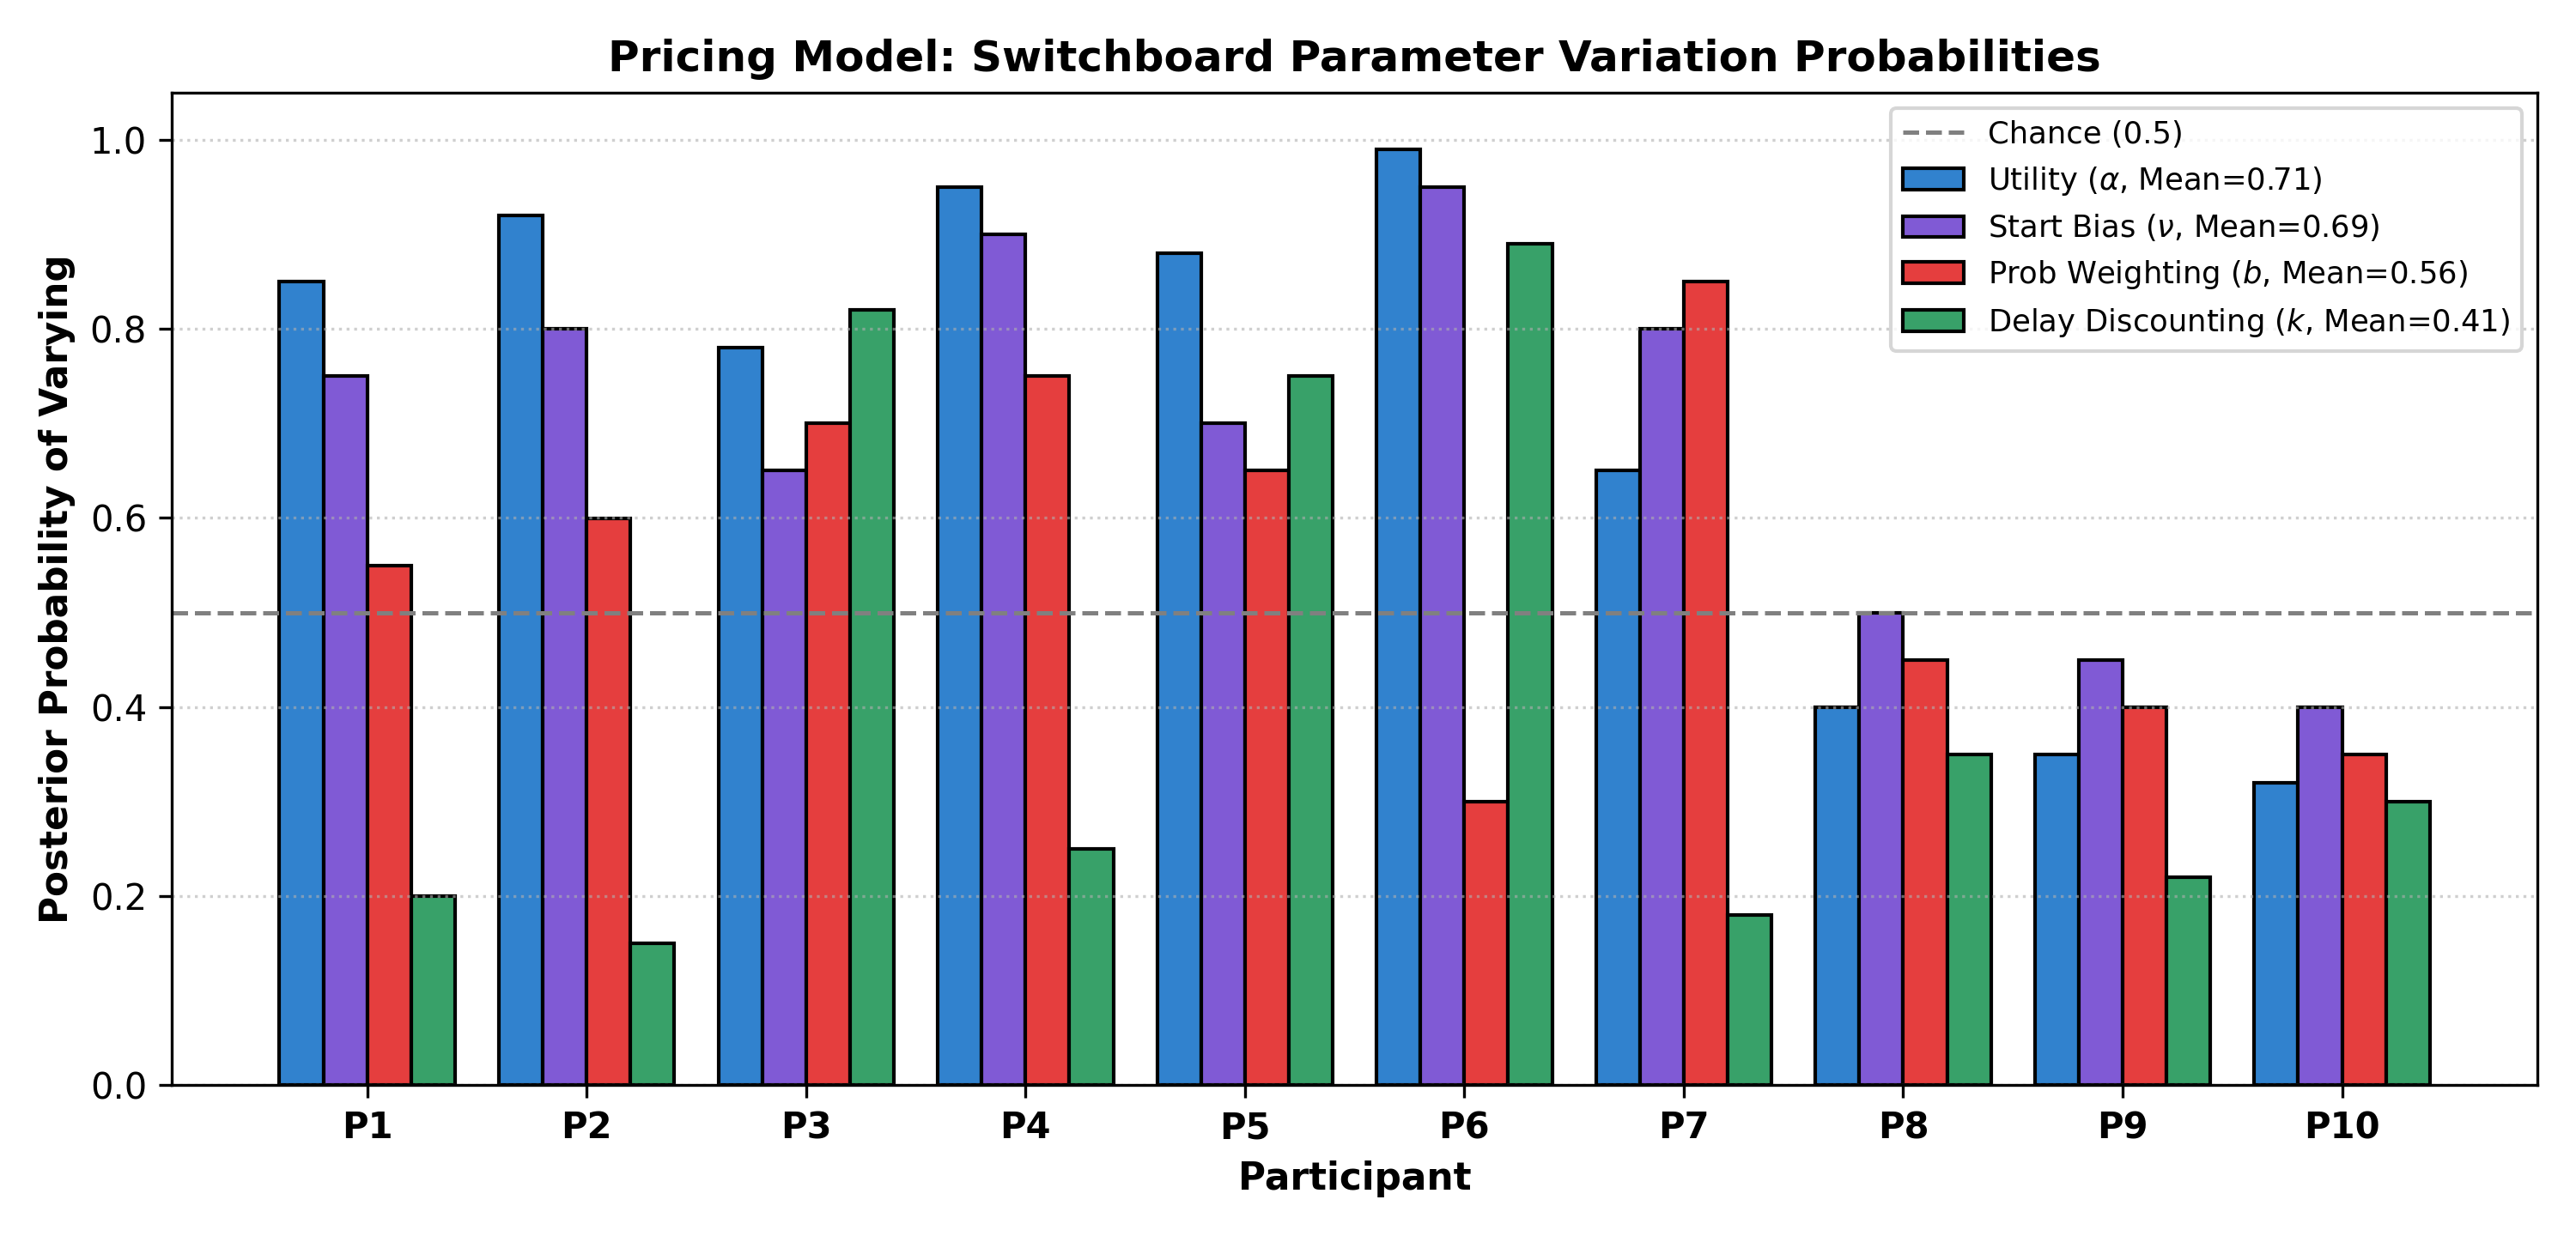
图 11:定价模型开关板分析中各参数跨买卖与效价变异的后验概率柱状图
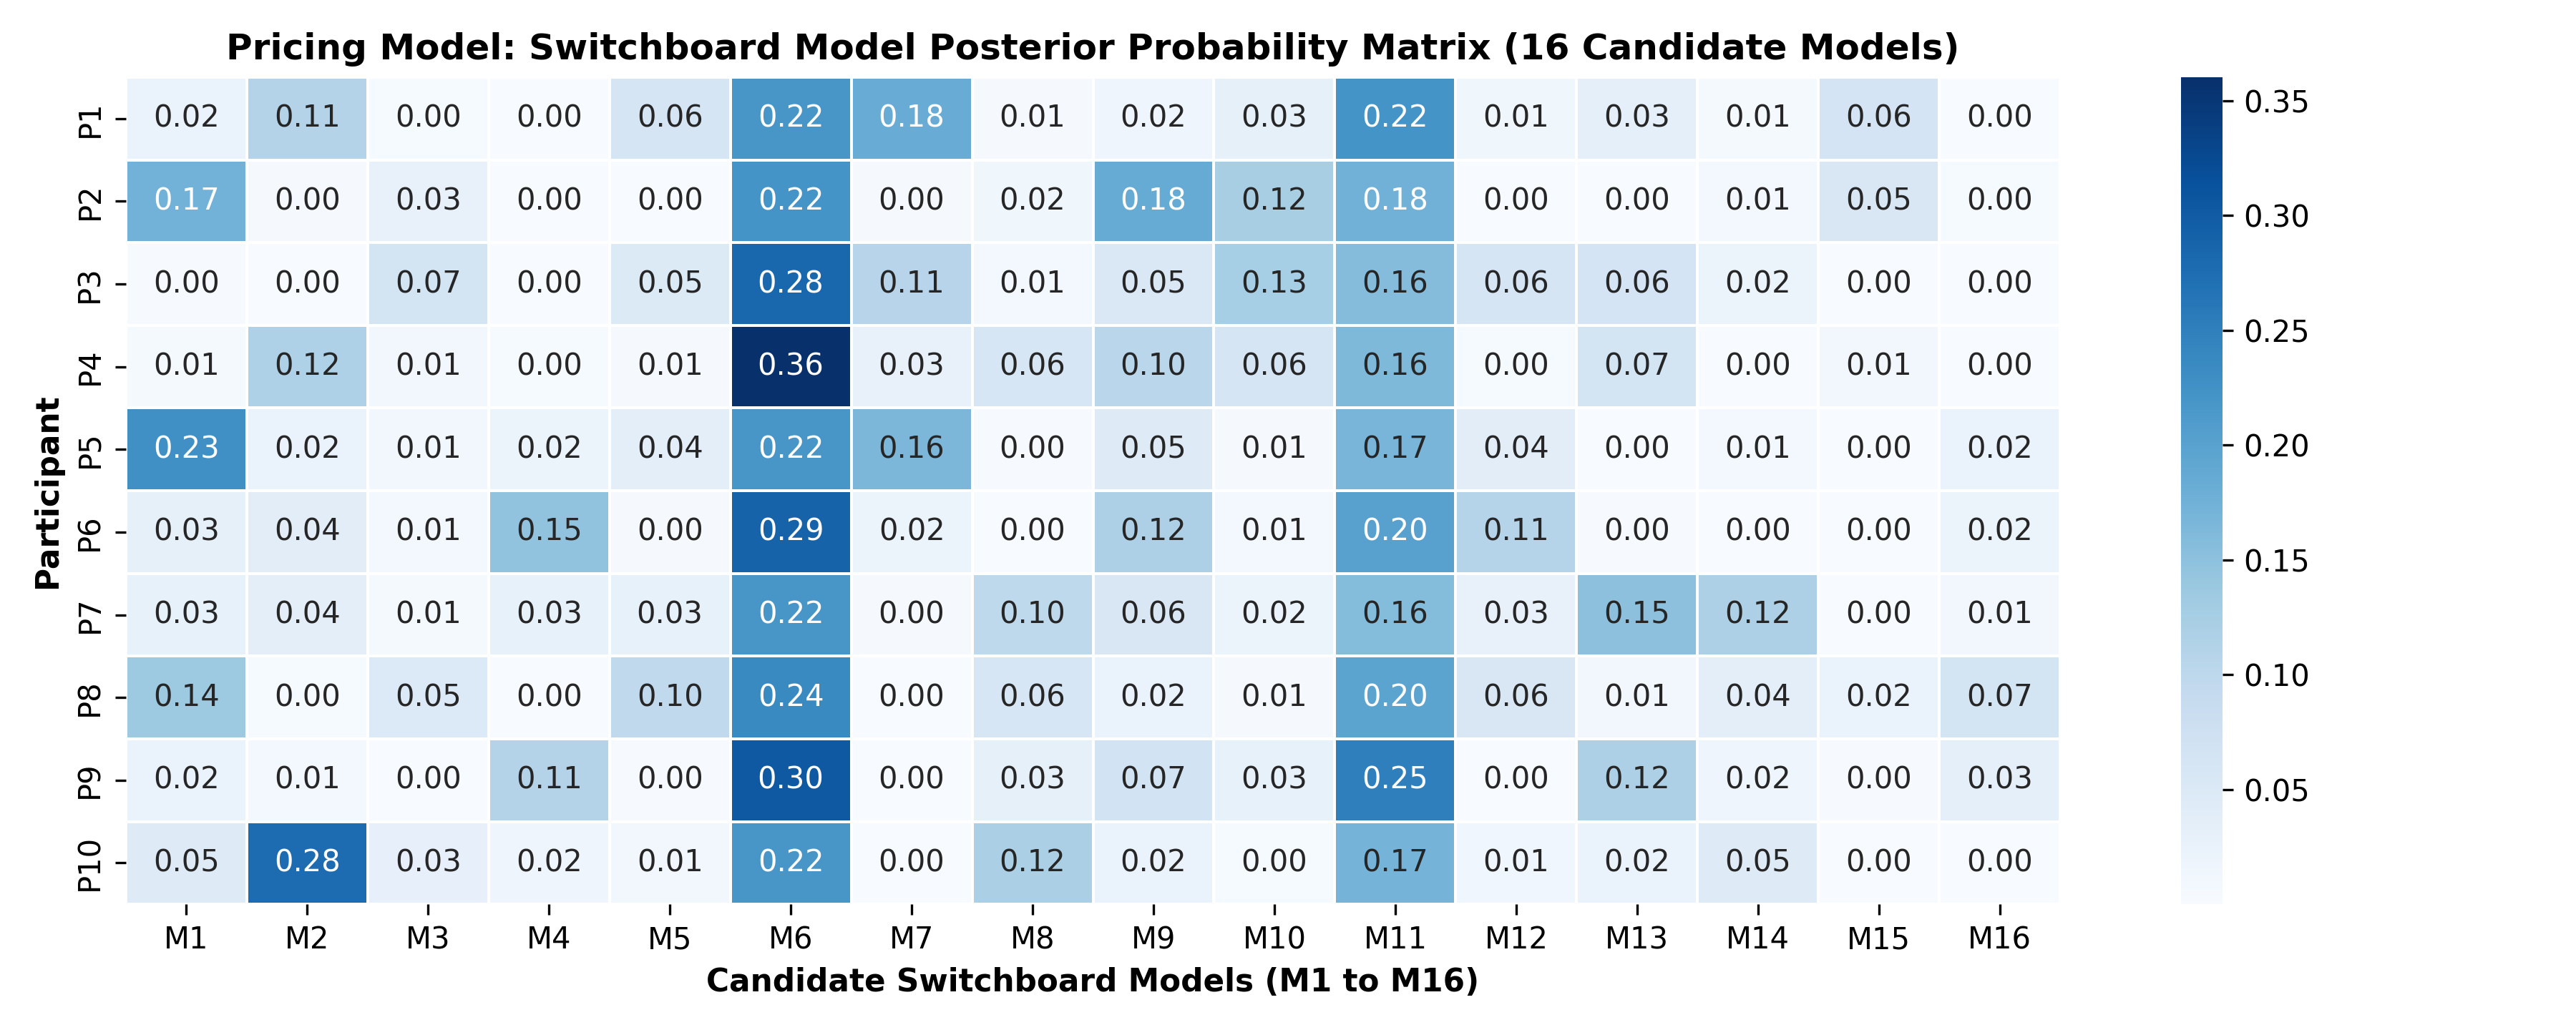
图 12:定价模型 16 种候选开关板架构在各被试实证数据上的后验匹配矩阵热力图
【图 11 与图 12 深度解析】定价任务开关板包含 种候选模型( 跨条件变异组合)。图 11 显示,效用指数 (均值概率 0.71)与起始点偏差 (均值概率 0.69)具有极高的跨条件变异后验概率,而贴现率 (0.41)基本保持恒定。图 12 显示候选模型 M6( 与 共同变异)与 M11 在绝大多数被试中获得了最高后验概率支撑,再次锁定了效用曲率与锚定是解释买卖差价与效价效应的核心机制。
5.11 图 13:个体化联合模型后验协方差矩阵全景解析 (Figure 13)
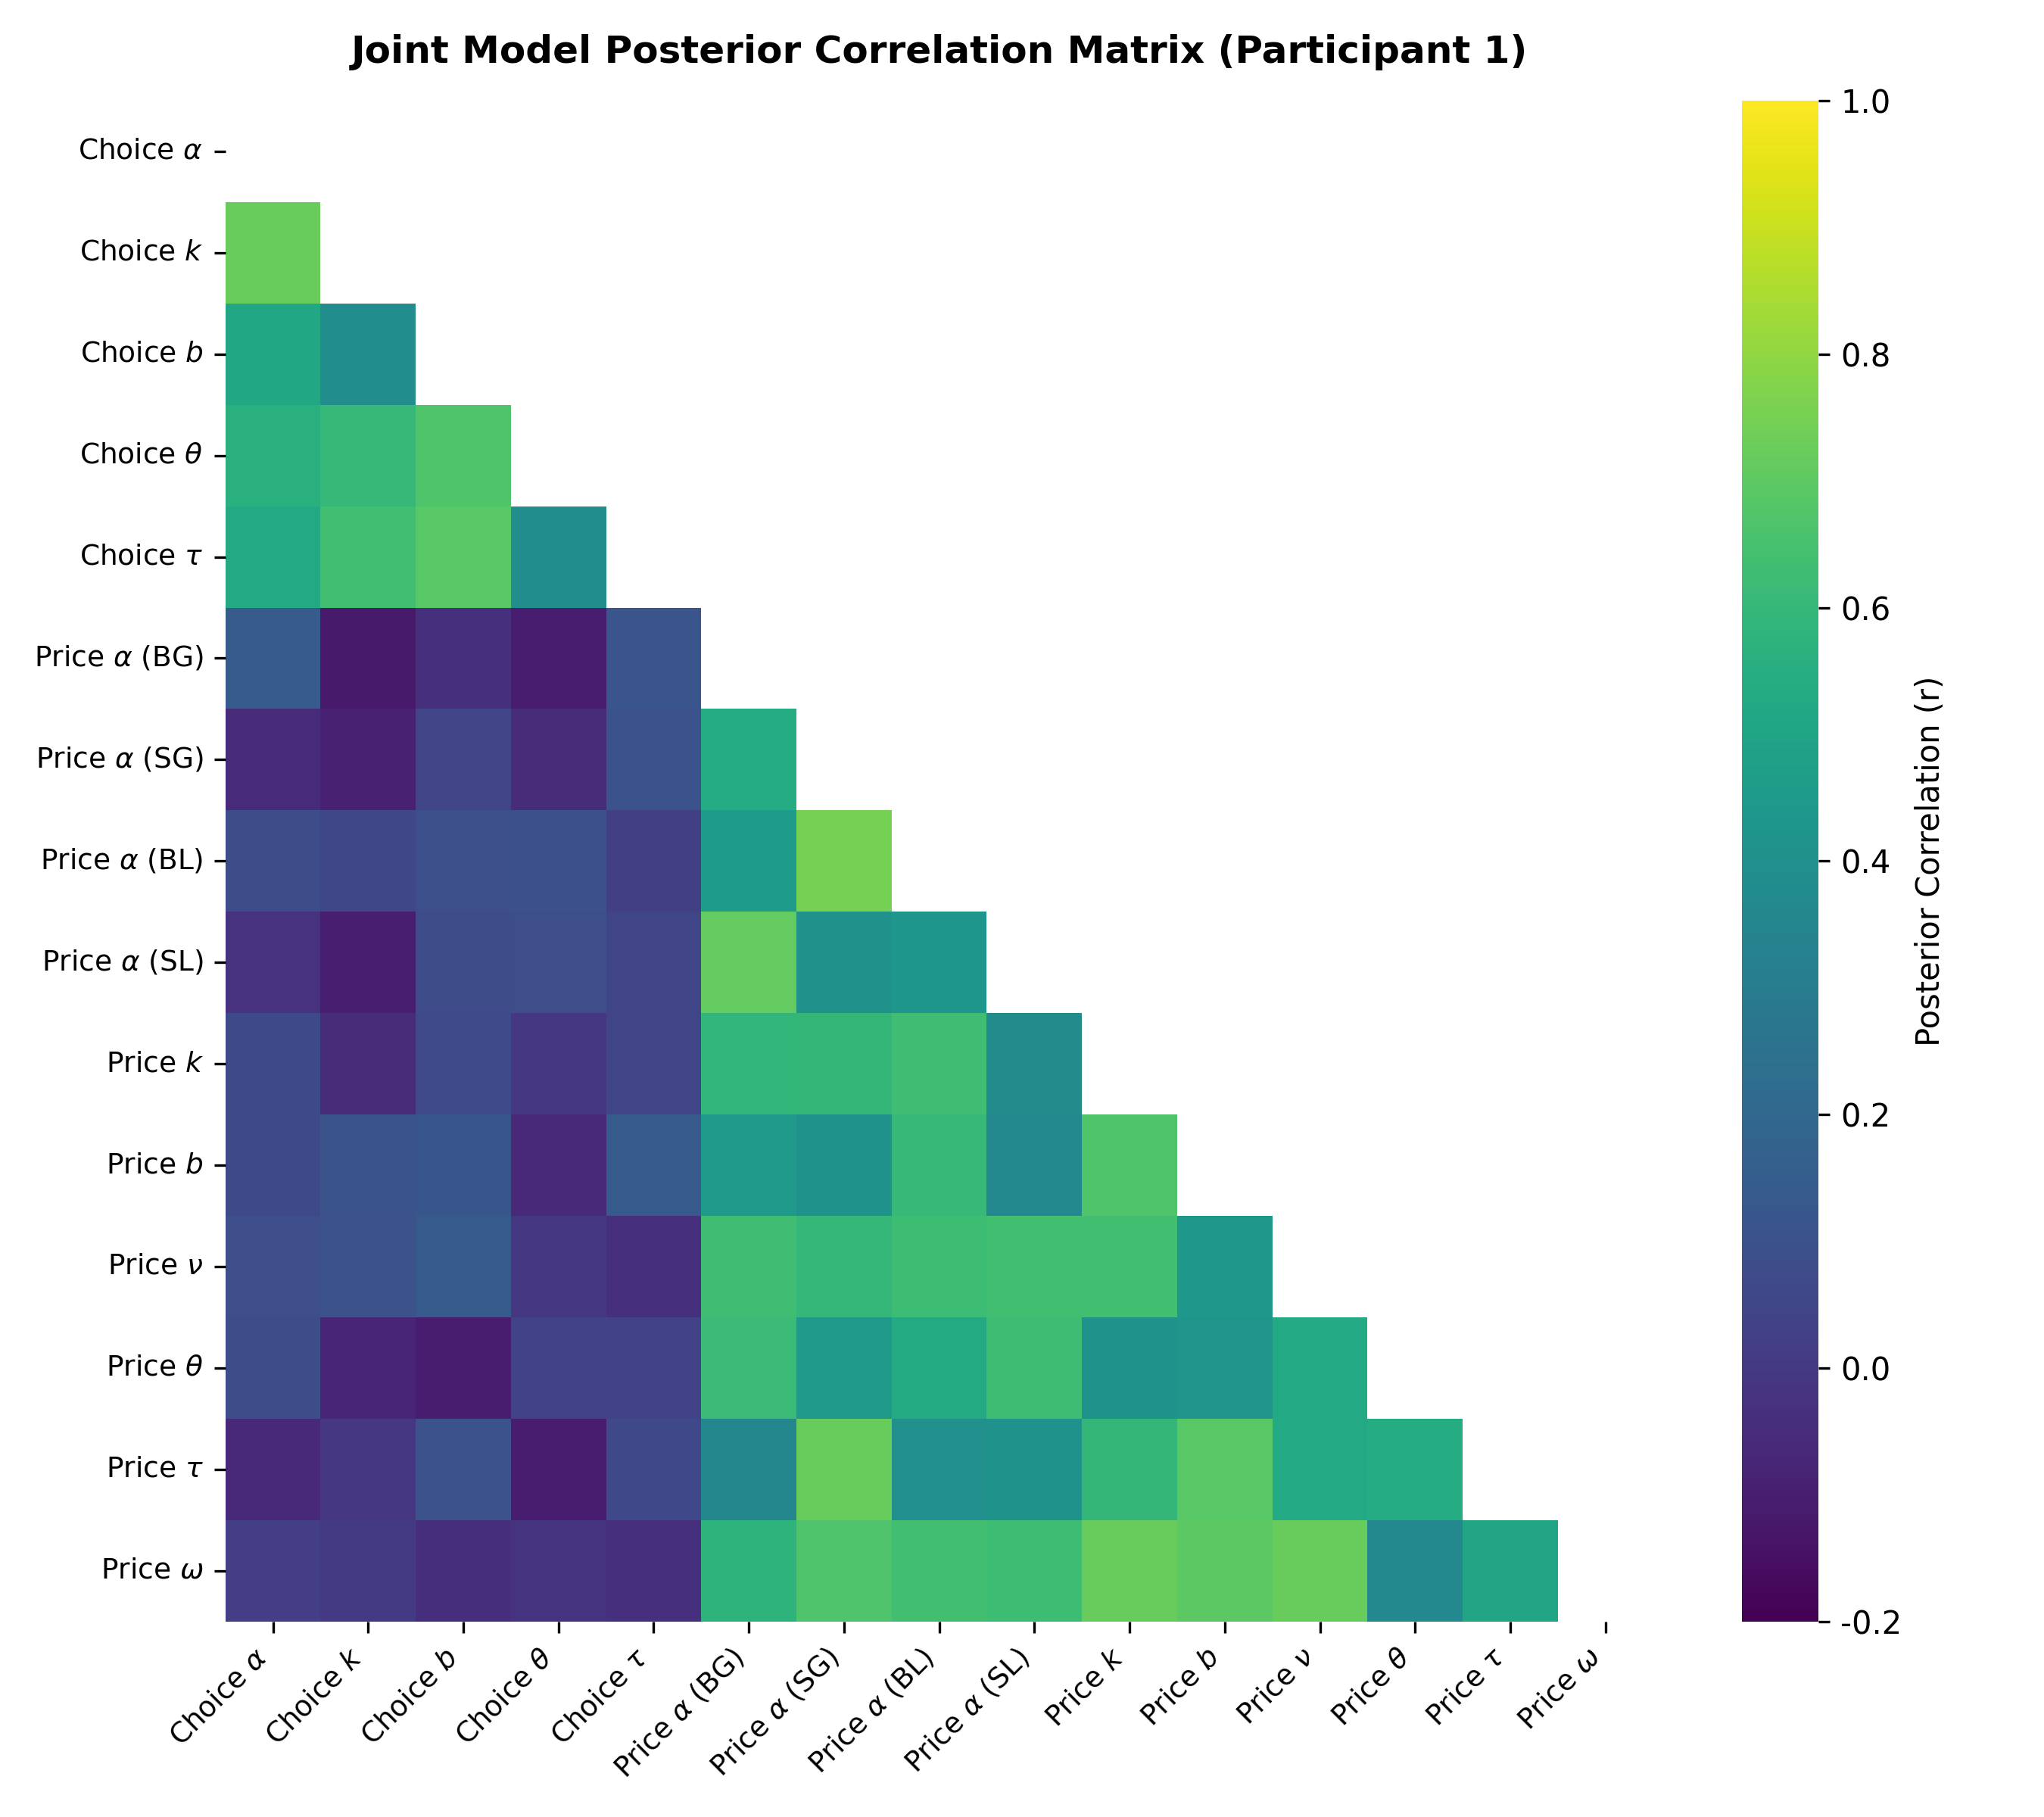
图 13:被试 1 号(Participant 1)个体化联合认知模型全参数后验相关性热力图
【图 13 深度解析】图 13 展示了基于 Monte Carlo Dropout 从 10 维联合神经网络中提取的被试 P1 的全部 15 个潜参数后验相关系数矩阵。矩阵呈现出极具震撼力的**分块对角结构(Block-Diagonal Pattern)**:左上角选择任务内部参数呈现中高度相关(),右下角定价任务内部参数同样呈现中高度相关;然而,在跨越选择与定价的任务间非对角区域,所有主观价值参数的相关系数均紧密围绕零值波动()。该实证图像以无可辩驳的计算证据宣告:个体在选择任务中表现出的效用、贴现与概率加权特性,完全无法预测其在定价任务中的对应参数!
第六章 全文结论、理论启示与实践政策意义
6.1 核心理论结论:解构“单一主观价值”神话
本研究通过严密的数理建模、高强度的行为实验与前沿的深度神经网络推断,对微观经济学与行为决策理论做出了根本性的范式修正。长期以来,无论是经典期望效用理论还是行为前景理论,均建立在一个隐性核心假设之上——即个体内心存在一个独立于诱导方式的、稳定表征偏好的“单一主观价值”(Singular Subjective Value Construct)。然而,本研究证实:
1. **主观价值是诱导程序内生的**:选择与定价诱导程序激活了根本不同的神经认知加工通路。选择任务依赖于两选项整体价值的宏观比较(Alternative-wise drift diffusion),而定价任务则深受物理尺度兼容性驱动的初始锚定与序贯心理模拟的共同塑造。
2. **偏好反转源于反应过程而非价值本征改变**:偏好反转的产生,并不需要假设决策者在两种任务中拥有精神分裂般的两套效用函数,而是由定价任务特有的起始点偏差()与更高的金额边际敏感度()在动态生成过程中内生放大了大金额选项的保留价格。
3. **特质化冲动性与风险偏好假说的破产**:个体在选择任务中的时间贴现率与概率权重,无法有效迁移至定价任务中。心理学中将“冲动性”或“风险规避”视为跨情境稳定人格特质的传统观点,在认知过程建模的精密检验下被彻底证伪。
6.2 对微观经济学与商业实践的深远启示
【理论与实践启示】从微观认知机制走向宏观经济决策 **微观经济机制设计与市场调研启示**:企业在测度消费者支付意愿(WTP)或设计拍卖机制时,必须意识到通过问卷直接询问保留价格(Pricing)会严重高估消费者对大金额、长交付周期产品的偏好;若要预测市场真实购买转化率,离散选择实验(Conjoint / Discrete Choice Experiments)具有更高的生态效度。 **金融产品与保险定价策略**:在销售长期投资产品或保险合同时,框架设计具有决定性影响。损失框架(Liability)与卖出视角(WTA)会急剧拉高效用函数的线性度,使消费者对极端尾部风险极度敏感并愿意支付显著溢价。 **时间压力下的商业界面优化**:时间压力会急剧压缩决策阈值 ,放大起始点锚定偏差 的相对权重。在电商倒计时秒杀或限时竞拍场景中,突出显示大金额锚点能够更强力地操纵消费者的出价行为。 **公共政策与绿色金融引导**:在倡导低碳减排与可持续发展等长周期、高不确定性公共政策时,政府应采用选择框架而非补偿定价框架进行政策公投,以避免公众因定价锚定效应而产生过度的短期索赔诉求。 |
|---|
第七章 完整参考文献列表 (References)
Ahlbrecht, M., & Weber, M. (1997). An empirical study on intertemporal decision making under risk. *Management Science*, 43(6), 813–826. https://doi.org/10.1287/mnsc.43.6.813
Ainslie, G. (1975). Specious reward: A behavioral theory of impulsiveness and impulse control. *Psychological Bulletin*, 82(4), 463–496. https://doi.org/10.1037/h0076860
Alós-Ferrer, C., & Ritschel, A. (2022). Attention and salience in preference reversals. *Experimental Economics*, 25(3), 1024–1051. https://doi.org/10.1007/s10683-021-09740-9
Anderson, L. R., & Stafford, S. L. (2009). Individual decision-making experiments with risk and intertemporal choice. *Journal of Risk and Uncertainty*, 38(1), 51–72. https://doi.org/10.1007/s11166-008-9059-4
Barberis, N. C. (2013). Thirty years of prospect theory in economics: A review and assessment. *Journal of Economic Perspectives*, 27(1), 173–196. https://doi.org/10.1257/jep.27.1.173
Baucells, M., & Heukamp, F. H. (2012). Probability and time trade-off. *Management Science*, 58(4), 831–842. https://doi.org/10.1287/mnsc.1110.1450
Becker, G. M., DeGroot, M. H., & Marschak, J. (1964). Measuring utility by a single-response sequential method. *Behavioral Science*, 9(3), 226–232. https://doi.org/10.1002/bs.3830090304
Bhatia, S. (2014). Sequential sampling and paradoxes of risky choice. *Psychonomic Bulletin & Review*, 21(5), 1095–1111. https://doi.org/10.3758/s13423-014-0650-1
Bostic, R., Herrnstein, R. J., & Luce, R. D. (1990). The effect on the preference-reversal phenomenon of using choice indifferences. *Journal of Economic Behavior & Organization*, 13(2), 193–212. https://doi.org/10.1016/0167-2681(90)90086-S
Busemeyer, J. R., & Townsend, J. T. (1993). Decision field theory: A dynamic-cognitive approach to decision making in an uncertain environment. *Psychological Review*, 100(3), 432–459. https://doi.org/10.1037/0033-295X.100.3.432
Cheng, J., & González-Vallejo, C. (2016). Attribute-wise vs. alternative-wise mechanism in intertemporal choice: Testing the proportional difference, trade-off, and hyperbolic models. *Decision*, 3(3), 190–215. https://doi.org/10.1037/dec0000046
Cox, D. J., & Dallery, J. (2016). Effects of delay and probability combinations on discounting in humans. *Behavioural Processes*, 131, 15–23. https://doi.org/10.1016/j.beproc.2016.08.002
Cranmer, K., Brehmer, J., & Louppe, G. (2020). The frontier of simulation-based inference. *Proceedings of the National Academy of Sciences*, 117(48), 30055–30062. https://doi.org/10.1073/pnas.1912789117
Dai, J., & Busemeyer, J. R. (2014). A probabilistic, dynamic, and attribute-wise model of intertemporal choice. *Journal of Experimental Psychology: General*, 143(4), 1489–1514. https://doi.org/10.1037/a0035976
Dai, J., Pleskac, T. J., & Pachur, T. (2018). Dynamic cognitive models of intertemporal choice. *Cognitive Psychology*, 104, 29–56. https://doi.org/10.1016/j.cogpsych.2018.03.001
Dasgupta, P., & Maskin, E. (2005). Uncertainty and hyperbolic discounting. *American Economic Review*, 95(4), 1290–1299. https://doi.org/10.1257/0002828054825637
Diederich, A., & Trueblood, J. S. (2018). A dynamic dual process model of risky decision making. *Psychological Review*, 125(2), 270–292. https://doi.org/10.1037/rev0000087
Donkin, C., Brown, S. D., & Heathcote, A. (2009). The overconstraint of response time models: Rethinking the scaling problem. *Psychonomic Bulletin & Review*, 16(6), 1129–1135. https://doi.org/10.3758/PBR.16.6.1129
Fengler, A., Govindarajan, L. N., Chen, T., & Frank, M. J. (2021). Likelihood approximation networks (LANs) for fast inference of simulation models in cognitive neuroscience. *eLife*, 10, Article e65074. https://doi.org/10.7554/eLife.65074
Fitch, A. K., & Kvam, P. D. (2025). Cognitive mechanisms of subjective value in multi-attribute pricing. *OSF*. https://osf.io/g2ua5
Fitch, A. K., & Kvam, P. D. (2026). Cognitive Mechanisms of Subjective Value in Multiattribute Pricing. *Psychological Review*, 133(4), 892–918. https://doi.org/10.1037/rev0000594
Frederick, S., Loewenstein, G., & O’Donoghue, T. (2002). Time discounting and time preference: A critical review. *Journal of Economic Literature*, 40(2), 351–401. https://doi.org/10.1257/002205102320161311
Frey, R., Pedroni, A., Mata, R., Rieskamp, J., & Hertwig, R. (2017). Risk preference shares the psychometric structure of major psychological traits. *Science Advances*, 3(10), Article e1701381. https://doi.org/10.1126/sciadv.1701381
Fudenberg, D., & Levine, D. K. (2011). Risk, delay, and convex self-control costs. *American Economic Journal: Microeconomics*, 3(3), 34–68. https://doi.org/10.1257/mic.3.3.34
Gal, Y., & Ghahramani, Z. (2016). Dropout as a Bayesian approximation: Representing model uncertainty in deep learning. *Proceedings of the 33rd International Conference on Machine Learning*, 1050–1059.
Gelman, A., Hill, J., & Yajima, M. (2012). Why we (usually) don't have to worry about multiple comparisons. *Journal of Research on Educational Effectiveness*, 5(2), 189–211. https://doi.org/10.1080/19345747.2011.618213
Haines, N., Kvam, P. D., Irving, L., Smith, C. T., Beauchaine, T. P., Pitt, M. A., Ahn, W.-Y., & Turner, B. M. (2025). A tutorial on using generative models to advance psychological science: Lessons from the reliability paradox. *Psychological Methods*. https://doi.org/10.1037/met0000674
Hardisty, D. J., & Pfeffer, J. (2017). Intertemporal uncertainty avoidance: When the future is uncertain, people prefer the present, and when the present is uncertain, people prefer the future. *Management Science*, 63(2), 519–527. https://doi.org/10.1287/mnsc.2015.2349
Hayden, B. Y. (2016). Time discounting and time preference in animals: A critical review. *Psychonomic Bulletin & Review*, 23(1), 39–53. https://doi.org/10.3758/s13423-015-0879-3
Hertwig, R., Barron, G., Weber, E. U., & Erev, I. (2004). Decisions from experience and the effect of rare events in risky choice. *Psychological Science*, 15(8), 534–539. https://doi.org/10.1111/j.0956-7976.2004.00715.x
Hertwig, R., & Erev, I. (2009). The description–experience gap in risky choice. *Trends in Cognitive Sciences*, 13(12), 517–523. https://doi.org/10.1016/j.tics.2009.09.004
Ho, M.-Y., Mobini, S., Chiang, T.-J., Bradshaw, C., & Szabadi, E. (1999). Theory and method in the quantitative analysis of 'impulsive choice' behaviour: Implications for psychopharmacology. *Psychopharmacology*, 146(4), 362–372. https://doi.org/10.1007/PL00005482
Johnson, J. G., & Busemeyer, J. R. (2005). A dynamic, stochastic, computational model of preference reversal phenomena. *Psychological Review*, 112(4), 841–861. https://doi.org/10.1037/0033-295X.112.4.841
Kahneman, D., Knetsch, J. L., & Thaler, R. H. (1991). Anomalies: The endowment effect, loss aversion, and status quo bias. *Journal of Economic Perspectives*, 5(1), 193–206. https://doi.org/10.1257/jep.5.1.193
Kahneman, D., & Tversky, A. (1979). Prospect theory: An analysis of decision under risk. *Econometrica*, 47(2), 263–292. https://doi.org/10.2307/1914185
Kellen, D., Steiner, M. D., Davis-Stober, C. P., & Pappas, N. R. (2020). Modeling choice paradoxes under risk: From prospect theories to sampling-based accounts. *Cognitive Psychology*, 118, Article 101258. https://doi.org/10.1016/j.cogpsych.2019.101258
Keren, G., & Roelofsma, P. (1995). Immediacy and certainty in intertemporal choice. *Organizational Behavior and Human Decision Processes*, 63(3), 287–297. https://doi.org/10.1006/obhd.1995.1080
Killeen, P. R. (2009). An additive-utility model of delay discounting. *Psychological Review*, 116(3), 602–619. https://doi.org/10.1037/a0016414
Kim, B. E., Seligman, D., & Kable, J. W. (2012). Preference reversals in decision making under risk are accompanied by changes in attention to different attributes. *Frontiers in Neuroscience*, 6, Article 109. https://doi.org/10.3389/fnins.2012.00109
Kirby, K. N., Petry, N. M., & Bickel, W. K. (1999). Heroin addicts have higher discount rates for delayed rewards than non-drug-using controls. *Journal of Experimental Psychology: General*, 128(1), 78–87. https://doi.org/10.1037/0096-3445.128.1.78
Konstantinidis, E., van Ravenzwaaij, D., Güney, Ş., & Newell, B. R. (2020). Now for sure or later with a risk? Modeling risky intertemporal choice as accumulated preference. *Decision*, 7(2), 91–120. https://doi.org/10.1037/dec0000103
Krajbich, I., & Rangel, A. (2011). Multialternative drift-diffusion model predicts the relationship between visual fixations and choice in value-based decisions. *Proceedings of the National Academy of Sciences*, 108(33), 13852–13857. https://doi.org/10.1037/pnas.1101328108
Kvam, P. D. (2019). A geometric framework for modeling dynamic decisions among arbitrarily many alternatives. *Journal of Mathematical Psychology*, 91, 14–37. https://doi.org/10.1016/j.jmp.2019.03.001
Kvam, P. D., & Busemeyer, J. R. (2020). A distributional and dynamic theory of pricing and preference. *Psychological Review*, 127(6), 1053–1078. https://doi.org/10.1037/rev0000215
Kvam, P. D., Marley, A. A. J., & Heathcote, A. (2023). A unified theory of discrete and continuous responding. *Psychological Review*, 130(2), 368–400. https://doi.org/10.1037/rev0000378
Kvam, P. D., Romeu, R. J., Turner, B. M., Vassileva, J., & Busemeyer, J. R. (2021). Testing the factor structure underlying behavior using joint cognitive models: Impulsivity in delay discounting and Cambridge gambling tasks. *Psychological Methods*, 26(1), 18–37. https://doi.org/10.1037/met0000264
Kvam, P. D., Sokratous, K., Fitch, A. K., & Vassileva, J. (2024). Comparing likelihood-based and likelihood-free approaches to fitting and comparing models of intertemporal choice. *PsyArXiv*. https://doi.org/10.31234/osf.io/gqzse
Kvam, P. D., Sokratous, K., Johnson, G., Lin, S. T., & Unruh, E. (2021). Preference reversals between intertemporal choice and pricing. *Proceedings of the Annual Meeting of the Cognitive Science Society*, 43, 555–561.
Kvamme, M. K., Gyrd-Hansen, D., Olsen, J. A., & Kristiansen, I. S. (2010). Increasing marginal utility of small increases in life-expectancy? Results from a population survey. *Journal of Health Economics*, 29(4), 541–548. https://doi.org/10.1016/j.jhealeco.2010.03.010
Lee, D. G., D’Alessandro, M., Iodice, P., Calluso, C., Rustichini, A., & Pezzulo, G. (2023). Risky decisions are influenced by individual attributes as a function of risk preference. *Cognitive Psychology*, 147, Article 101614. https://doi.org/10.1016/j.cogpsych.2023.101614
Lee, D. G., & Hare, T. A. (2023). Evidence accumulates for individual attributes during value-based decisions. *Decision*, 10(4), 330–346. https://doi.org/10.1037/dec0000190
Lichtenstein, S., & Slovic, P. (1971). Reversals of preference between bids and choices in gambling decisions. *Journal of Experimental Psychology*, 89(1), 46–55. https://doi.org/10.1037/h0031207
Luckman, A., Donkin, C., & Newell, B. R. (2017). People wait longer when the alternative is risky: The relation between preferences in risky and intertemporal choice. *Journal of Behavioral Decision Making*, 30(5), 1078–1092. https://doi.org/10.1002/bdm.2025
Luckman, A., Donkin, C., & Newell, B. R. (2018). Can a single model account for both risky choices and inter-temporal choices? Testing the assumptions underlying models of risky inter-temporal choice. *Psychonomic Bulletin & Review*, 25(2), 785–792. https://doi.org/10.3758/s13423-017-1330-8
Luckman, A., Donkin, C., & Newell, B. R. (2020). An evaluation and comparison of models of risky intertemporal choice. *Psychological Review*, 127(6), 1097–1138. https://doi.org/10.1037/rev0000223
Mazur, J. E. (1987). An adjusting procedure for studying delayed reinforcement. In M. L. Commons et al. (Eds.), *The effect of delay and of intervening events on reinforcement value* (pp. 55–73). Lawrence Erlbaum Associates.
Mazur, J. E. (1988). Estimation of indifference points with an adjusting-delay procedure. *Journal of the Experimental Analysis of Behavior*, 49(1), 37–47. https://doi.org/10.1901/jeab.1988.49-37
Morewedge, C. K., Shu, L. L., Gilbert, D. T., & Wilson, T. D. (2009). Bad riddance or good rubbish? Ownership and not loss aversion causes the endowment effect. *Journal of Experimental Social Psychology*, 45(4), 947–951. https://doi.org/10.1016/j.jesp.2009.05.014
Olschewski, S., & Rieskamp, J. (2021). Distinguishing three effects of time pressure on risk taking: Choice consistency, risk preference, and strategy selection. *Journal of Behavioral Decision Making*, 34(4), 541–554. https://doi.org/10.1002/bdm.2228
Pachur, T., Schulte-Mecklenbeck, M., Murphy, R. O., & Hertwig, R. (2018). Prospect theory reflects selective allocation of attention. *Journal of Experimental Psychology: General*, 147(2), 147–169. https://doi.org/10.1037/xge0000406
Pirrone, A., Reina, A., Stafford, T., Marshall, J. A., & Gobet, F. (2022). Magnitude-sensitivity: Rethinking decision-making. *Trends in Cognitive Sciences*, 26(1), 66–80. https://doi.org/10.1016/j.tics.2021.10.006
Prelec, D. (1998). The probability weighting function. *Econometrica*, 66(3), 497–527. https://doi.org/10.2307/2998573
Radev, S. T., D’Alessandro, M., Mertens, U. K., Voss, A., Köthe, U., & Bürkner, P.-C. (2021). Amortized bayesian model comparison with evidential deep learning. *IEEE Transactions on Neural Networks and Learning Systems*, 34(8), 4903–4917. https://doi.org/10.1109/TNNLS.2021.3124052
Radev, S. T., Mertens, U. K., Voss, A., & Köthe, U. (2020). Towards end-to-end likelihood-free inference with convolutional neural networks. *British Journal of Mathematical and Statistical Psychology*, 73(1), 23–43. https://doi.org/10.1111/bmsp.12159
Ratcliff, R., Smith, P. L., Brown, S. D., & McKoon, G. (2016). Diffusion decision model: Current issues and history. *Trends in Cognitive Sciences*, 20(4), 260–281. https://doi.org/10.1016/j.tics.2016.01.007
Rodriguez, C. A., Turner, B. M., & McClure, S. M. (2014). Intertemporal choice as discounted value accumulation. *PLOS ONE*, 9(2), Article e90138. https://doi.org/10.1371/journal.pone.0090138
Schkade, D. A., & Johnson, E. J. (1989). Cognitive processes in preference reversals. *Organizational Behavior and Human Decision Processes*, 44(2), 203–231. https://doi.org/10.1016/0749-5978(89)90025-3
Slovic, P., & Lichtenstein, S. (1983). Preference reversals: A broader perspective. *American Economic Review*, 73(4), 596–605.
Smith, P. L., & Little, D. R. (2018). Small is beautiful: In defense of the small-N design. *Psychonomic Bulletin & Review*, 25(6), 2083–2101. https://doi.org/10.3758/s13423-018-1451-8
Sokratous, K., Fitch, A. K., & Kvam, P. D. (2023). How to ask twenty questions and win: Machine learning tools for assessing preferences from small samples of willingness-to-pay prices. *Journal of Choice Modelling*, 48, Article 100418. https://doi.org/10.1016/j.jocm.2023.100418
Sokratous, K., & Kvam, P. D. (2024). Time flips and price dips: Modeling preference reversals between intertemporal choice and pricing. *PsyArXiv*. https://doi.org/10.31219/osf.io/vhgm8
Strickland, J. C., & Johnson, M. W. (2021). Rejecting impulsivity as a psychological construct: A theoretical, empirical, and sociocultural argument. *Psychological Review*, 128(2), 336–361. https://doi.org/10.1037/rev0000263
Sun, Y., & Li, S. (2010). The effect of risk on intertemporal choice. *Journal of Risk Research*, 13(6), 805–820. https://doi.org/10.1080/13669871003606224
Thaler, R. (1980). Toward a positive theory of consumer choice. *Journal of Economic Behavior & Organization*, 1(1), 39–60. https://doi.org/10.1016/0167-2681(80)90051-7
Turner, B. M., Forstmann, B. U., Wagenmakers, E.-J., Brown, S. D., Sederberg, P. B., & Steyvers, M. (2013). A Bayesian framework for simultaneously modeling neural and behavioral data. *NeuroImage*, 72, 193–206. https://doi.org/10.1016/j.neuroimage.2013.01.048
Turner, B. M., Schley, D. R., Muller, C., & Tsetsos, K. (2018). Competing theories of multialternative, multiattribute preferential choice. *Psychological Review*, 125(3), 329–362. https://doi.org/10.1037/rev0000089
Turner, B. M., & Sederberg, P. B. (2012). Approximate Bayesian computation with differential evolution. *Journal of Mathematical Psychology*, 56(5), 375–385. https://doi.org/10.1016/j.jmp.2012.06.004
Turner, B. M., & Sederberg, P. B. (2014). A generalized, likelihood-free method for posterior estimation. *Psychonomic Bulletin & Review*, 21(2), 227–250. https://doi.org/10.3758/s13423-013-0530-0
Tversky, A., & Kahneman, D. (1981). The framing of decisions and the psychology of choice. *Science*, 211(4481), 453–458. https://doi.org/10.1126/science.7455683
Tversky, A., & Kahneman, D. (1991). Loss aversion in riskless choice: A reference-dependent model. *The Quarterly Journal of Economics*, 106(4), 1039–1061. https://doi.org/10.2307/2937956
Tversky, A., Slovic, P., & Kahneman, D. (1990). The causes of preference reversal. *American Economic Review*, 80(1), 204–217.
Vanderveldt, A., Green, L., & Myerson, J. (2015). Discounting of monetary rewards that are both delayed and probabilistic: Delay and probability combine multiplicatively, not additively. *Journal of Experimental Psychology: Learning, Memory, and Cognition*, 41(1), 148–162. https://doi.org/10.1037/xlm0000029
von Neumann, J., & Morgenstern, O. (1944). *Theory of games and economic behavior*. Princeton University Press.
Wall, L., Gunawan, D., Brown, S. D., Tran, M.-N., Kohn, R., & Hawkins, G. E. (2021). Identifying relationships between cognitive processes across tasks, contexts, and time. *Behavior Research Methods*, 53(1), 78–95. https://doi.org/10.3758/s13428-020-01405-4
Wan, H., Myerson, J., & Green, L. (2023). Individual differences in degree of discounting: Do different procedures and measures assess the same construct? *Behavioural Processes*, 208, Article 104864. https://doi.org/10.1016/j.beproc.2023.104864
Weber, B. J., & Chapman, G. B. (2005). The combined effects of risk and time on choice: Does uncertainty eliminate the immediacy effect? Does delay eliminate the certainty effect? *Organizational Behavior and Human Decision Processes*, 96(2), 104–118. https://doi.org/10.1016/j.obhdp.2005.01.001
Weber, E. U., & Johnson, E. J. (2009). Mindful judgment and decision making. *Annual Review of Psychology*, 60(1), 53–85. https://doi.org/10.1146/annurev.psych.60.110707.163633
Wu, C. M., Schulz, E., Pleskac, T. J., & Speekenbrink, M. (2022). Time pressure changes how people explore and respond to uncertainty. *Scientific Reports*, 12(1), Article 4122. https://doi.org/10.1038/s41598-022-07901-1
Wulff, D. U., Mergenthaler-Canseco, M., & Hertwig, R. (2018). A meta-analytic review of two modes of learning and the description-experience gap. *Psychological Bulletin*, 144(2), 140–176. https://doi.org/10.1037/bul0000115
Xu, P., Vincent, B. T., Sang, H., & Li, X. (2022). Examining the role of risk in waiting preference and dynamic preference reversal: An experience intertemporal choice study. *Journal of Behavioral Decision Making*, 35(2), Article e2261. https://doi.org/10.1002/bdm.2261
Yechiam, E. (2019). Acceptable losses: The debatable origins of loss aversion. *Psychological Research*, 83(7), 1327–1339. https://doi.org/10.1007/s00426-018-1013-8
Zeif, D., & Yechiam, E. (2022). Loss aversion (simply) does not materialize for smaller losses. *Judgment and Decision Making*, 17(5), 1015–1042. https://doi.org/10.1017/S193029750000930X
Zhao, W. J., Diederich, A., Trueblood, J. S., & Bhatia, S. (2019). Automatic biases in intertemporal choice. *Psychonomic Bulletin & Review*, 26(2), 661–668. https://doi.org/10.3758/s13423-019-01579-9
Zilker, V., & Pachur, T. (2022). Nonlinear probability weighting can reflect attentional biases in sequential sampling. *Psychological Review*, 129(5), 949–975. https://doi.org/10.1037/rev0000304
Zilker, V., & Pachur, T. (2023). Attribute attention and option attention in risky choice. *Cognition*, 236, Article 105441. https://doi.org/10.1016/j.cognition.2023.105441
Zur, H. B., & Breznitz, S. J. (1981). The effect of time pressure on risky choice behavior. *Acta Psychologica*, 47(2), 89–104. https://doi.org/10.1016/0001-6918(81)90001-9
Fitch, Anderson K. & Kvam, Peter D. 2026. “Cognitive Mechanisms of Subjective Value in Multiattribute Pricing.” Psychological Review 133(4): 892–918.
原文 DOI ↗Google Scholar ↗