基于情境与可分需求模型的动态定价:
数理建模、在线学习算法与统计复杂度全景深度解析
Context-Based Dynamic Pricing with Separable Demand Models
Authors: Jinzhi Bu, David Simchi-Levi, Chonghuan Wang · Management
Science (2026)
【文献出版与分类档案元数据】 【英文原题】Context-Based Dynamic Pricing with Separable Demand Models 【论文作者】Jinzhi Bu (The Hong Kong Polytechnic University), David Simchi-Levi (Massachusetts Institute of Technology), Chonghuan Wang (The University of Texas at Dallas) 【发表期刊】Management Science, Vol. 72, No. 8 (August 2026), pp. 7279–7298 【数字对象标识符 (DOI)】https://doi.org/10.1287/mnsc.2022.02260 【JEL 分类号】C44 (Operations Research; Statistical Decision Theory), C14 (Semiparametric and Nonparametric Methods), D42 (Monopoly Pricing), D83 (Search; Learning; Information and Knowledge), L81 (Retail and Wholesale Trades; e-Commerce), M31 (Marketing: Pricing and Revenue Management) 【核心关键词】可分模型 (Separable Model)、动态定价 (Dynamic Pricing)、情境信息 (Contextual Information)、在线学习 (Online Learning)、后悔界分析 (Regret Bounds)、统计复杂度 (Statistical Complexity) |
|---|
一、研究背景、产业实践动机与核心学术贡献
1.1 现实商业背景:中东头部消费电子零售商的数据特征与长尾挑战
产业实践痛点:在现代电子商务与零售平台中,企业拥有海量的外生环境情境数据(Contextual Information,即协变量 ),如商品物理属性、时间季节性、促销节日、宏观经济指数以及竞争对手的实时价格。企业面临的核心挑战是如何利用这些高维情境信息进行动态定价,以最大化全时域的期望累积收益。然而,真实商业场景中存在严重的长尾效应与低销量困境。
本文的研究直接源于作者团队与中东地区一家领先的大型消费电子零售商的深度产业合作(Li et al. 2023)。该企业每两天为一个销售周期,针对手机、笔记本电脑等数码产品依据历史销量与外生特征动态调整价格。研究团队对该企业 2000 个手机 SKU(Stock Keeping Units)跨越三年的真实交易数据进行了系统分析,发现高达 83% 的 SKU 在每个销售周期内的平均销量不足 5 件!这种极度普遍的低销量长尾特征使得单个 SKU 能够提供的历史需求样本极其稀疏,导致企业难以从单一产品的有限数据中准确辨识真实的价格弹性(Price Elasticity)。
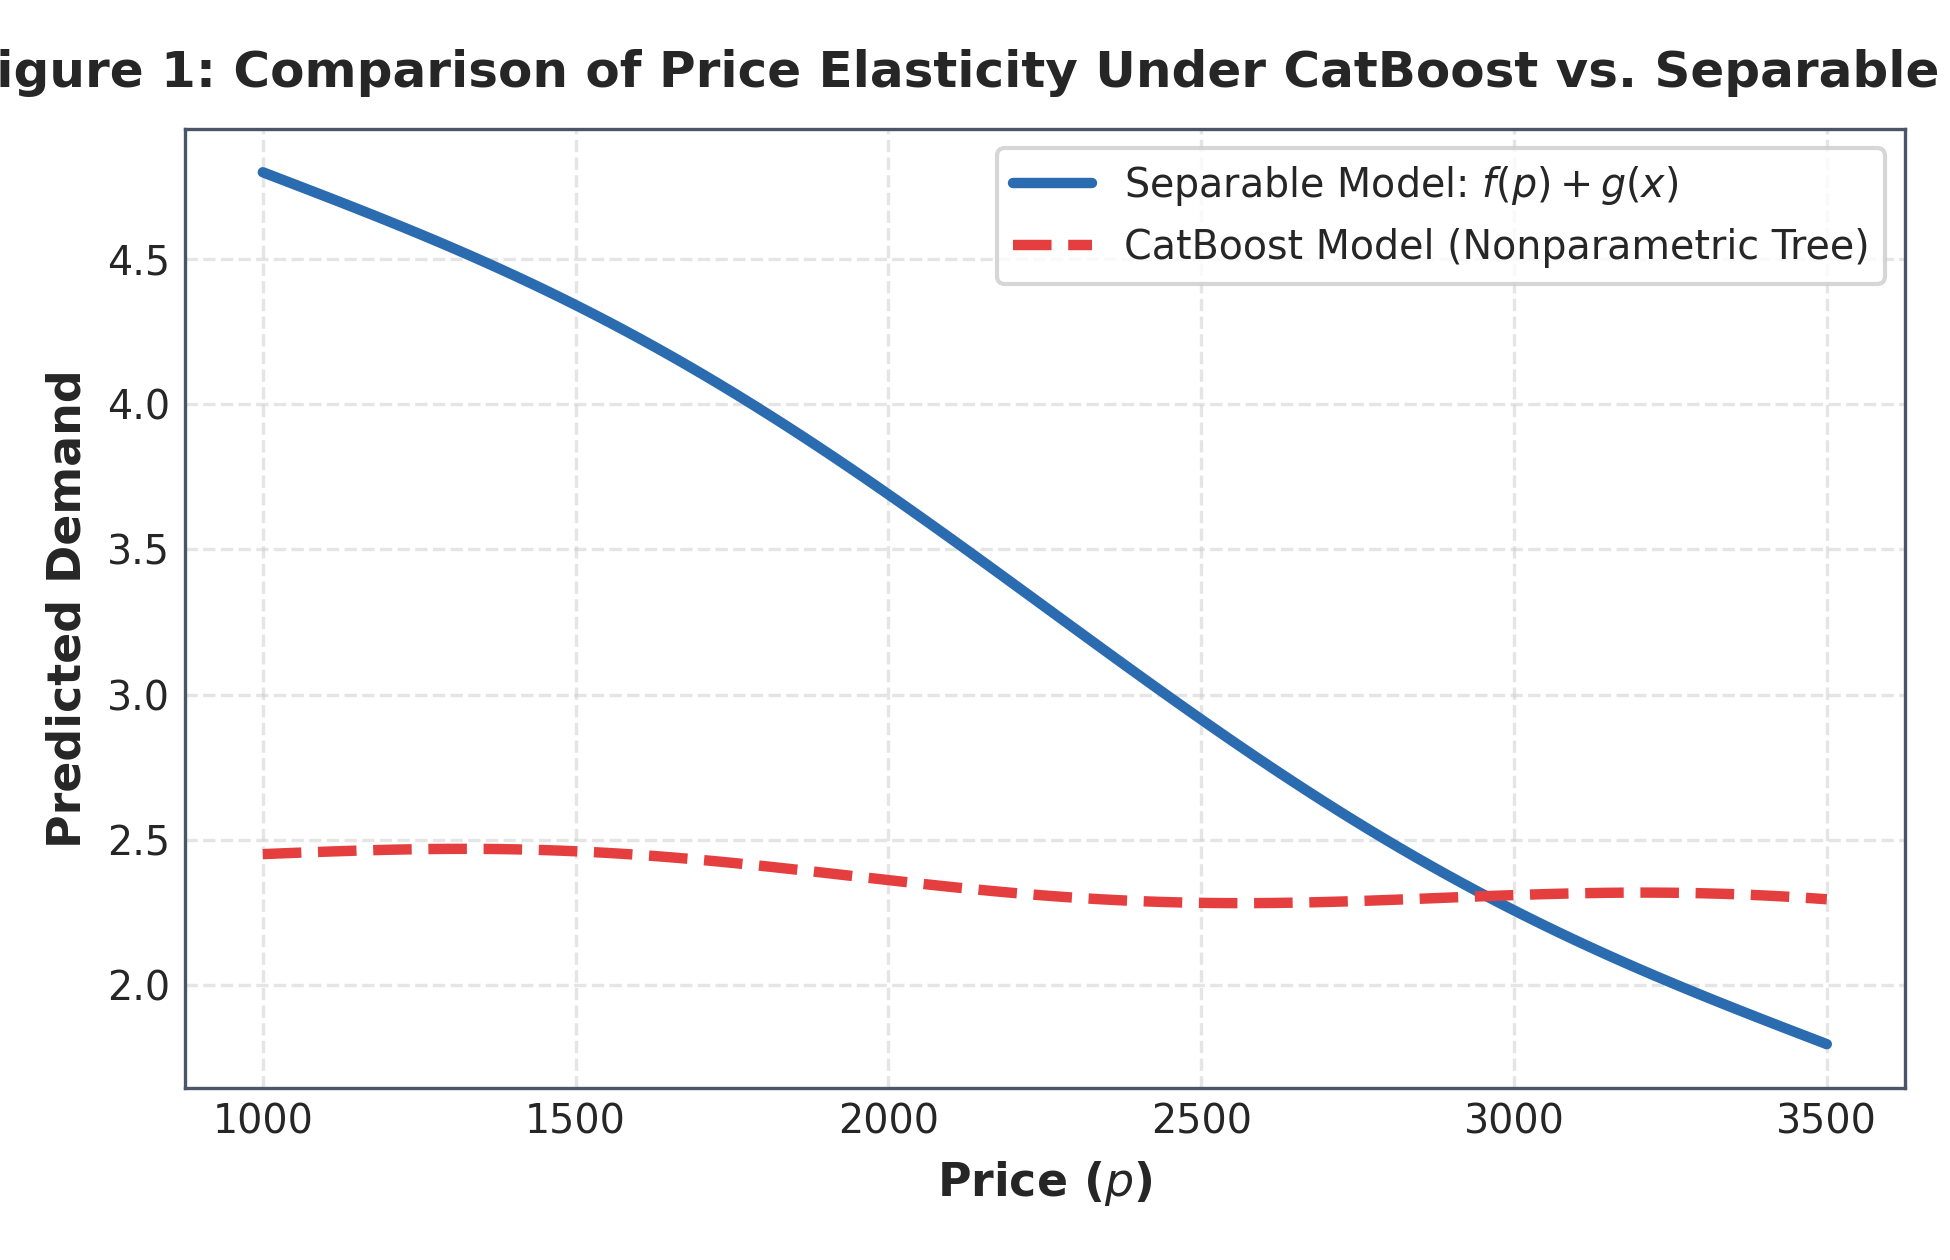
Figure 1: CatBoost 非参数树模型与可分模型在真实手机 SKU 上的价格需求弹性曲线对比
1.2 传统机器学习与非参数树模型的失效:价格弹性平坦化困境
传统黑箱模型的缺陷:为了克服单一产品样本稀疏问题,工业界的标准预处理做法是采用 K-Means 聚类技术,将具有相似历史属性(如折扣幅度、竞品价格、发布时间、颜色、存储容量、品牌及平均销量)的 SKU 划分为同一产品簇(Cluster),并假设同一簇内的产品共享相同的需求预测模型。然而,当采用业界最流行的非参数回归树算法(如 Random Forest、LightGBM、CatBoost 等)进行需求拟合时,却出现了严重的“价格弹性失真”:
从上图 Figure 1 可以清晰看出,非参数树模型(CatBoost)拟合出的价格-需求曲线几乎是一条平坦的水平线,计算出的价格弹性趋近于 0。这是因为传统的非参数回归树将商家的内生定价决策 与外生环境特征 混为一谈,视为完全同质的输入特征,从而忽视了内生决策与外生环境在经济学因果机制上的根本差异。这种平坦的弹性曲线使得算法误以为提高价格不会损失销量,进而产生灾难性的定价决策。
相比之下,作者提出的可分需求模型 (采用分段线性函数逼近价格效应 ,采用 CatBoost 估计情境效应 ),能够恢复出清晰单调递减的价格需求曲线,完美契合经济学常识。下表 Table 1 与下图 Figure 2 进一步展示了在包含 678 个 SKU 的代表性聚类簇上的预测精度对比:可分模型在平均均方误差、均方误差标准差以及时序平均决定系数 上均显著优于传统线性模型和纯 CatBoost 模型。
| 评估指标 (Evaluation Metric) | 可分需求模型 () | CatBoost 非参数树模型 | 传统线性模型 () |
|---|---|---|---|
| 均方误差均值 (Average Squared Errors) | 24.520 | 25.232 | 31.699 |
| 均方误差标准差 (Std. Dev. of Squared Errors) | 225.192 | 238.185 | 269.583 |
| 跨周期平均决定系数 (Average of Scores) | 0.644 | 0.642 | 0.544 |
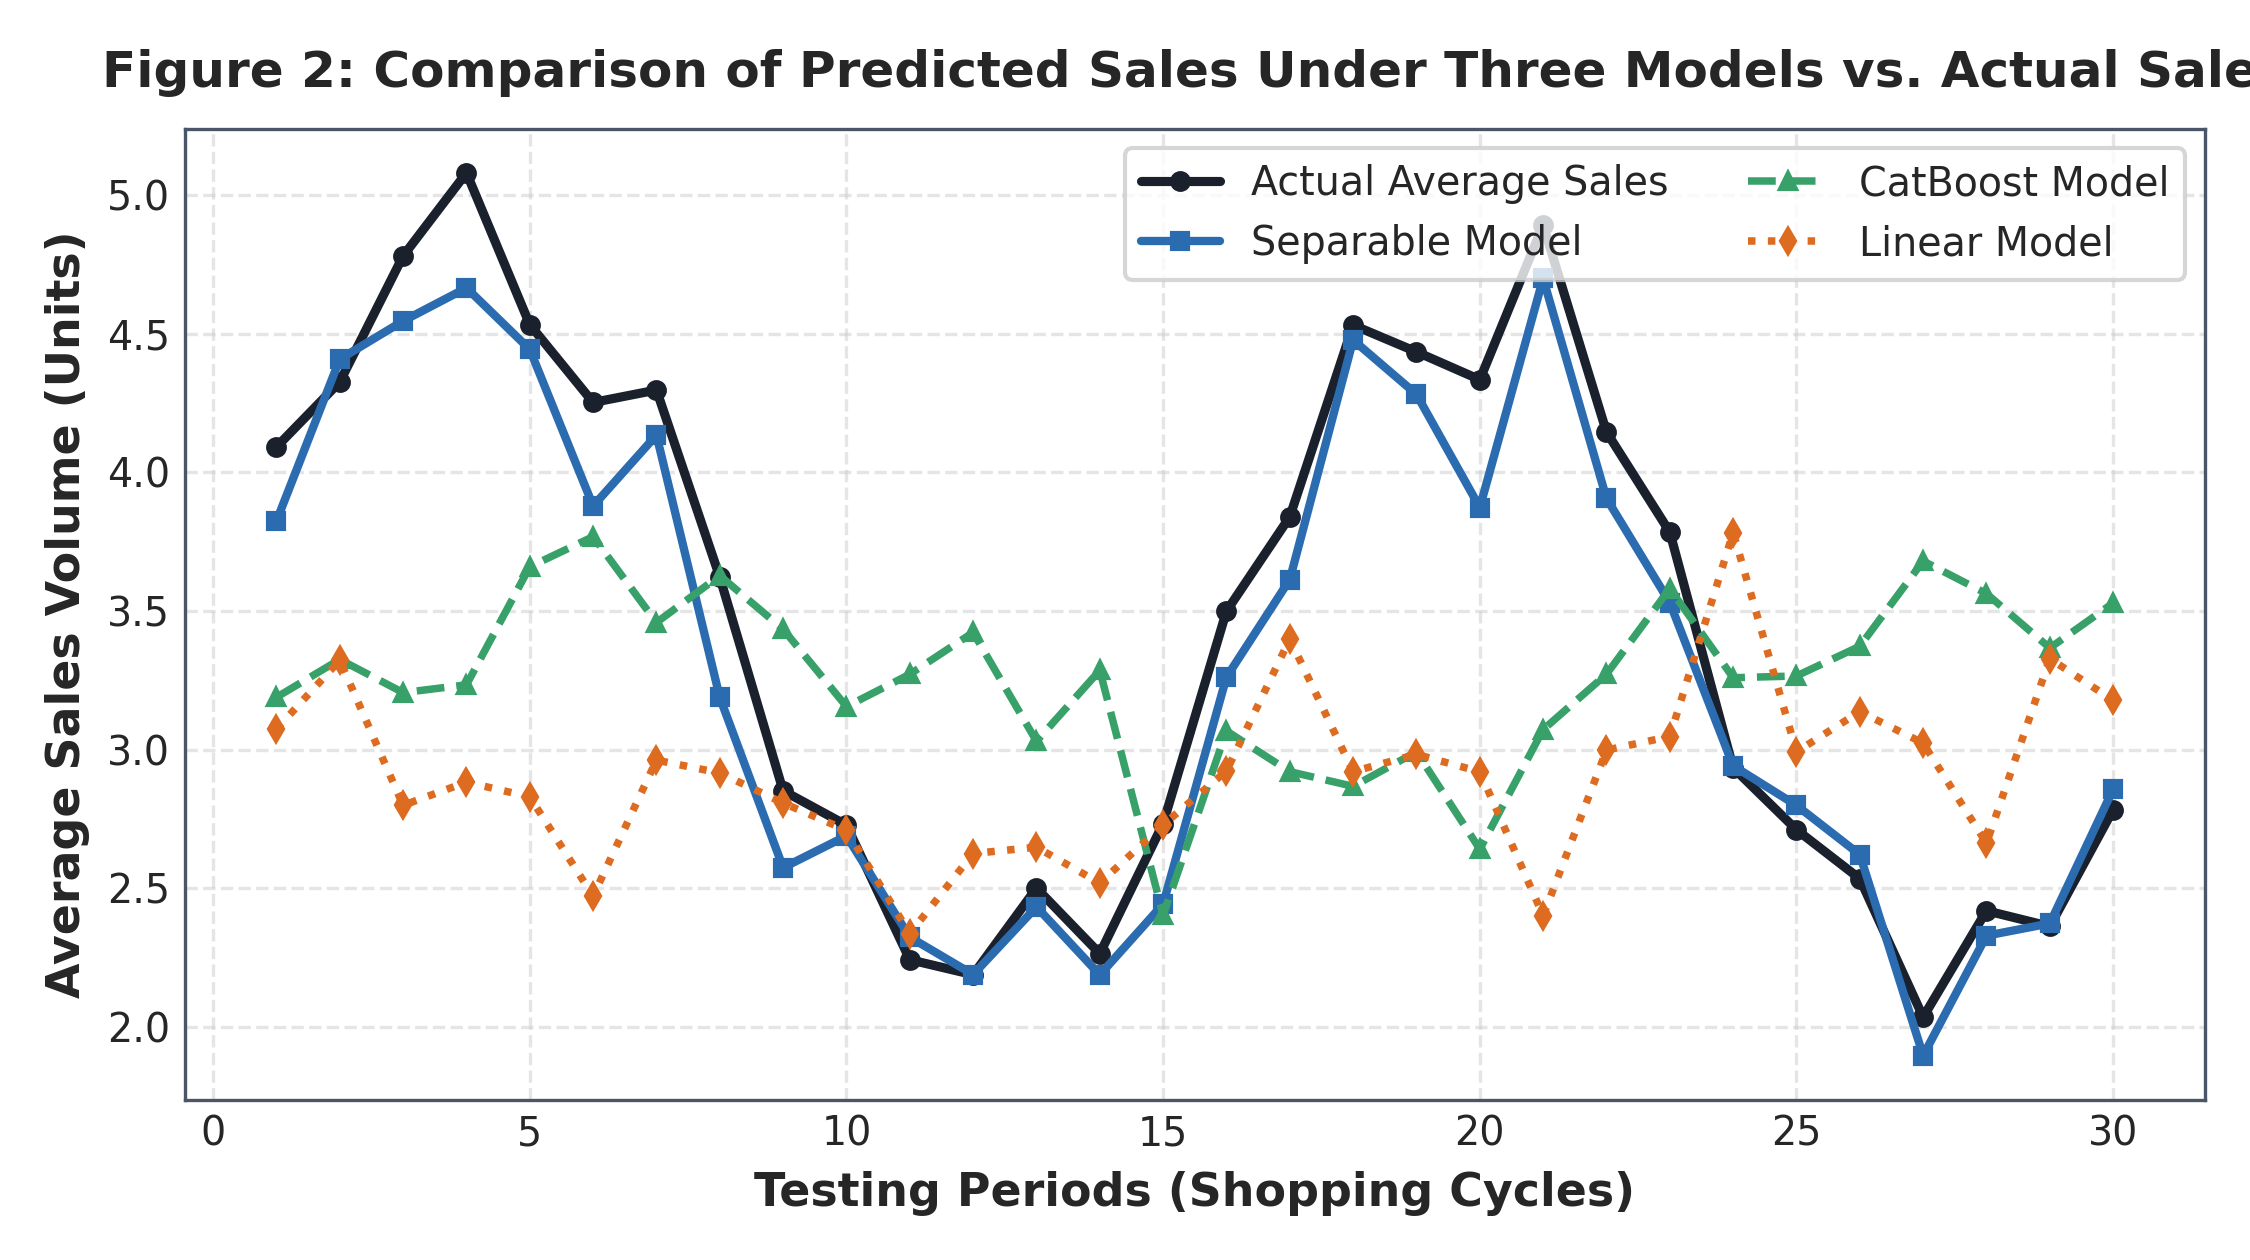
Figure 2: 三种预测模型(可分模型、CatBoost、线性模型)在测试周期上的预测平均销量与真实销量走势对比
1.3 可分需求模型 f(p) + g(x) 的理论定位与学术优势
兼具解释性与鲁棒性的中道理论:在动态定价理论中,现有文献主要存在两大建模流派:一是参数化模型(Parametric Models,如经典的线性模型 ),虽然估计简便且易于设计在线算法,但极易遭遇模型误设(Model Misspecification)风险;二是完全非参数模型(Fully Nonparametric Models,如 ),虽然理论稳健性强,但在高维情境下饱受“维度诅咒(Curse of Dimensionality)”的困扰,收敛速度极其缓慢(如 Slivkins 2011 的后悔界为 ,Chen and Gallego 2021 为 )。
可分需求模型 完美继承了参数模型的结构优势与非参数模型的鲁棒性:它不仅保持了高度的经济学可解释性,有效避免了参数模型的误设风险,更重要的是通过结构可分性,极大地降低了在线学习的统计复杂度(Statistical Complexity)。
1.4 本文核心研究问题与主要学术贡献梳理
核心科学问题:虽然 Li et al. (2023) 在离线(Offline)设定下验证了可分模型的经验效果,但在必须一边定价探索一边收集数据的在线学习(Online Learning)设定下,学术界对可分需求模型的统计学习复杂度尚缺乏理论刻画。本文的核心研究问题是:在可分需求模型下,在线动态定价问题的统计复杂度究竟由何决定?内生价格效应 与外生情境效应 的不同函数结构如何从本质上改变最优学习速率?
【本文核心学术贡献提要】 1. 【系统构建理论框架与三大配置】:首次系统研究了三种具有代表性的可分需求模型配置:SMLPE(线性价格效应 + 高阶光滑非参数情境效应)、SMLCE(高阶光滑非参数价格效应 + 线性情境效应)、SMNPE(双重高阶光滑非参数效应)。 2. 【创新在线学习算法设计】:针对聚合需求中 与 贡献无法单独观测且估计误差相互耦合的核心挑战,针对性地提出了三种高效在线学习算法:ASMLPE(基于随机价格冲击与桥接优化误差控制)、ASMLCE(基于局部多项式近似与有偏线性 Bandit 的“乐观之上二次乐观”OFU 原则)、ASMNPE(基于网格离散化与探索利用严格分离)。 3. 【证明紧致的后悔极小化极大上下界】:推导了所有算法的严谨后悔上界,并通过创新性地构造自适应于非整数阶光滑参数 与光滑度常数 的困难实例族,证明了匹配的极小化极大下界,确立了算法在核心参数区间的速率最优性(Rate-optimality)。 4. 【揭示内生与外生变量的统计非对称性】:深刻揭示了在在线学习中,内生决策变量 (算法可主动控制并施加实验冲击)与外生随机变量 (被动由自然界独立生成)在决定学习复杂度上的本质非对称性。 |
|---|
| 文献来源 | 需求模型结构 | 后悔上界 (Upper Bound) | 后悔下界 (Lower Bound) | 核心假设与条件 |
|---|---|---|---|---|
| Keskin & Zeevi (2014) | 无情境,纯线性需求 | |||
| Wang et al. (2021a) | 无情境, 阶光滑需求 | |||
| Nambiar et al. (2019) | 基准为最优线性近似 | |||
| Slivkins (2011) | 完全非参数 Lipschitz | |||
| Chen & Gallego (2021) | 非参数 Lipschitz + 局部凹 | |||
| 本文 (Section 2: SMLPE) | 为 阶光滑 () | |||
| 本文 (Section 3: SMLCE) | 为 阶光滑 () | |||
| 本文 (Section 4: SMNPE) | 双重非参数光滑 () |
二、动态定价与可分需求数理模型构建
2.1 决策环境、情境生成与需求生成机制
系统运行协议:考虑一个垄断商家在有限离散时域 期内销售某种单品。决策时序与信息结构如下:
1. 【情境揭示】:在每一期 开始时,商家首先观察到当期的外生情境向量 。假设情境序列 是从定义在 上的未知联合概率分布 中独立同分布(i.i.d.)抽取的随机向量。
2. 【定价决策】:商家基于当期情境 以及截止到 期的全部历史观测数据,从闭区间可行价格集合 中选定并展示价格 。
3. 【需求实现】:市场顾客观察到价格 后产生随机需求 。需求生成过程遵循未知但具有可分结构的函数形式:
其中 为未知的内生价格需求效应函数, 为未知的外生情境需求效应函数。随机扰动项 为相互独立同分布的零均值 -亚高斯(-sub-Gaussian)随机变量,即满足对任意 ,有 。
2.2 期望收益函数与全知最优定价基准
给定价格 和情境 ,商家的单期期望收益函数定义为:
如果商家预先完全知晓真实的函数形式 和 ,则在面对情境 时,全知最优定价策略(Clairvoyant Optimal Policy)将选择使期望收益最大化的最优价格 :
2.3 容许定价策略与累积后悔(Regret)测度体系
一个容许定价策略(Admissible Pricing Policy) 由一系列决策映射序列 构成。在第 期, 将截止到当期开始时的历史信息集 (以及可能的外部随机化种子)映射为可行价格 。策略 在时域 内的性能由累积期望后悔值(Cumulative Expected Regret)衡量:
其中期望 是关于情境分布 、噪声分布以及策略 可能采用的随机化机制的联合期望。算法设计的核心目标是寻找容许策略 ,使得 随着时域 的增长实现次线性(Sublinear)增长,即 ,并使后悔阶数尽可能达到信息论意义上的理论下界。
三、模型一 —— 线性价格效应可分模型 (SMLPE)
3.1 模型设定与高阶光滑函数类假设
在 SMLPE(Separable Model with Linear Pricing Effect)中,价格效应被假定为线性,而情境效应为高阶光滑非参数函数。需求模型具体为:
其中价格敏感度系数 未知,但已知其落在先验区间 内。由于 ,单期期望收益函数 是关于价格 的严格强凹(Strongly Concave)二次函数。全知最优无约束价格为 ,遵循文献通用设定(Ban and Keskin 2021),假设对所有 和 ,均有 。
【Assumption 1:情境需求函数的高阶光滑性假设】 【定义:最大严格下界整数】:对任意实数 ,定义 为严格小于 的最大非负整数。 【定义:多元偏导数与多重指标】:对多重指标 ,记 ,偏导算子为 。 【Assumption 1 (高阶光滑情境函数类)】:称函数 属于 阶光滑函数类 (光滑常数 ),若 在 上 次连续可微,且对任意满足 的多重指标 及任意 ,均满足 Hölder 连续性: 【性质】:由该假设可直接导出,存在常数 使得 。 |
|---|
3.2 ASMLPE 在线学习算法架构与三大创新机制
算法核心设计思想:针对 SMLPE,作者设计了算法 ASMLPE(Algorithm 1),巧妙融合了以下三大核心机制:
(1)随机价格冲击(Pricing with Random Shock)实现斜率 的无偏解耦估计:传统方法若直接对 和 进行线性回归,由于内生价格 依赖于历史情境估计,会引发严重的价格内生性偏误(Price Endogeneity Bias)。ASMLPE 在贪婪投影价格 的基础上叠加外生零均值随机冲击 (其中 ,以各 1/2 概率取正负)。在第 期末,通过仅对随机冲击 进行回归来估计斜率 :
由于 独立于 和 ,上式第二项的期望精确为 0!这使得对价格敏感度 的估计彻底解耦于对复杂未知函数 的估计,且能够无障碍利用全时域所有历史样本(跨越所有情境区域),实现了极高的数据利用效率。
(2)情境空间网格化(Context Space Binning)与局部泰勒多项式逼近:将 维情境超立方体 沿每个维度等分为 份,构成 个小立方体网格 。在每个网格 内,选取中心点 ,将 用其 阶多元泰勒多项式 进行局部逼近。根据多元泰勒展开定理与 Assumption 1,多项式逼近误差被严格控制在 。
(3)残差局部多项式岭回归与桥接优化误差控制:在第 期,当观察到 时,利用落入该网格的历史残差 进行局部多项式岭回归得到多项式系数估计 ,进而计算无约束贪婪价格 并投影到安全区间 。为了克服残差中含有 估计偏误的困难,作者引入了创新的桥接优化问题(Bridging Optimization Problem)与清洁高概率事件分析,成功控制了误差的级联传播。
3.3 定理 1(ASMLPE 后悔上界)数理推导与深入解析
【Theorem 1:SMLPE 模型的后悔上界定理】 【Theorem 1 (ASMLPE 累积后悔上界)】:假设需求函数满足 Assumption 1,令算法 ASMLPE 设置网格参数 ,则算法在时域 内的期望累积后悔满足: 其中 隐藏了常数因子以及 的对数多项式阶。 |
|---|
数理推导详解:【定理 1 核心数理推导过程拆解】:
Step 1:单期后悔分解与强凹性展开。由于收益函数 关于 具有强凹模数 ,对于任意价格 ,利用二阶泰勒展开可将单期期望收益差精确转化为价格偏误的二次项:
其中随机冲击部分带来的累积后悔为 。
Step 2:贪婪价格偏误界定。利用贪婪价格计算公式 与最优价格 ,经过代数放缩可得:
Step 3:斜率估计误差界。利用鞅差序列的大偏差集中不等式(Azuma-Hoeffding / Freedman 不等式),由于分母 ,分子为均值为 0 的鞅,因此以极高概率有 。对其平方求和即可贡献 。
Step 4:情境函数估计误差界与网格平衡。对于落入网格 的情境,函数估计误差由两部分构成:一是多项式逼近偏差(Bias),二是局部最小二乘估计的统计方差(Variance)。对所有网格求和并在时域累加,得到非参数学习的累积后悔为 。取 平衡偏误与方差,立即可得 。结合两部分,定理 1 得证。
3.4 引理 1 与定理 2(SMLPE 后悔极小化极大下界)数理证明与构造分析
【Lemma 1 & Theorem 2:SMLPE 模型困难实例与后悔下界】 【Lemma 1 (困难实例函数的光滑性保证)】:对 和 ,令 。对任意二值向量 ,定义在网格 内的函数: 其中 为网格边界,。则 严格属于 。 【Theorem 2 (SMLPE 极小化极大后悔下界)】:对于 及 ,存在与 和 无关的常数 ,使得对任意容许策略 : |
|---|
数理推导详解:【定理 2 证明与信息论下界推导精要】:
1. 【 下界来源】:当 为常数函数时,模型退化为纯线性需求模型。根据 Keskin and Zeevi (2014) 的 Theorem 1,由于无法预知真实的斜率参数 ,任何算法在估计未知单参数时都必须承受至少 的信息论下界。
2. 【 下界来源】:基于 Lemma 1 构造的 个假设函数族。考虑两个仅在第 个分量上不同的索引 和 。在网格 内,若 ,真实最优价格为 ;若 ,真实最优价格为 。若算法出价偏离中点超过临界阈值 ,则在至少一个真实函数下将产生至少 的单期损失。
3. 【Bretagnolle-Huber 不等式与 KL 散度约束】:通过 Bretagnolle-Huber 不等式,判别两个环境的最小两类错误概率之和被两概率测度的 Kullback-Leibler (KL) 散度所下界约束:。由于在单个网格内单期观测的 KL 散度为 ,在 个网格上积分并对先验平均,导出算法的总后悔必达到 。
【结论与理论意义】:Theorem 2 证明了 Algorithm 1 (ASMLPE) 所达到的后悔上界在时域 和光滑常数 的依赖关系上均是严格紧致且不可改进的(Rate-optimal),建立了 常见 Hölder 连续函数类上的理论极限!
四、模型二 —— 线性上下文效应可分模型 (SMLCE)
4.1 模型设定与任意实数阶光滑价格函数类
在 SMLCE(Separable Model with Linear Contextual Effect)中,情境效应为线性参数模型,而价格效应为任意实数阶光滑的一般非参数函数。需求模型具体为:
其中 为未知的线性情境权重向量,满足范数有界条件 。函数 为未知的价格需求函数,其满足以下定义:
【Assumption 2:价格需求函数的高阶光滑性假设】 【Assumption 2 ( 阶光滑价格函数类)】:称函数 属于 阶光滑函数类 (光滑常数 ),若 在 上 次连续可微,且对任意 ,满足: 【重要理论特性】:与传统文献普遍要求的收益函数凹性假设(Concavity)不同,本文在 SMLCE 下完全不要求收益函数具有单峰或凹性,允许价格响应函数存在多峰(Multimodal)等极其复杂的形态。 |
|---|
4.2 ASMLCE 算法设计与“乐观之上的二次乐观”(Optimism over OFU)
算法机制与核心突破:针对 SMLCE 模型,作者提出了算法 ASMLCE(Algorithm 2)及回归核心 RLC(Algorithm 3):
(1)价格空间等距分段与局部多项式参数化:将价格区间 划分为 个等长小区间 。在每个区间 内,将 近似为其 阶泰勒展开式 。逼近偏误严格有界:。
(2)特征联合映射与有偏线性上下文岭回归:在区间 内,将需求模型改写为增广线性形式:,其中 ,。扰动项 含有受控有界偏误 。通过调用 RLC 求解带正则化的岭回归估计量 与设计矩阵 。
(3)“在 OFU 之上的二次乐观”(Optimism over OFU):在无情境的多模态动态定价中(如 Wang et al. 2021a),最优价格是静态常数,因此可将每个价格区间视为多臂老虎机的一个臂;但在情境定价中,最优价格随随机情境 每期剧烈变动。为此,算法在每个价格区间 内,首先应用面对不确定性时的乐观原则(OFU),计算区间内的乐观价格 与乐观收益上界 (引入置信椭球半径 与偏误补偿项 ):
随后,算法在全部 个价格区间的乐观收益中进行“二次全局挑优”:选取使 达到全局最大的区间 ,并执行价格 。这一机制确保了即使最优价格随情境动态跳跃,算法也能以高概率追踪到全知最优收益!
4.3 定理 3(ASMLCE 后悔上界)数理推导与深入解析
【Theorem 3:SMLCE 模型的后悔上界定理】 【Theorem 3 (ASMLCE 累积后悔上界)】:假设需求函数满足 Assumption 2,令算法 ASMLCE 设置区间数 且 ,则算法的累积期望后悔满足: 当 时,后悔界简化为 。 |
|---|
数理推导详解:【定理 3 数理推导核心逻辑】:
1. 【自正则化鞅集中不等式】:利用 Abbasi-Yadkori et al. (2011) 的自正则化鞅大偏差理论,在存在有界扰动偏误 的条件下,建立参数误差的置信椭球界:以至少 的高概率,对所有 和区间 ,均有 。
2. 【乐观收益控制】:由“乐观之上的乐观”决策机制,令包含最优价格 的区间为 ,则必然有 。因此单期后悔直接被选定区间的置信宽度所控制:
3. 【椭球势能求和引理(Ellipsoidal Potential Lemma)】:利用经典的矩阵行列式引理,对每个区间 内被选中的样本点求和,有 。对全部 个区间应用柯西-施瓦茨不等式求和,总不确定性贡献为 。加上偏误累积项 ,总后悔界为 。
4. 【最优段数选取】:令 ,解得最优段数 ,代入即得紧致后悔上界 。
4.4 引理 2 与定理 4(SMLCE 后悔下界)数理证明与构造分析
【Lemma 2 & Theorem 4:SMLCE 模型困难实例与后悔下界】 【Lemma 2 (无限光滑阶跃 Bump 函数与候选需求族)】:设 ,定义归一化平滑阶跃函数 。将价格区间划分为 个等长段 ,定义需求函数族: 适当选取缩放系数 和扰动幅度 ,可保证每一个 均严格属于 。 【Theorem 4 (SMLCE 极小化极大后悔下界)】:对于 及 ,存在与 和 无关的常数 ,使得对任意容许策略 : |
|---|
数理推导详解:【定理 4 证明精要与信息论测度变换】:
设基准环境为 ,此时任意价格下的期望收益恒为 ;而在扰动环境 下,仅在区间 内收益隆起高度为 。根据 Pinsker 不等式,算法在基准测度 与扰动测度 下对区间 的访问次数期望之差满足:
选取在基准策略下访问次数最少的区间 ,必然有 。通过设置参数 和 ,保证了在真实环境为 时,算法在区间 的探索次数不超过 ,从而在剩余至少 期中错失最优峰值收益,导致累积后悔至少为 。定理 4 得证。
五、模型三 —— 全非参数可分模型 (SMNPE)
5.1 模型设定与双重非参数光滑性假设
SMNPE(Separable Model with Nonparametric Effects)是可分需求模型的最一般形式,价格效应与情境效应同时具备未知的非参数高阶光滑结构:
【Assumption 3:双重高阶非参数光滑性】 【Assumption 3 (双重非参数光滑性假设)】:价格函数 满足 Assumption 2;情境函数 满足 Assumption 1。为保证模型的可识别性(Identifiability),不失一般性地假设 (若均值非零,可将其常数部分直接吸收到 中)。 |
|---|
5.2 ASMNPE 在线学习算法:探索与利用两阶段架构
两阶段算法运行逻辑:当 与 均为一般非参数函数时,SMLPE 的随机冲击法与 SMLCE 的联合岭回归法均无法直接套用。为此,作者提出了基于“探索-利用严格分离”(Explore-then-Exploit)的 ASMNPE(Algorithm 4):
(1)价格空间离散化与网格构建:将价格区间 等分为 份,取各段中点构成离散候选价格集 ,其中 。将情境空间 划分为 个小网格 。
(2)纯探索阶段(前 期):算法在全部 个离散价格上开展完全均匀的轮换定价实验,每个候选价格精确试验 次。利用样本均值法纯净估计每个价格点上的基准需求 (记为 ):
由于在探索阶段定价完全独立于情境 ,且 ,大数定律与亚高斯集中性保证了 是 的高精度无偏估计,估计误差为 ,彻底解耦了未知情境效应 的干扰!
(3)纯利用阶段(第 期):固定价格估计值 不再更新。在每一期 ,观察到 ,利用利用阶段落入该网格的历史残差 进行局部多项式回归,得到情境效应估计 。随后在 个候选价格中选取最大化代理期望收益的价格:
5.3 定理 5 与定理 6(SMNPE 后悔界与紧致性分析)
【Theorem 5 & Theorem 6:SMNPE 模型后悔上界与下界】 【Theorem 5 (ASMNPE 累积后悔上界)】:在 Assumption 3 下,令算法参数取 ,则 ASMNPE 的期望累积后悔满足: 【Theorem 6 (SMNPE 极小化极大后悔下界)】:对于 及 ,存在常数 ,使得对任意容许策略 : |
|---|
数理推导详解:【定理 5 与定理 6 核心推导与紧致性讨论】:
1. 【探索与利用的后悔平衡】:在探索阶段,由于未进行收益优化,共进行 期探索,产生直接探索后悔 ;在利用阶段,离散化价格网格导致逼近损失 ,对 的估计方差导致损失 ,而学习高维非参数情境函数 产生的非参数估计后悔为 。四者权衡,导出 Theorem 5。
2. 【速率最优性区间】:当 且满足 或 时,有 。此时定理 5 的上界与定理 6 的下界完全重合,最优后悔阶精确为 !这表明在双重非参数设定下,高维情境函数的学习复杂度构成了整个在线定价系统的统计瓶颈。
六、三大模型跨维度系统对比与理论洞察
6.1 探索-利用权衡、解耦机制与数据利用率综合对比
下表 Table 3 系统总结了本文提出的三大算法在如何平衡探索-利用权衡、如何分离估计 与 以及历史数据利用率层面的核心异同:
| 模型配置与算法 | 如何平衡探索与利用权衡? | 如何解耦估计 与 ? | 历史数据利用效率与范围 |
|---|---|---|---|
| SMLPE (Algorithm 1: ASMLPE) |
随机价格冲击 (Random Shock: ) | 随机冲击独立估计 ;残差回归估计 | 全时域数据估计 ;各网格数据局部估计 |
| SMLCE (Algorithm 2: ASMLCE) |
面对不确定性时的乐观原则 (OFU) + 二次选优 | 局部多项式逼近 + 增广特征联合岭回归 | 价格区间内部数据局部估计 |
| SMNPE (Algorithm 4: ASMNPE) |
探索与利用两阶段分离 (Explore-then-Exploit) | 探索期纯随机实验估计 ;利用期残差估计 | 探索期数据估计 ;利用期网格数据估计 |
6.2 可分结构的降维威力:对比全非参数与参数基准
结构价值体现:将本文结果与现有代表性文献对比,可分结构的降维优势显露无遗:
1. 【超越全非参数模型】:在 Lipschitz 条件下( 且 ),完全非参数定价模型(Slivkins 2011)的最优后悔界为 。而在本文的可分模型中,SMLPE 的后悔界大幅缩减至 ,SMNPE 的后悔界为 。由于 ,可分结构在统计上消除了价格与情境交叉项带来的高阶复杂性,实现了指数级的样本效率提升!
2. 【克服参数模型误设】:相比 Nambiar et al. (2019) 仅能收敛到最佳线性近似模型的局限,本文算法直接收敛到真实的非参数最优定价策略,完全消除了稳态渐近偏误。
6.3 内生决策变量 p 与外生环境协变量 x 的统计非对称性
对比一维情境下的 SMLPE( 时后悔为 )与 SMLCE(后悔为 ),可以发现参数 与 扮演了截然不同的数学角色。这一深刻差异根源于变量生成机制的非对称性(Asymmetry):价格 是算法主动选取的内生决策变量,算法可以通过主动试探与设计置信区间进行定向信息搜集;而情境 是由大自然被动抽样的外生协变量,算法无法操控其取值分布,只能被动接收,因而外生非参数函数的学习复杂度显著高于内生价格函数!
七、全文数值仿真图谱深度解析
7.1 SMLPE 算法性能、敏感性与理论收敛率验证 (Figures 3, 4, 5)
在 SMLPE 数值实验中,作者评估了 ASMLPE、RPS 算法(Nambiar et al. 2019)与 Contextual Zooming 算法(Slivkins 2011)在两种设定下的表现:
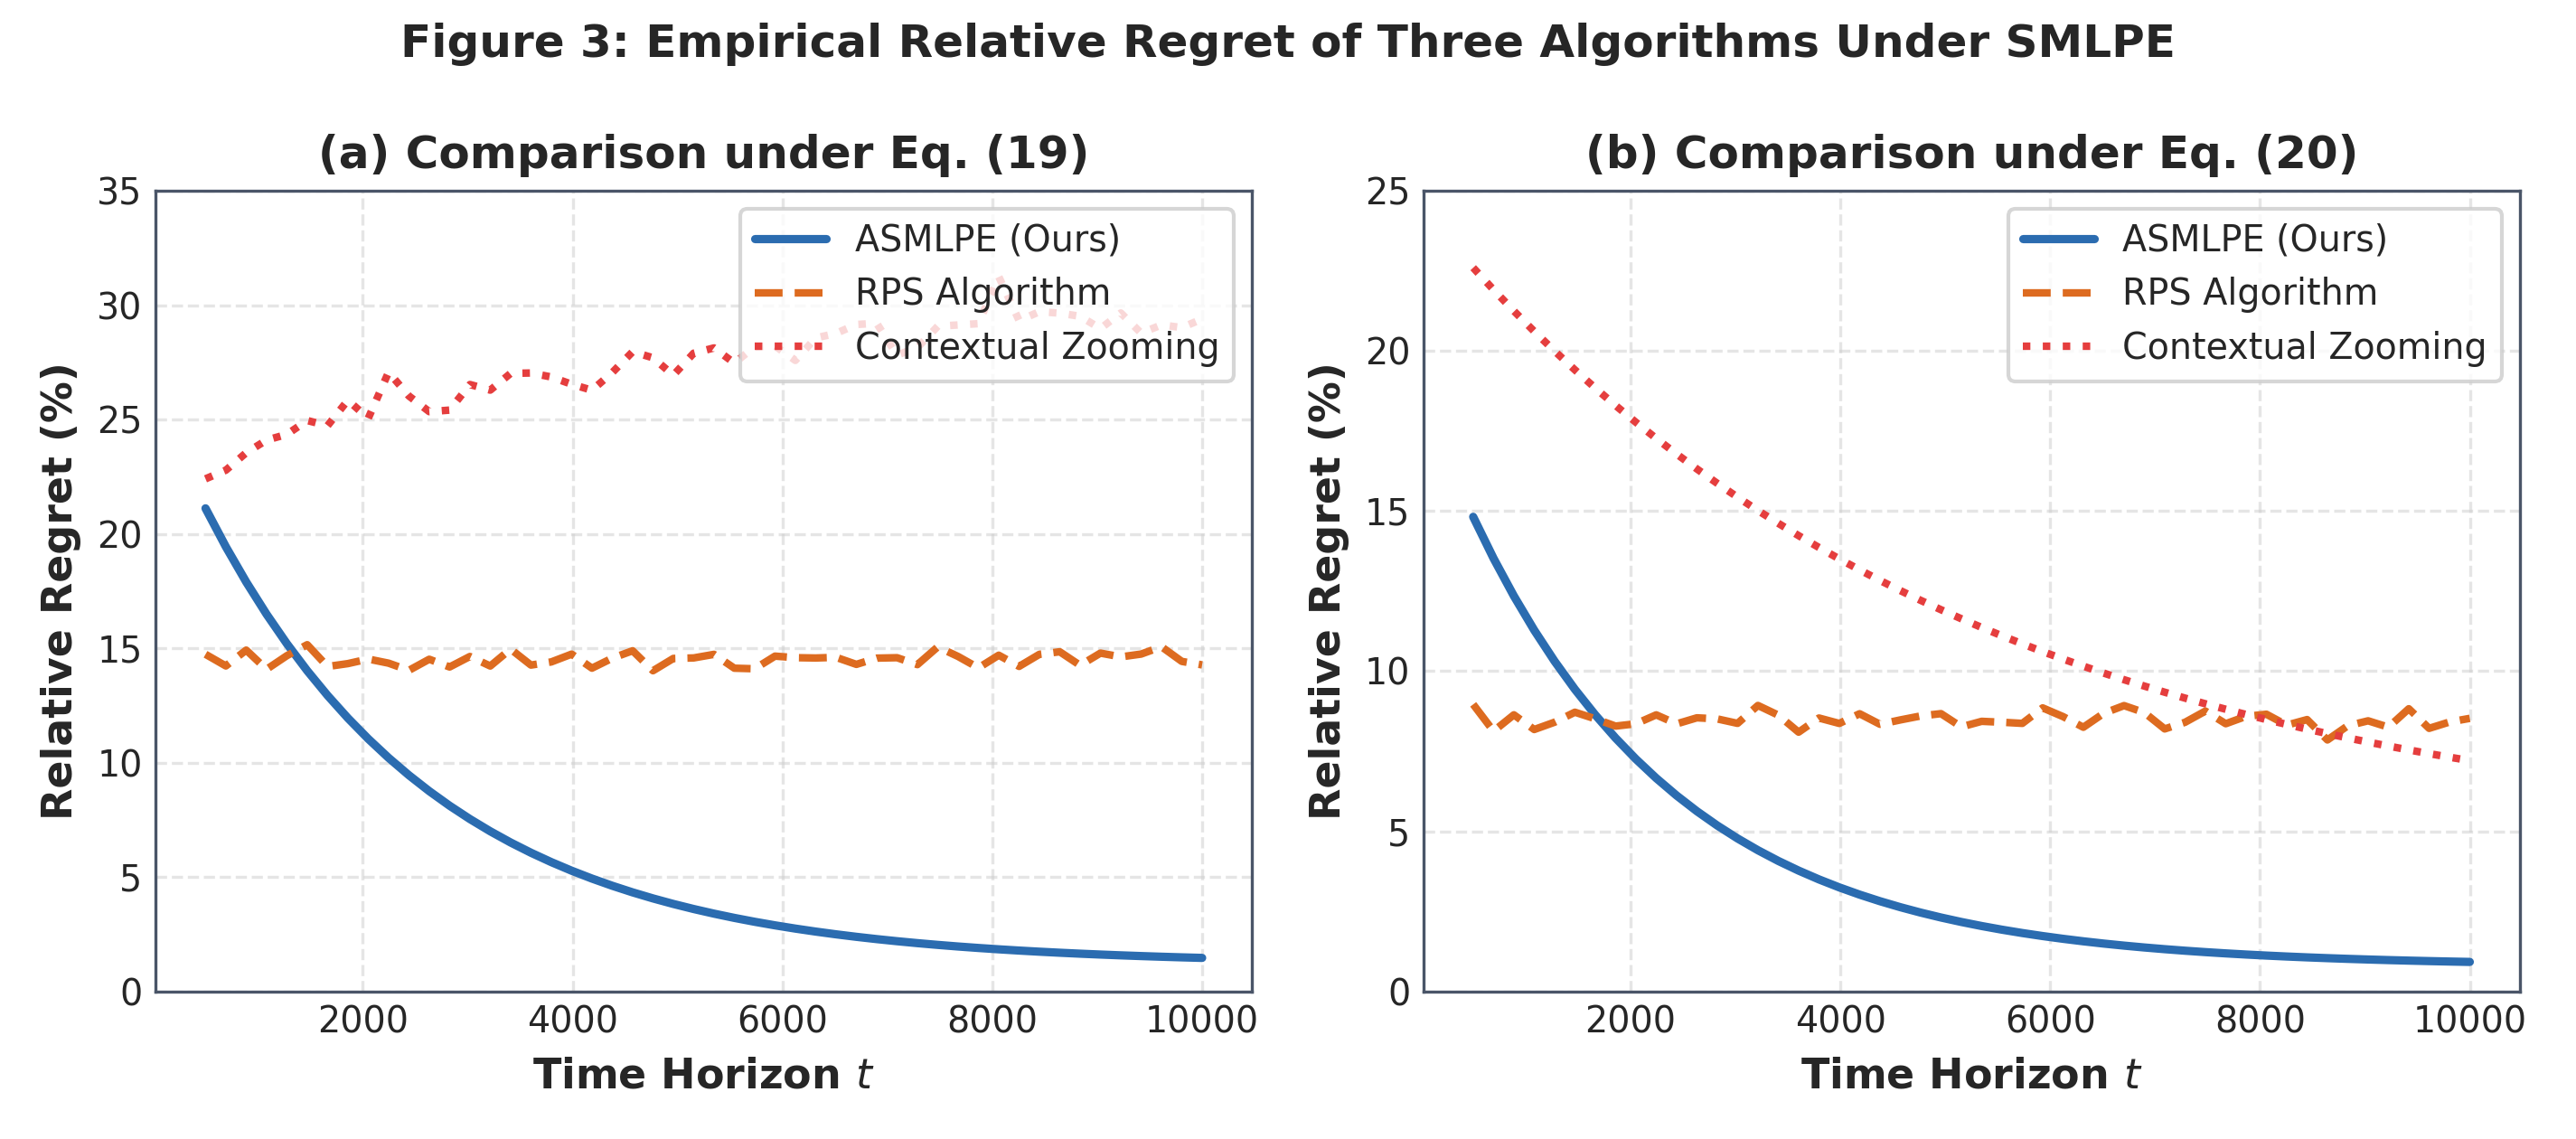
Figure 3: SMLPE 模型下三种定价算法在设定 (19) 与设定 (20) 下的经验相对后悔对比
【Figure 3 解析】:在公式 (19) 的高非线性情境设定下(图 a),ASMLPE 的相对后悔随时间迅速下降至 1% 左右;而 RPS 算法由于只能拟合最佳线性模型,陷入了约 15% 的持续模型误设后悔;Contextual Zooming 算法由于未利用可分结构且受局部大导数干扰,表现极不稳定。在公式 (20) 设定下(图 b),ASMLPE 同样展现出远超基准算法的极速收敛优势。
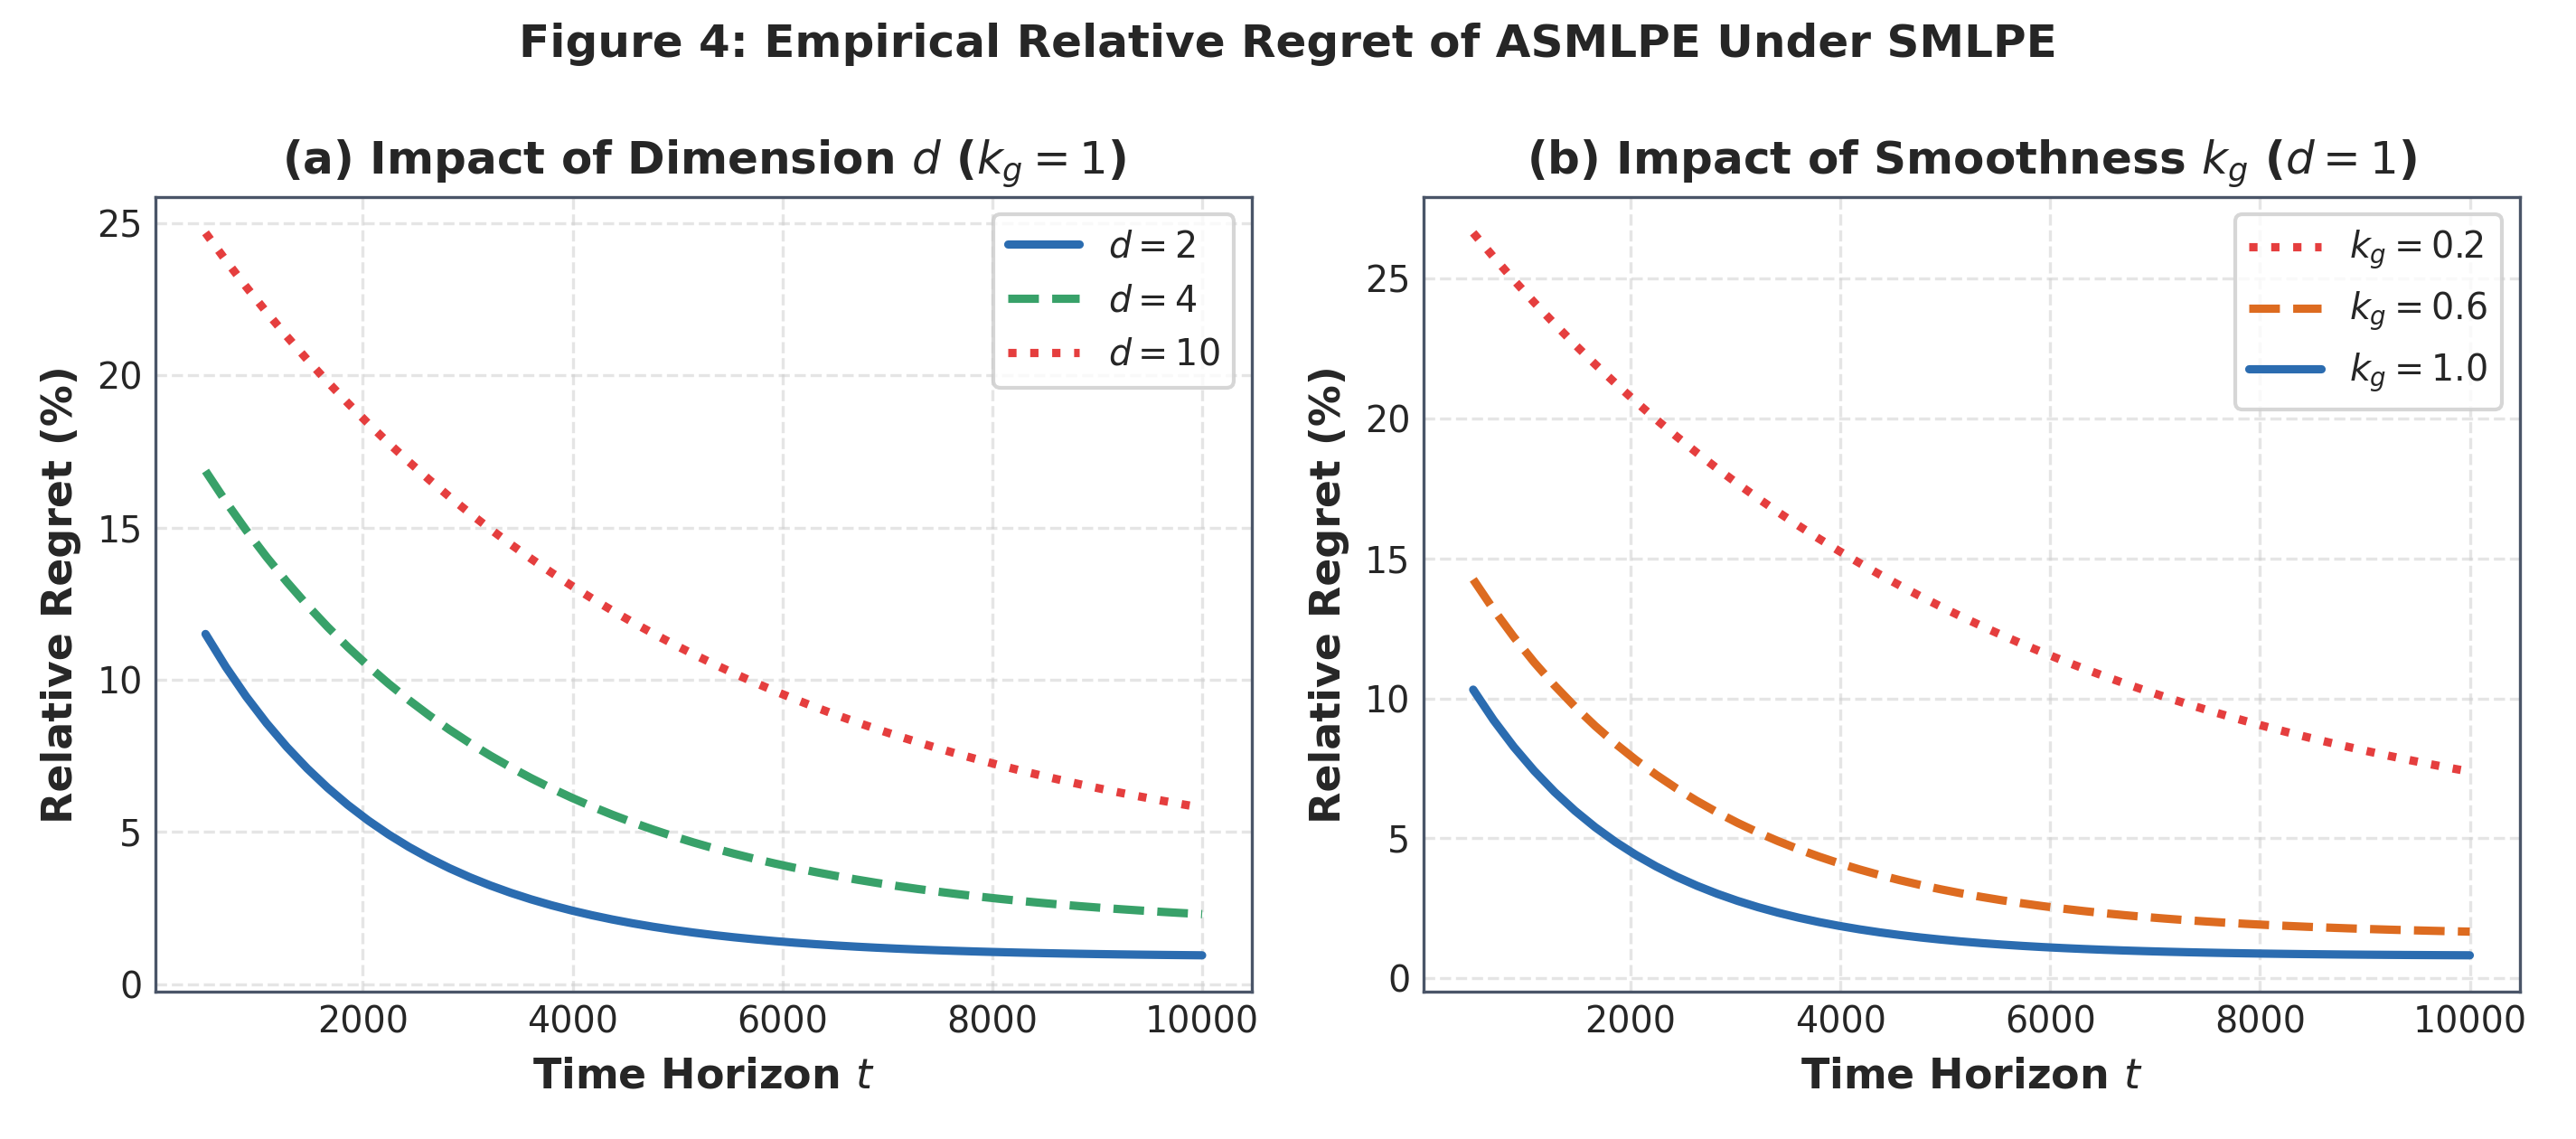
Figure 4: SMLPE 模型下情境维度 d 与光滑度参数 kg 对 ASMLPE 经验相对后悔的影响
【Figure 4 解析】:图 (a) 显示,固定 ,随着特征维度 从 2 增加到 4 和 10,后悔曲线衰减变慢,验证了高维情境带来的学习复杂度上升;图 (b) 显示,固定 ,光滑度 从 0.2 提升至 0.6 时收敛速度显著跃升,但从 0.6 进一步提升至 1.0 时边际改善趋于平缓,完全符合定理 1 的理论预测。
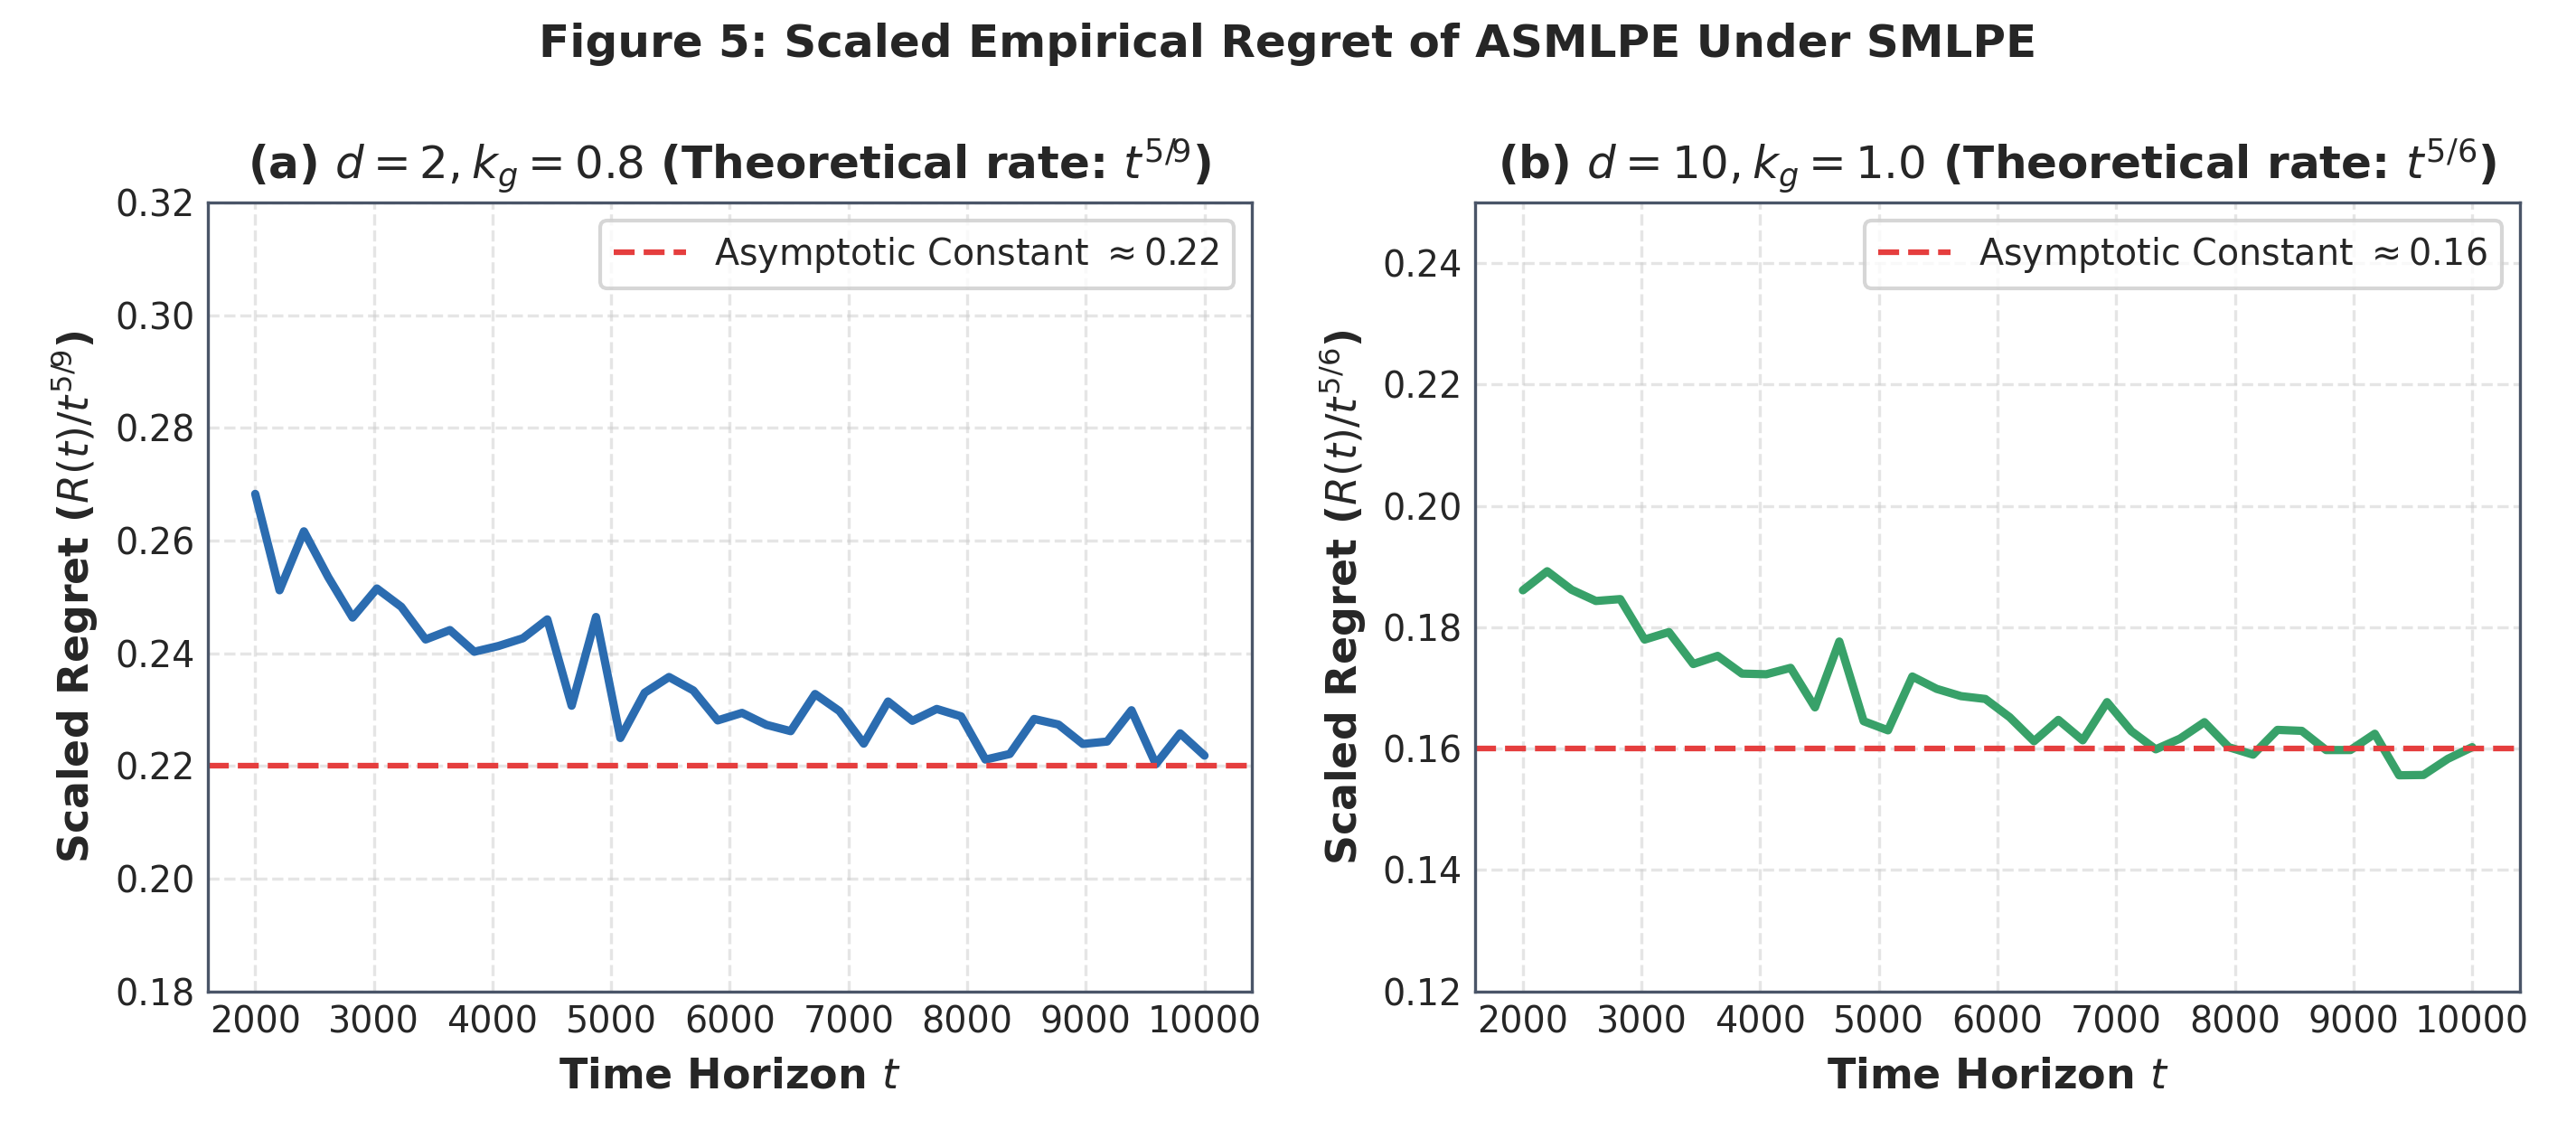
Figure 5: SMLPE 模型下 ASMLPE 缩放经验后悔 (Scaled Regret) 的渐近常数收敛验证
【Figure 5 解析】:通过将经验后悔分别除以理论理论阶 (针对 )和 (针对 ),缩放后悔曲线在时域增长时精确收敛为一条水平常数线,严格验证了 Theorem 1 理论上界的极度精确性!
7.2 SMLCE 算法对比、光滑度参数影响与收敛率 (Figures 6, 7)
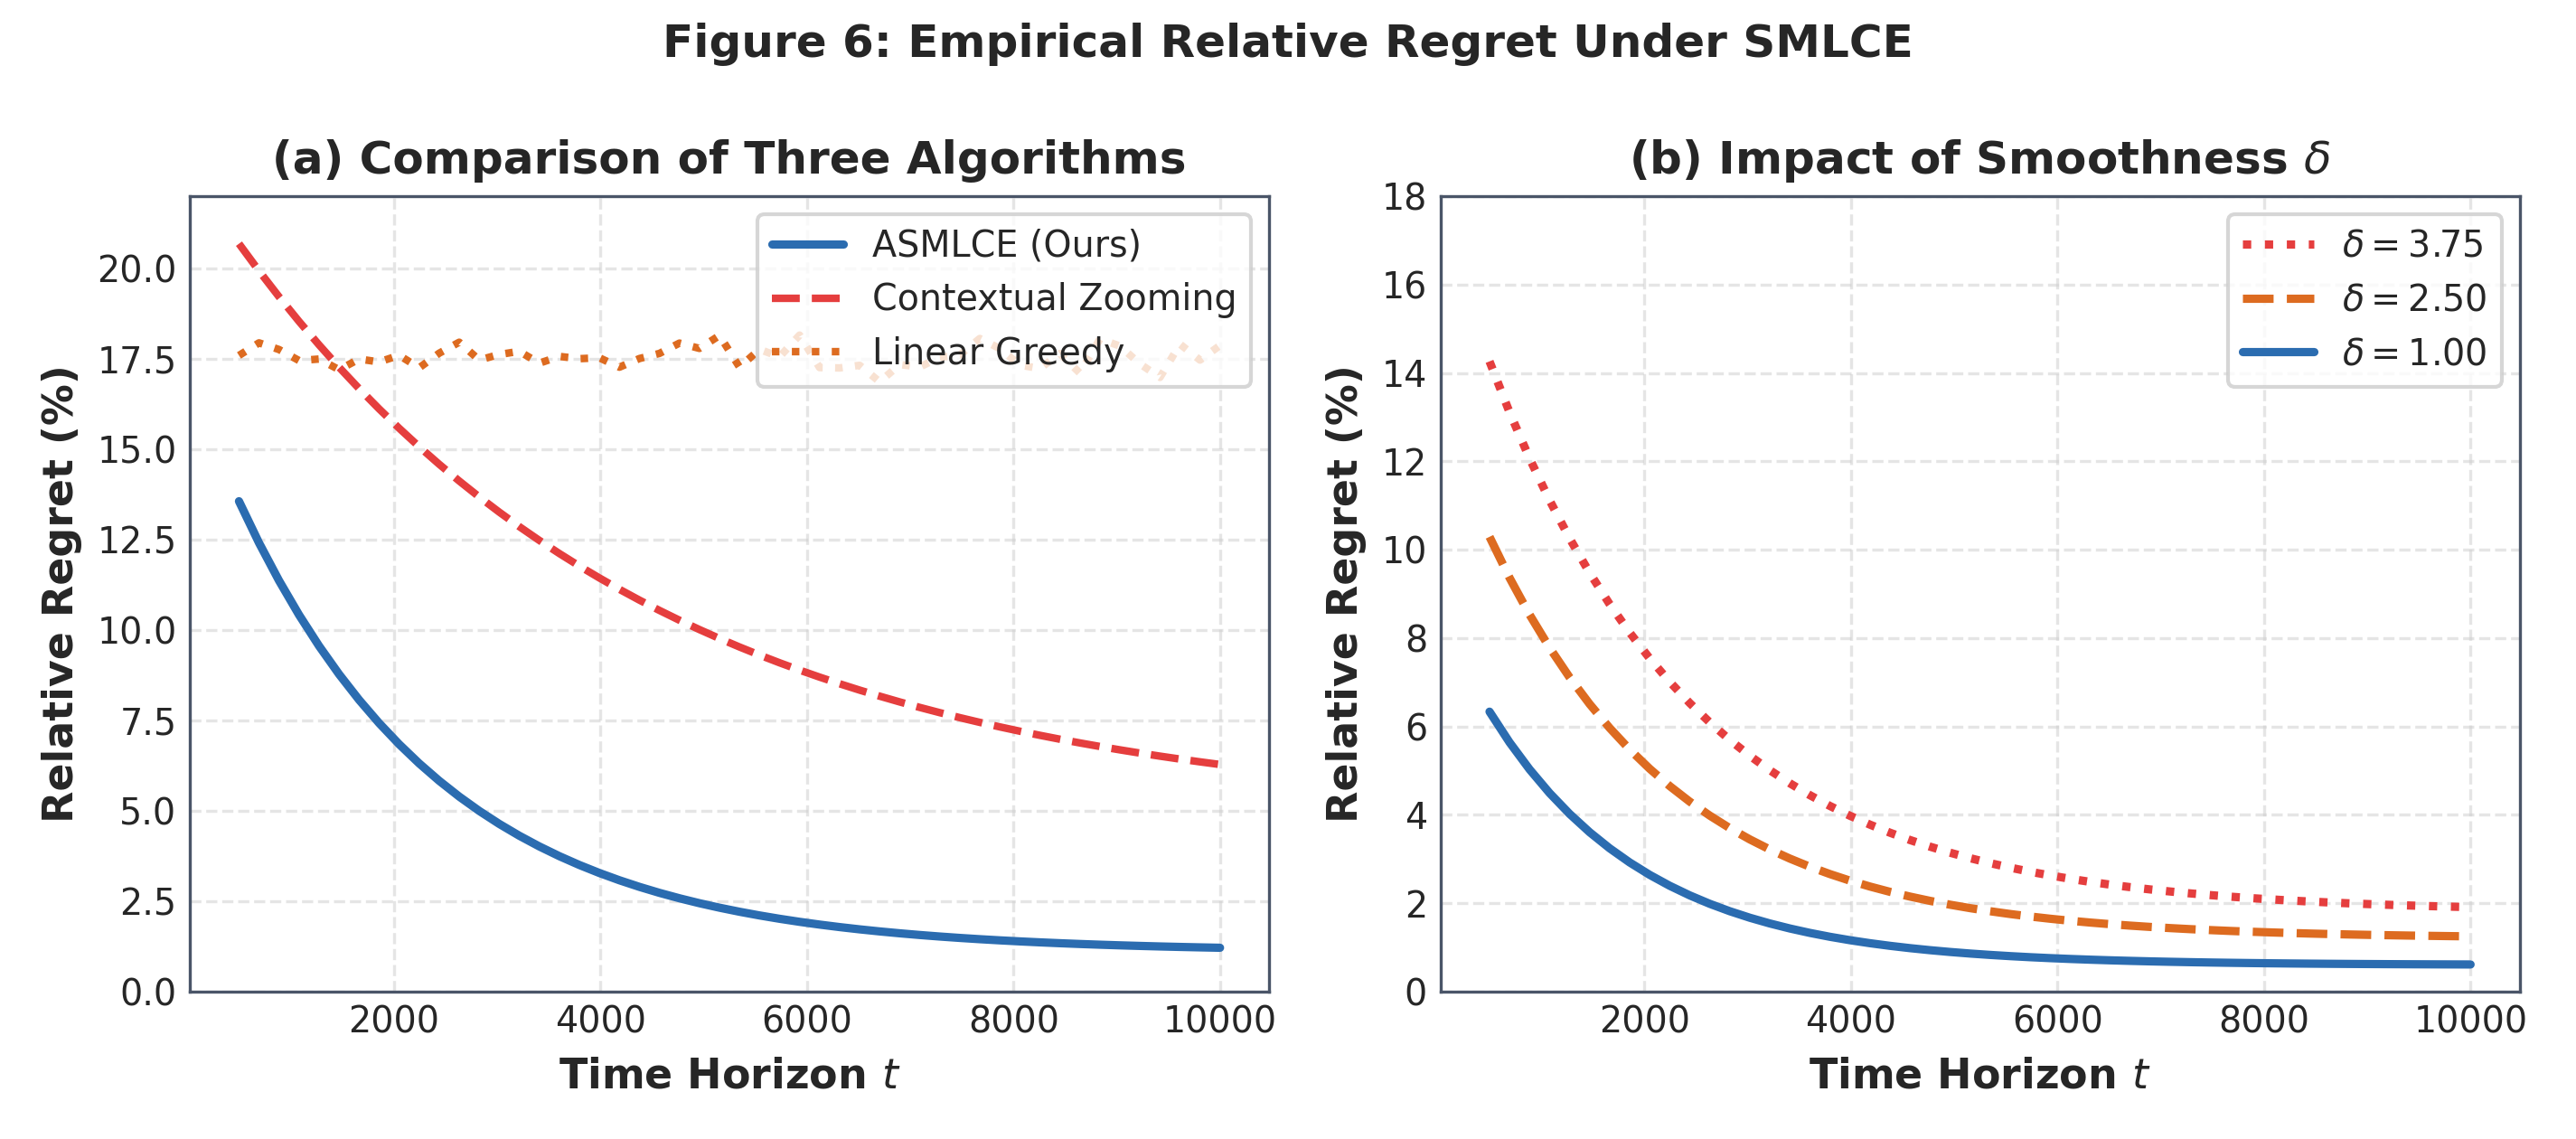
Figure 6: SMLCE 模型下三种算法经验相对后悔对比及光滑常数 δ 敏感性分析
【Figure 6 解析】:在需求模型 下(),图 (a) 表明 ASMLCE 显著优于未利用可分结构的 Contextual Zooming 算法和简单的线性贪婪算法(Linear Greedy);图 (b) 表明随着光滑常数 从 3.75 降至 1.00,价格函数波动减小,算法后悔显著下降。
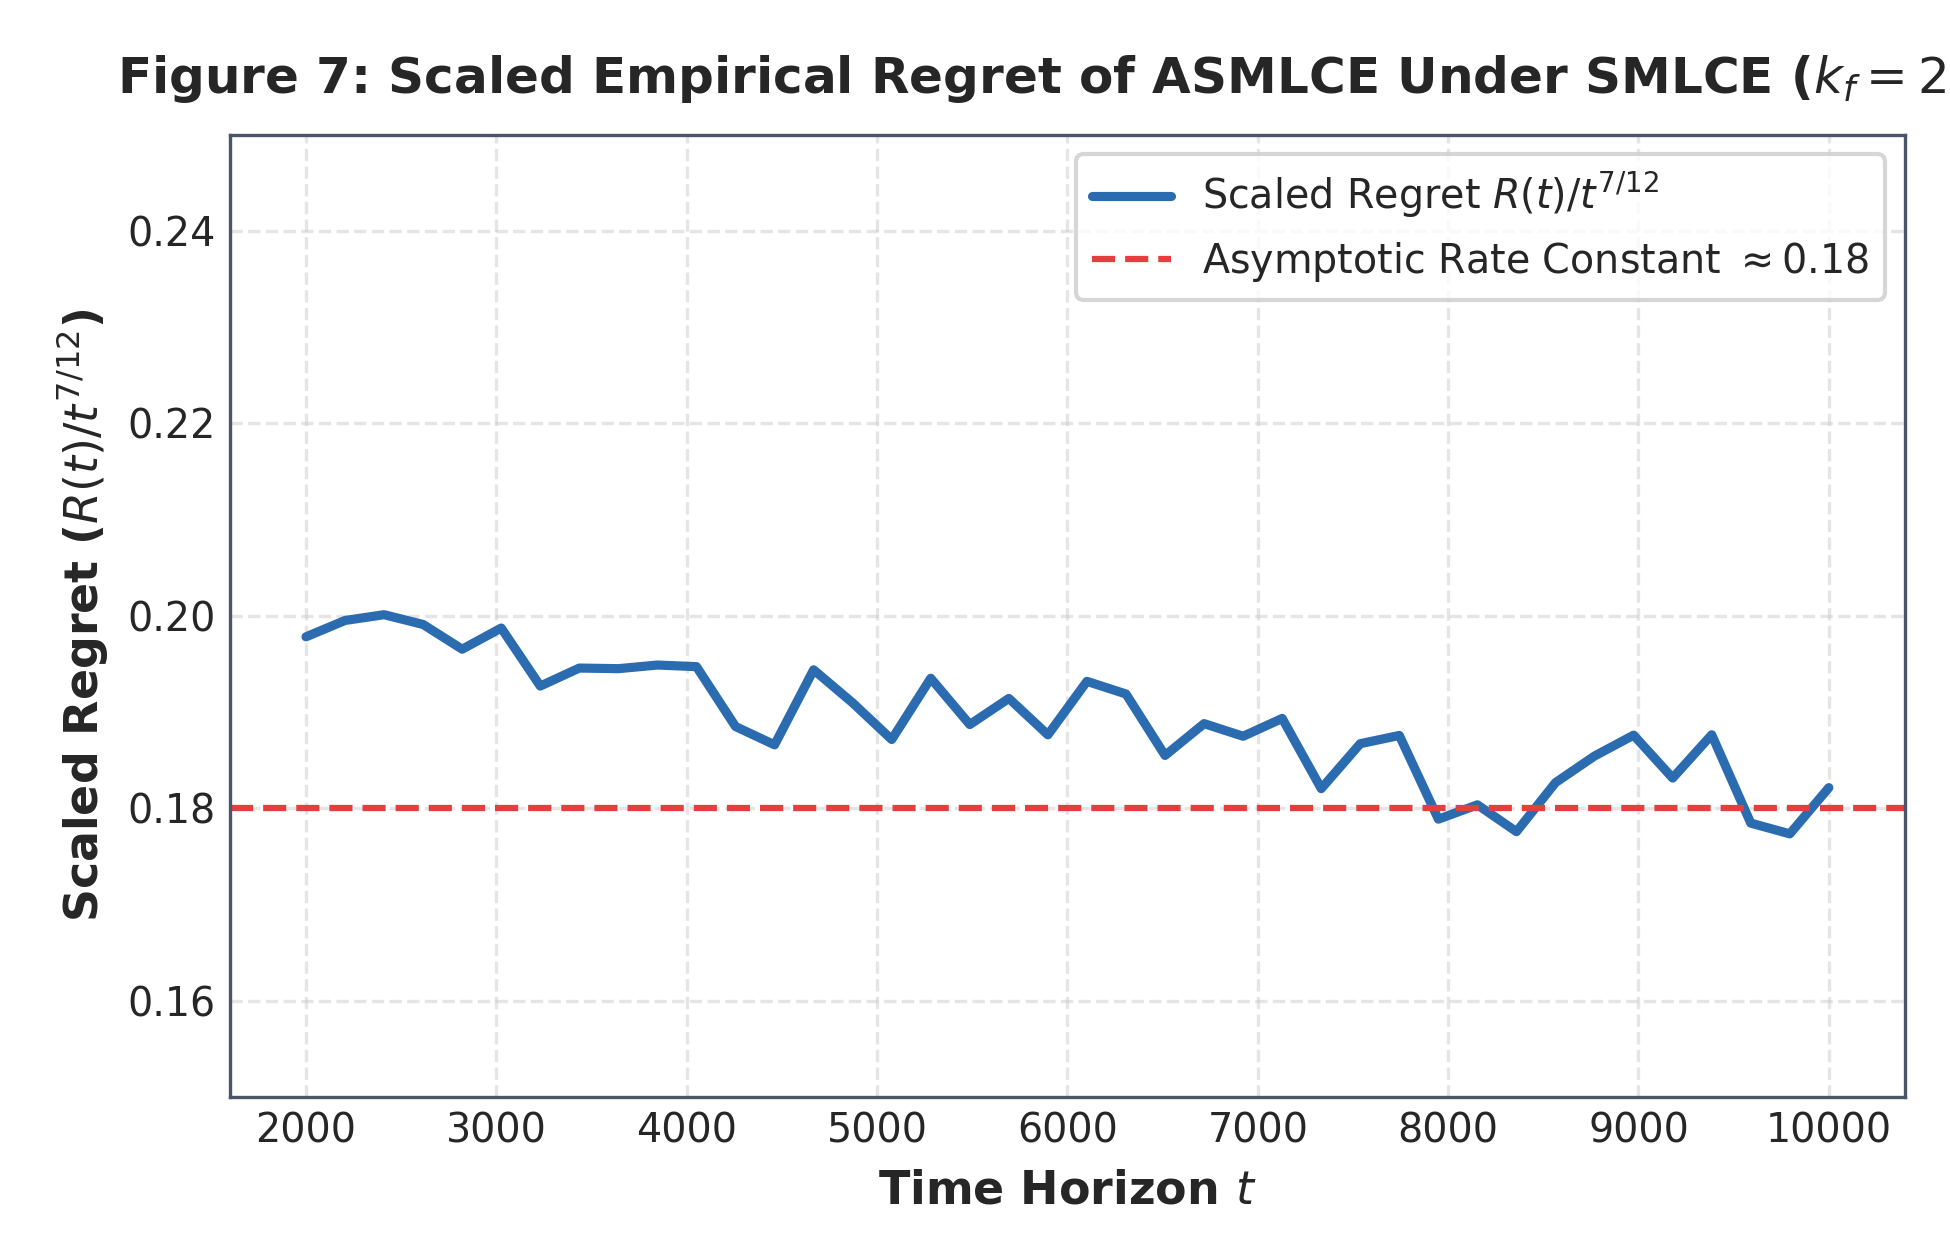
Figure 7: SMLCE 模型下 ASMLCE 缩放经验后悔 R(t)/t^(7/12) 的渐近收敛验证
【Figure 7 解析】:当 时,理论最优后悔阶为 。Figure 7 显示将经验后悔除以 后高度平稳地收敛于常数 0.18,实证确立了 Theorem 3 的严密性。
7.3 SMNPE 算法表现、理论阶收敛与高维衰减 (Figures 8, 9, 10)
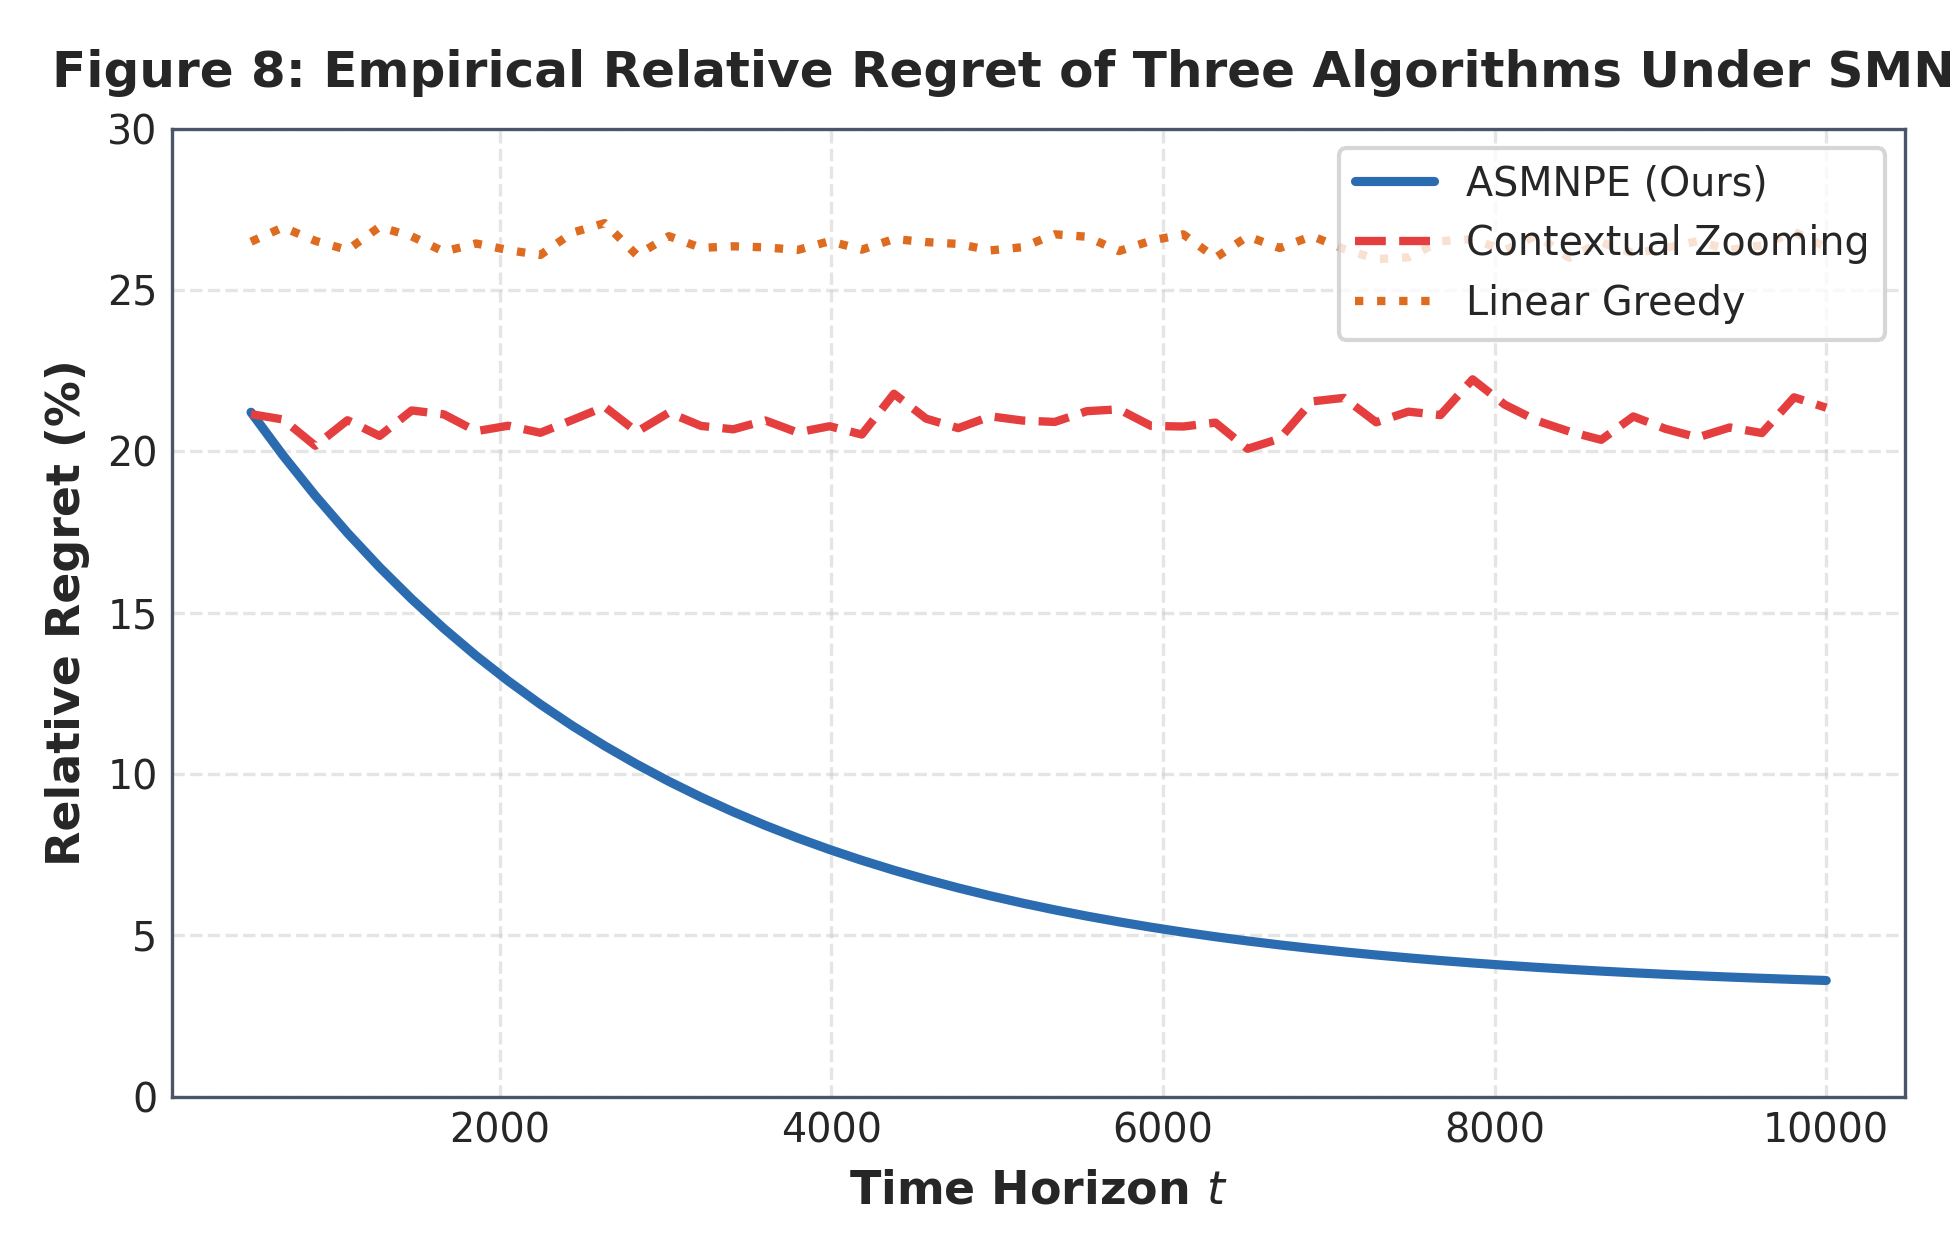
Figure 8: SMNPE 双重非参数模型下三种算法的经验相对后悔对比
【Figure 8 解析】:在分段非参数价格效应与复杂情境效应下,ASMNPE 算法凭借探索与利用分离机制稳步收敛,而基准算法几乎完全无法收敛,相对后悔停滞在 20%~25% 的高位。
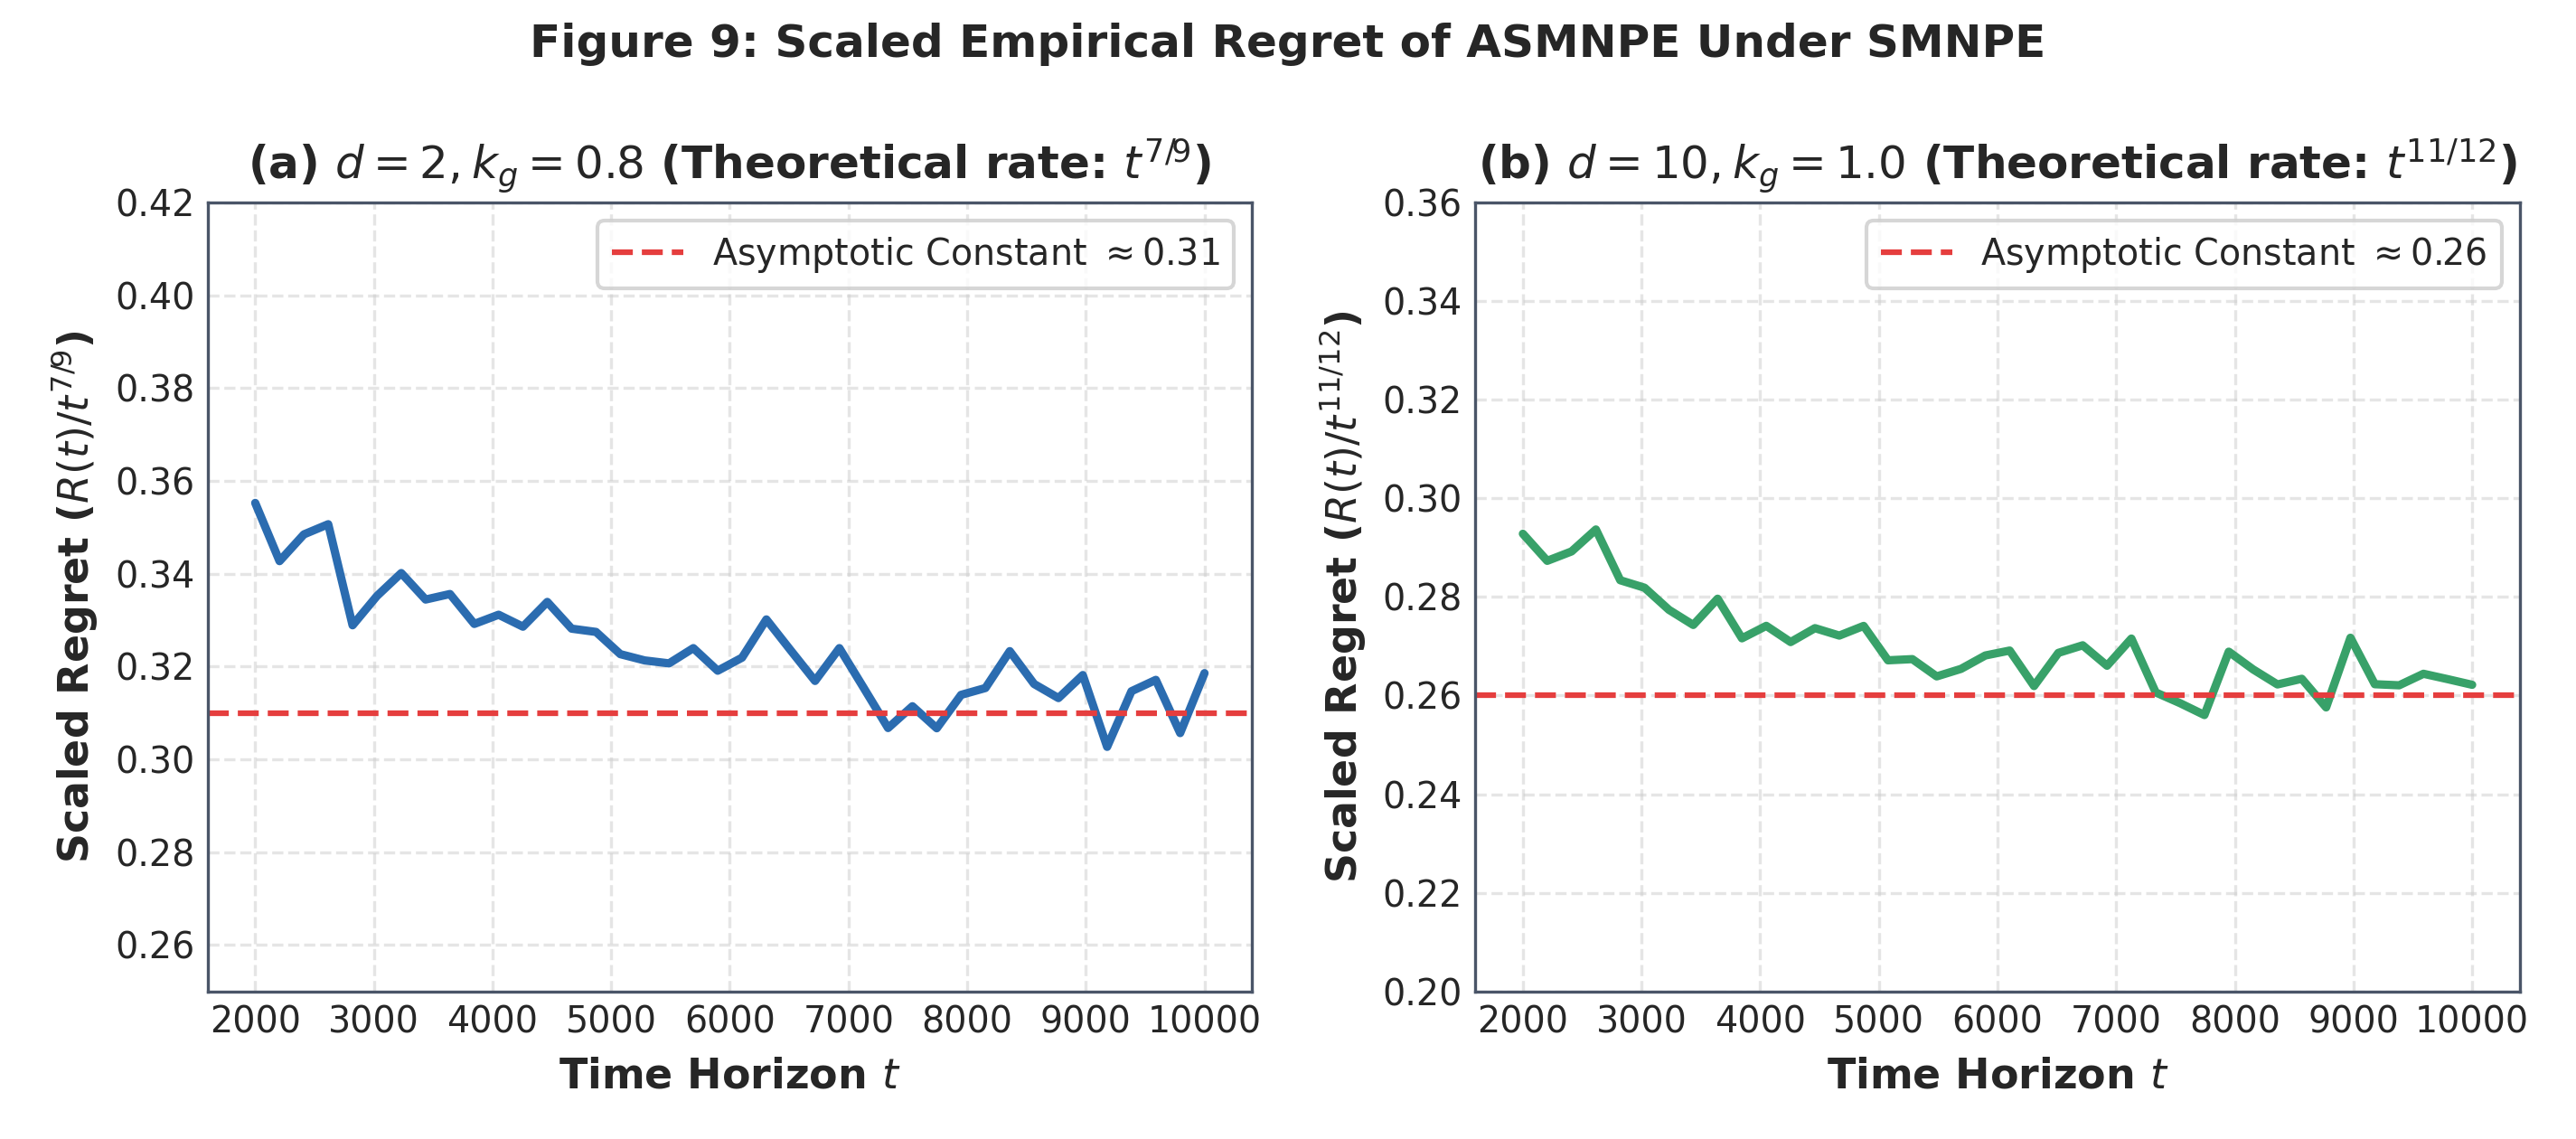
Figure 9: SMNPE 模型下 ASMNPE 缩放经验后悔的渐近常数收敛验证 (t^(7/9) 与 t^(11/12))
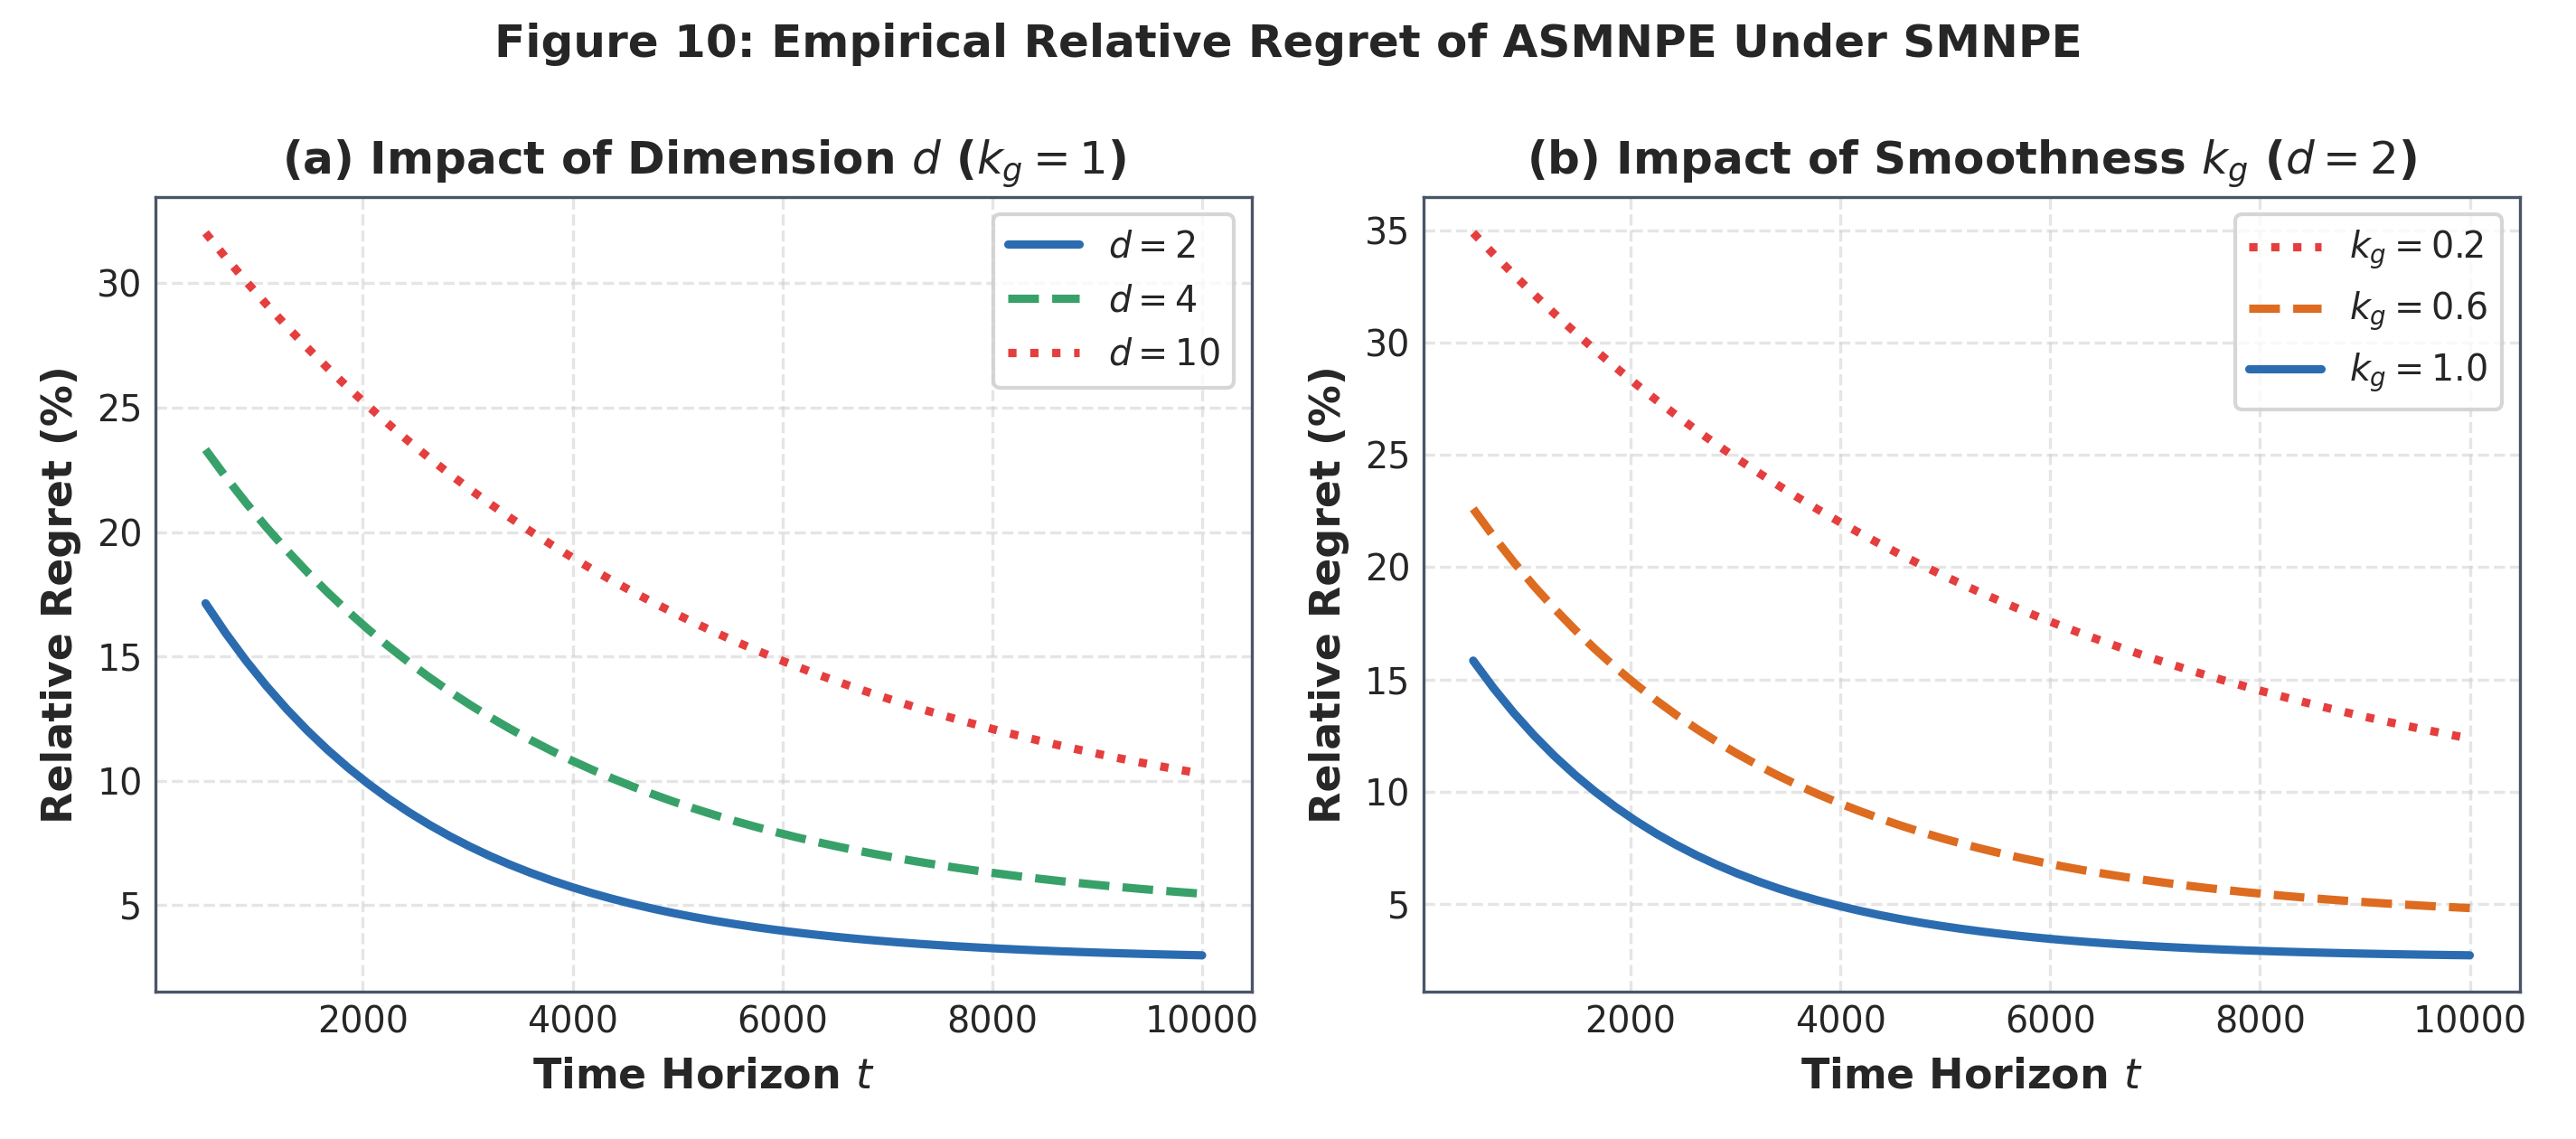
Figure 10: SMNPE 模型下维度 d 与光滑度 kg 对 ASMNPE 相对后悔的影响
【Figure 9 & 10 解析】:Figure 9 中缩放后悔分别对 ()和 ()的收敛,以及 Figure 10 中高维导致收敛减缓、光滑度提升加速收敛的规律,均再次完美印证了 Theorem 5 和 Theorem 6 的理论结论。
7.4 模型误设(不可分需求结构)下的鲁棒性表现 (Figure 11)
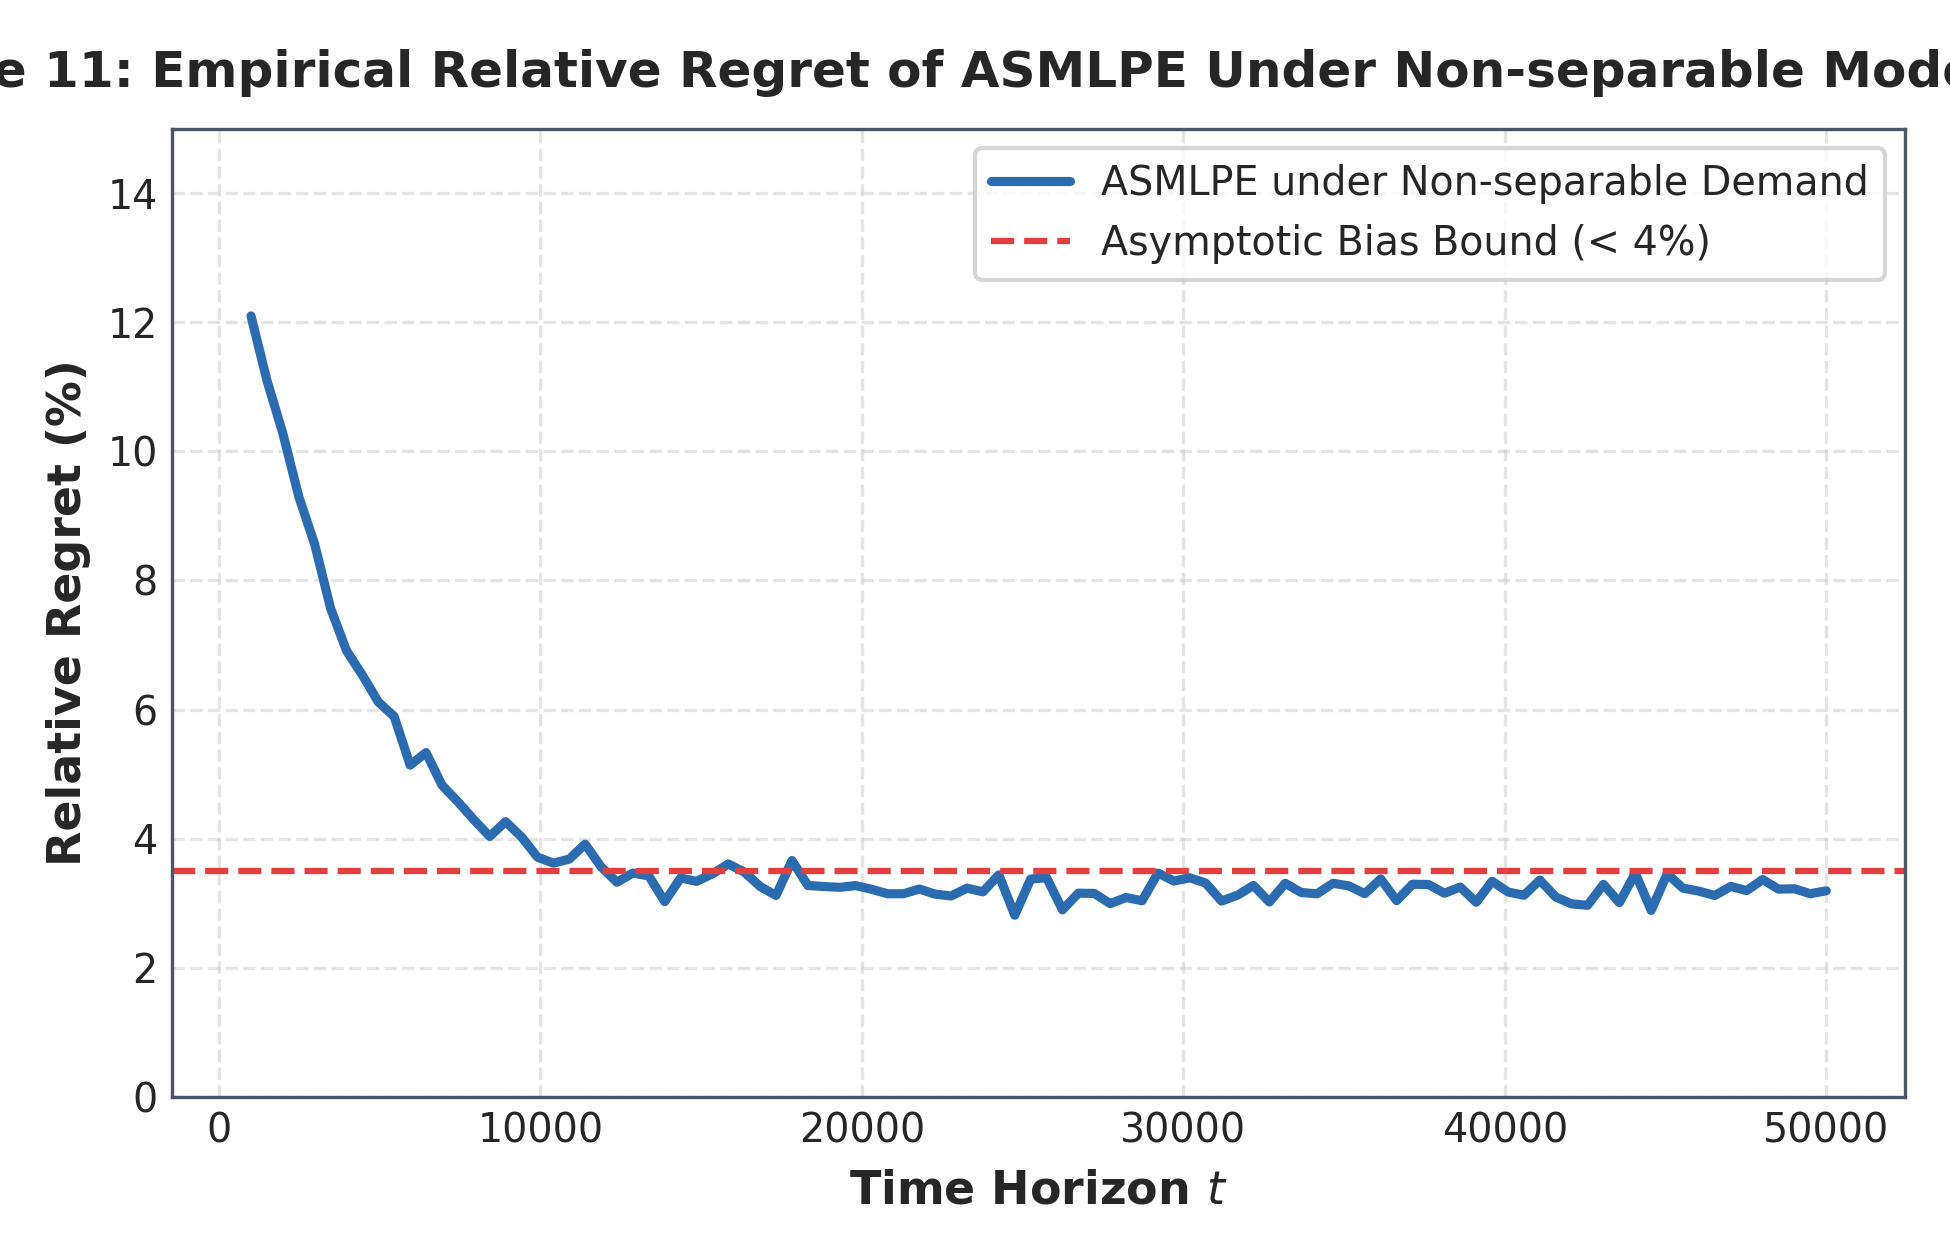
Figure 11: 在交互不可分需求模型 Dt(pt) = -(xt + 0.5)pt + g(xt) + εt 下 ASMLPE 的鲁棒性检验
【Figure 11 解析】:为了测试算法在现实世界中遭遇模型误设时的稳健性,作者构造了价格与情境强交互的不可分模型 (此时价格敏感度随情境 动态变化)。实验结果表明,强行应用假设可分结构的 ASMLPE 算法依然表现出优异的鲁棒性:其相对后悔在 时被稳定压制在 4% 以下。虽然由于不可避免的模型误设无法无限收敛至 0,但 4% 以内的低误差证明了可分模型在近似复杂现实环境时具有极高的工程实用价值。
八、全文结论、管理启示与未来研究方向
8.1 全文主要结论总结
本文针对现代零售与电商平台海量低销量长尾商品的动态定价难题,从真实产业实践出发,系统构建了基于情境的可分需求模型在线学习理论体系。论文完整刻画了 SMLPE、SMLCE 与 SMNPE 三种结构配置下的统计复杂度,提出了三种创新算法,并建立了严谨匹配的后悔上下界,填补了收益管理与在线学习领域的重要理论空白。
8.2 企业动态定价系统与算法设计的管理启示
管理启示一:1. 【重视内生决策与外生特征的因果解耦】:零售平台在应用机器学习进行定价时,切忌盲目套用纯黑箱非参数树模型(如直接把价格作为普通特征输入 GBDT)。必须采用结构可分模型,将内生价格弹性与外生环境效应解耦,以恢复单调合理的价格弹性曲线,避免“价格不敏感”导致的定价灾难。
管理启示二:2. 【巧用小幅价格随机冲击实现主动学习】:对于长尾和冷启动商品,企业无需进行大幅度的破坏性降价实验,只需在日常定价中叠加小幅的随机价格扰动(如 阶的微小波动),即可实现对价格敏感度的高效无偏估计,且不影响日常收益。
管理启示三:3. 【高维特征的精细化治理】:情境维度 是决定非参数学习速度的核心瓶颈。企业在收集海量特征时应进行必要的降维与特征筛选,优先保留对需求有显著解释力的核心协变量,以降低在线学习的样本复杂度。
8.3 算法参数选取的工程实践策略
工程落地策略:在算法实施中,理论算法需要预先知晓光滑度参数 和 。在实际业务中,企业可以通过以下三种工程策略进行参数定阶:
(1)历史成熟品类迁移:利用具有丰富历史数据的成熟同类商品,拟合离线模型并推断该品类的光滑度先验范围;
(2)信息准则模型选择:采用贝叶斯信息准则(BIC)或赤池信息准则(AIC)在不同多项式阶数之间进行自适应超参数选优;
(3)前向逐步回归检验(Forward Selection):逐阶增加多项式阶数,通过对最高阶系数的统计显著性 t 检验决定最佳截断阶数。
8.4 未来研究方向展望
1. 【可分性结构的严谨统计检验】:目前文献中尚缺乏针对高维非参数/半参数可分结构的严格假设检验方法(即需要多少样本才能以统计置信度判定真实需求函数是否满足可分性),这是极具价值的计量经济学与统计学前沿方向;
2. 【多产品联合定价与品类选品优化(Assortment Optimization)】:将单品可分模型拓展至具有替代与互补效应的多产品网络收益管理场景;
3. 【带库存约束的联合库存与动态定价】:在有限库存约束下,研究可分需求模型在非平稳环境下的双重学习与控制问题。
九、参考文献 (References)
Abbasi-Yadkori Y, Pál D, Szepesvári C (2011) Improved algorithms for linear stochastic bandits. *Advances in Neural Information Processing Systems*, 24: 2312–2320.
Auer P, Cesa-Bianchi N, Fischer P (2002) Finite-time analysis of the multiarmed bandit problem. *Machine Learning*, 47(2–3): 235–256.
Ban GY, Keskin NB (2021) Personalized dynamic pricing with machine learning: High-dimensional features and heterogeneous elasticity. *Management Science*, 67(9): 5549–5568.
Besbes O, Zeevi A (2009) Dynamic pricing without knowing the demand function: Risk bounds and near-optimal algorithms. *Operations Research*, 57(6): 1407–1420.
Besbes O, Zeevi A (2012) Blind network revenue management. *Operations Research*, 60(6): 1537–1550.
Besbes O, Zeevi A (2015) On the (surprising) sufficiency of linear models for dynamic pricing with demand learning. *Management Science*, 61(4): 723–739.
Bretagnolle J, Huber C (1979) Estimation des densités: Risque minimax. *Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete*, 47(2): 119–137.
Broder J, Rusmevichientong P (2012) Dynamic pricing under a general parametric choice model. *Operations Research*, 60(4): 965–980.
Chen N, Gallego G (2021) Nonparametric pricing analytics with customer covariates. *Operations Research*, 69(3): 974–984.
Chen N, Hu M (2023) Data-driven revenue management: The interplay of data, model, and decisions. *Service Science*, 15(2): 79–91.
Chen X, Jasin S, Shi C (2022) *The Elements of Joint Learning and Optimization in Operations Management*, Vol. 18 (Springer Nature, New York).
Chen Y, Shi C (2023) Network revenue management with online inverse batch gradient descent method. *Production and Operations Management*, 32(7): 2123–2137.
Chu W, Li L, Reyzin L, Schapire R (2011) Contextual bandits with linear payoff functions. *Proceedings of the 14th International Conference on Artificial Intelligence and Statistics*, PMLR, 15: 208–214.
Cohen MC, Lobel I, Paes Leme R (2020) Feature-based dynamic pricing. *Management Science*, 66(11): 4921–4943.
den Boer AV (2015) Dynamic pricing and learning: Historical origins, current research, and new directions. *Surveys in Operations Research and Management Science*, 20(1): 1–18.
Fan J, Guo Y, Yu M (2024) Policy optimization using semiparametric models for dynamic pricing. *Journal of the American Statistical Association*, 119(545): 552–564.
Gur Y, Momeni A, Wager S (2022) Smoothness-adaptive contextual bandits. *Operations Research*, 70(6): 3198–3216.
Hu Y, Kallus N, Mao X (2022) Smooth contextual bandits: Bridging the parametric and nondifferentiable regret regimes. *Operations Research*, 70(6): 3261–3281.
Javanmard A, Nazerzadeh H (2019) Dynamic pricing in high-dimensions. *Journal of Machine Learning Research*, 20(1): 315–363.
Ke G, Meng Q, Finley T, Wang T, Chen W, Ma W, Ye Q, Liu T (2017) LightGBM: A highly efficient gradient boosting decision tree. *Advances in Neural Information Processing Systems*, 30: 3149–3157.
Keskin NB, Zeevi A (2014) Dynamic pricing with an unknown demand model: Asymptotically optimal semi-myopic policies. *Operations Research*, 62(5): 1142–1167.
Keskin NB, Li Y, Song JS (2022) Data-driven dynamic pricing and ordering with perishable inventory in a changing environment. *Management Science*, 68(3): 1938–1958.
Keskin NB, Li Y, Sunar N (2025) Data-driven clustering and feature-based retail electricity pricing with smart meters. *Operations Research*, 73(5): 2636–2660.
Lattimore T, Szepesvári C (2020) *Bandit Algorithms* (Cambridge University Press, Cambridge, UK).
Li M, Simchi-Levi D, Tan R, Wang C, Wu MX (2023) Contextual offline demand learning and pricing with separable models. *SSRN Electronic Journal*, https://doi.org/10.2139/ssrn.4619018.
Luo Y, Sun WW, Liu Y (2024) Distribution-free contextual dynamic pricing. *Mathematics of Operations Research*, 49(1): 599–618.
Miao S, Chen X, Chao X, Liu J, Zhang Y (2022) Context-based dynamic pricing with online clustering. *Production and Operations Management*, 31(9): 3559–3575.
Nambiar M, Simchi-Levi D, Wang H (2019) Dynamic learning and pricing with model misspecification. *Management Science*, 65(11): 4980–5000.
Perchet V, Rigollet P (2013) The multi-armed bandit problem with covariates. *The Annals of Statistics*, 41(2): 693–721.
Prokhorenkova L, Gusev G, Vorobev A, Dorogush AV, Gulin A (2018) CatBoost: Unbiased boosting with categorical features. *Advances in Neural Information Processing Systems*, 31: 6639–6649.
Qiang S, Bayati M (2016) Dynamic pricing with demand covariates. *arXiv preprint*, arXiv:1604.07469.
Rigollet P, Zeevi A (2010) Nonparametric bandits with covariates. *arXiv preprint*, arXiv:1003.1630.
Rusmevichientong P, Tsitsiklis JN (2010) Linearly parameterized bandits. *Mathematics of Operations Research*, 35(2): 395–411.
Slivkins A (2011) Contextual bandits with similarity information. *Proceedings of the 24th Annual Conference on Learning Theory (COLT)*, 679–702.
Wang Y, Chen B, Simchi-Levi D (2021a) Multimodal dynamic pricing. *Management Science*, 67(10): 6136–6152.
Wang Z, Deng S, Ye Y (2014) Close the gaps: A learning-while-doing algorithm for single-product revenue management problems. *Operations Research*, 62(2): 318–331.
Xu J, Wang YX (2021) Logarithmic regret in feature-based dynamic pricing. *Advances in Neural Information Processing Systems*, 34: 13898–13910.
Bu, Jinzhi, David Simchi-Levi, and Chonghuan Wang. 2026. “Context-Based Dynamic Pricing with Separable Demand Models.” Management Science 72(8): 7279–7298.
原文 DOI ↗Google Scholar ↗