最新研究前沿 · INFORMATION ECONOMICS · MECHANISM DESIGN

Buyer's Hidden Search With Continuous Intensity: The Seller-Optimal Mechanism and a Perverse Effect

具有连续强度的买方隐蔽搜寻:卖方最优机制与反常效应

Dongri Liu · Jingfeng Lu|The RAND Journal of Economics 57(3), 2026, 686–704|完整中文精读 · 536 个网页原生公式 · 14 幅配图 · 中文视频 · 中文音频

VIDEO EXPLAINER · 中文视频

买方隐藏搜索:最优机制与反常效应

AUDIO EXPLAINER · 中文音频

搜索越容易,卖家反而更赚

【论文作者】 Dongri Liu (School of Economics, Shandong University)
Jingfeng Lu (Department of Economics, National University of Singapore) [作者名不翻译]
【发表期刊】 The RAND Journal of Economics, Vol. 57, No. 3, 2026, pp. 686–704. DOI: 10.1111/1756-2171.70062
【JEL 分类号】 D82 (Asymmetric and Private Information; Mechanism Design)
D83 (Search; Learning; Information and Knowledge; Communication; Belief; Unawareness)
D86 (Economics of Contract: Theory)
【关 键 词】 Dynamic mechanism design | Mixed adverse selection and moral hazard | Search intensity | Buy options menu | Search deterrence vs. search facilitation | Perverse effect
【核心结论】 在买方具有连续搜寻强度的动态销售环境中,卖方最优机制可通过依赖于搜寻成本函数的购买期权菜单实现。核心反常效应表明:在温和条件下,降低买方的搜寻成本函数反而能显著提升卖方的期望收益(搜寻威慑效应压倒搜寻便利效应)。

第一章 全文总结与核心理论创新贡献

1.1 研究背景与问题提出

在现实经济活动中,消费者在做出最终购买决策前,通常会开展额外的搜寻以寻找外部替代选项。例如,预订婚宴场地的消费者可以在当前走访的酒店直接下单,也可以投入时间、精力和差旅资金去考察其他酒店、草坪婚礼或目的地婚礼;线上电商平台的买家在浏览特定商家的商品后,可以耗费时间在全网比价并搜寻更具性价比的替代品。消费者所耗费的这些昂贵资源(时间、精力、金钱)构成了其搜寻强度(Search Intensity)。在现实中,搜寻强度 ss 通常是一个连续可调的决策变量(例如一天内投入 00 至 2424 小时不等,或自由设定搜寻预算),而搜寻强度的选择构成了买方对卖方销售机制的内生最优反应。

然而,在经典文献(如 Armstrong and Zhou, 2016, Restud)中,理论模型大多将买方的搜寻决策简化为二元离散选择(Binary Choice,即 s∈{0,s¯}s \in \{ 0,\overline{s}\},要么“不搜寻”,要么“以固定成本 c¯\overline{c} 投入固定强度 s¯\overline{s} 进行搜寻”)。二元模型虽然刻画了搜寻的存在性,却忽略了搜寻努力边际调整的重要经济洞见,并得出了“降低买方搜寻成本必然恶化卖方收益”的单调性结论。为了更真实地刻画现实市场,本文作者 Dongri Liu 和 Jingfeng Lu 在顶级微观经济学期刊《The RAND Journal of Economics》(2026年第57卷第3期)发表了题为《Buyer's Hidden Search With Continuous Intensity: The Seller‐Optimal Mechanism and a Perverse Effect》的重磅论文,建立了具有连续搜寻强度 s∈[0,s¯]s \in \lbrack 0,\overline{s}\rbrack 的两阶段动态机制设计模型,深入探究了连续搜寻对最优机制结构、均衡搜寻努力与卖方收益的深远影响。

1.2 论文的核心理论贡献与边际创新

本文在契约理论、动态机制设计与消费者搜寻理论的交叉前沿做出了以下五大里程碑式的理论贡献:

本文的核心理论贡献提炼

1. 机制设计维度的实质性跃升:将 Armstrong and Zhou (2016) 的离散二元搜寻模型拓展为包含连续私人估值 u∈[0,u¯]u \in \lbrack 0,\overline{u}\rbrack(第一阶段逆向选择)、连续隐蔽搜寻强度 s∈[0,s¯]s \in \lbrack 0,\overline{s}\rbrack(道德风险)以及连续随机外部选项 v∈[0,v¯]v \in \lbrack 0,\overline{v}\rbrack(第二阶段逆向选择)的完全动态机制设计框架。

2. 混合逆向选择与道德风险的最优契合:在一般混合模型中,道德风险约束通常会导致极为复杂的扭曲或一阶方法失效。本文证明在卖方最优机制下,买方的自发最优搜寻强度 ŝ(u,u)\hat{s}(u,u) 与卖方的推荐搜寻强度 s*(u)s^{*}(u) 在最优点完全重合(Align Precisely,ŝ(u,u)≡s*(u)\hat{s}(u,u) \equiv s^{*}(u)),从而使道德风险(Moral Hazard, MH)约束内生非绑定(Non-binding),成功求得全局解析解。

3. 购买期权菜单的内生依赖性:证明卖方最优机制可以通过一个由执行价格与期权溢价构成的购买期权菜单 {p(u),D(u)}\{ p(u),D(u)\} 间接实现。与 Armstrong and Zhou (2016) 中期权溢价 D¯(u)\overline{D}(u) 与搜寻成本完全无关的结论截然相反,连续搜寻模型中的期权溢价 D(u)D(u) 内生依赖于整个搜寻成本函数 c(s)c(s) 的形状与曲率。

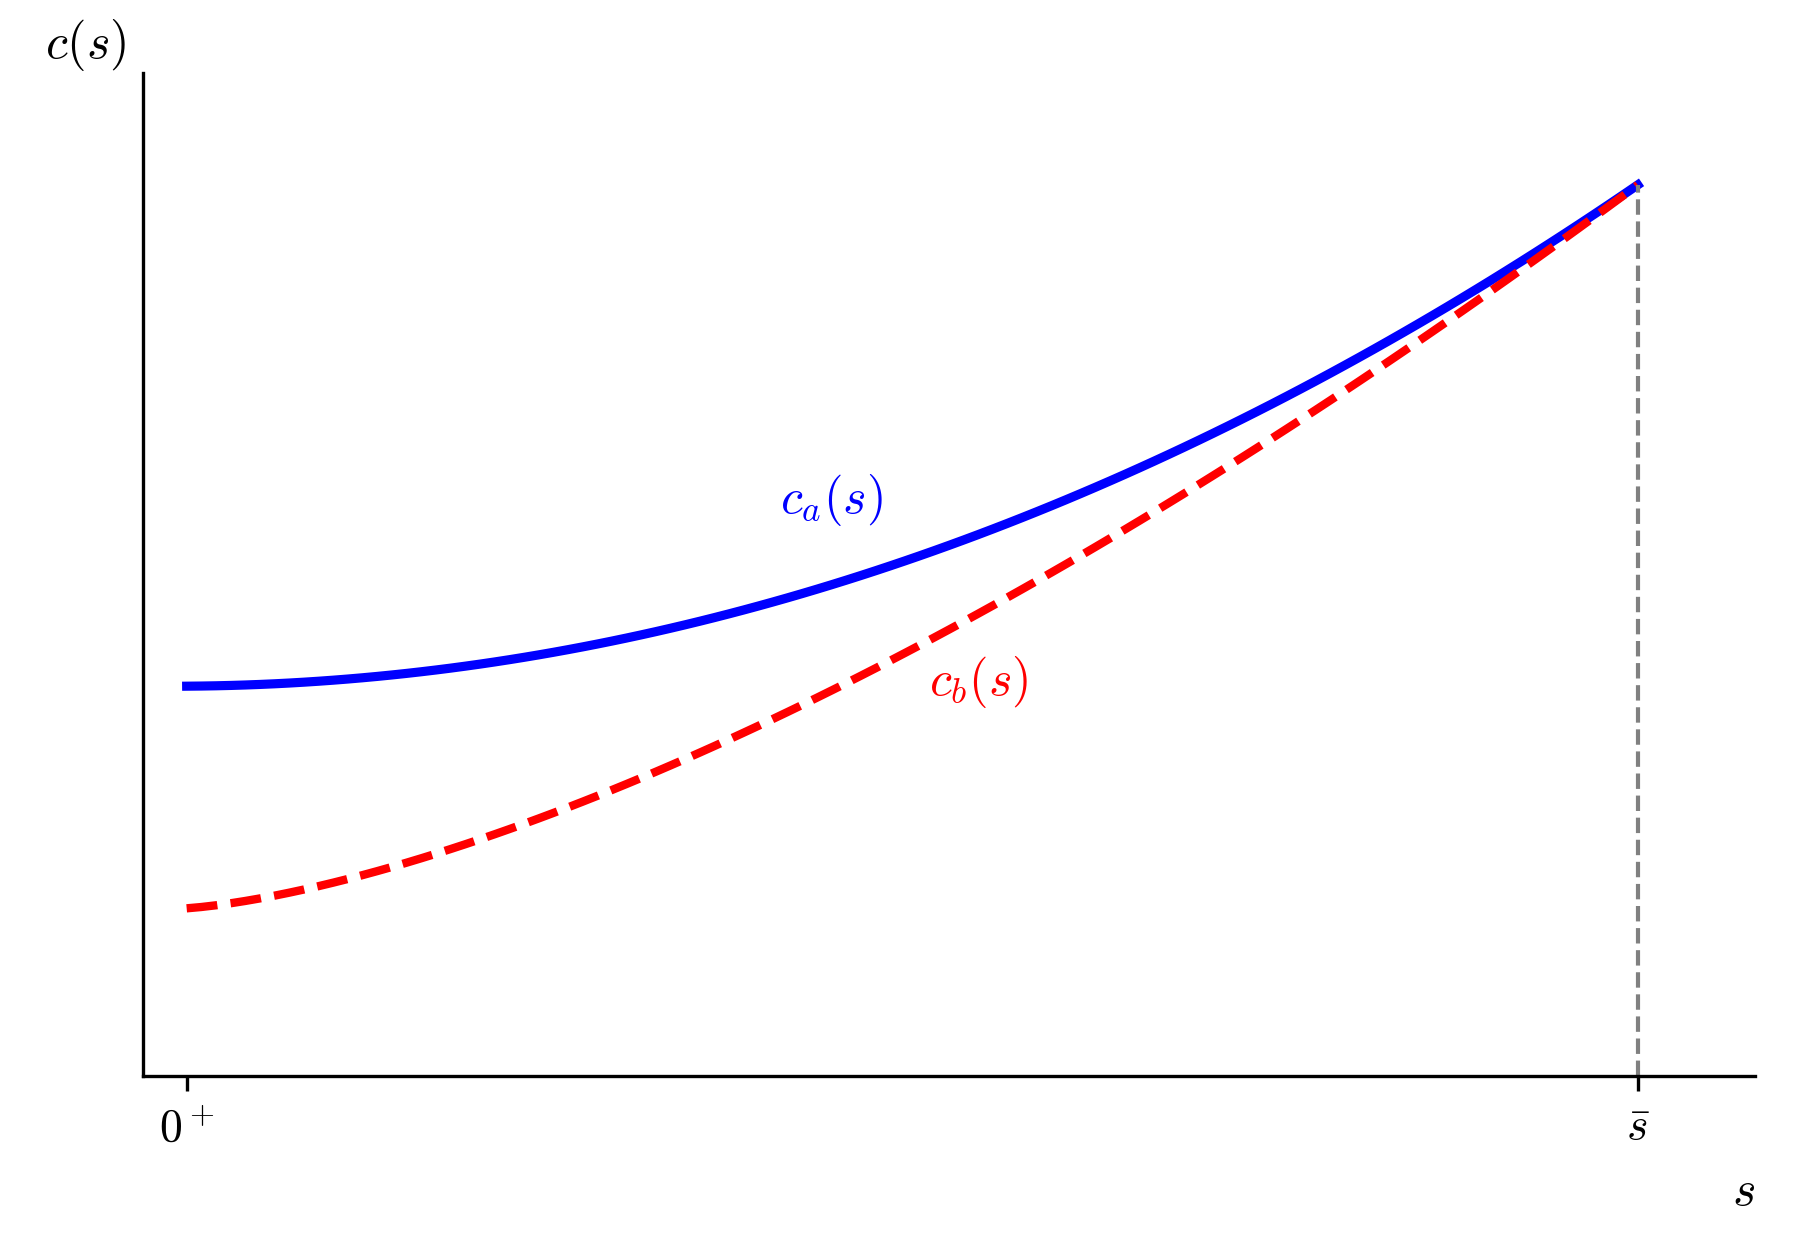
4. 发现并严格证明“反常效应”(Perverse Effect):颠覆了“搜寻成本下降必然损害卖方收益”的传统定论。本文严格证明:在温和充分条件下,降低买方的搜寻成本函数(ca(s)≥cb(s)c_{a}(s) \geq c_{b}(s))不仅不会减少卖方利润,反而会反常地提高卖方收益(Rb*≥Ra*R_{b}^{*} \geq R_{a}^{*})。揭示了搜寻威慑效应(Search Deterrence Effect)对搜寻便利效应(Search Facilitation Effect)的主导机制。

5. 搜寻灵活性价值(Flexibility Value):证明卖方面对具有可变连续搜寻成本 c(s)c(s) 的灵活买方时,其期望收益严格高于面对离散受限搜寻买方时的收益,为平台开放搜寻环境提供了微观经济学理论基石。

1.3 核心悖论现象与微观经济学直觉概述

为什么降低搜寻成本反而可能提升卖方收益?这一反常效应的背后蕴含着两种对立力量的博弈:

(1)搜寻便利效应(Search Facilitation Effect):降低搜寻成本使搜寻对买方更具吸引力,诱使更多类型的买方(特别是临界估值 û\hat{u} 附近的买方)放弃即时购买转而发起搜寻,这会降低卖方的即时成交概率,损害卖方利润。

(2)搜寻威慑效应(Search Deterrence Effect):当搜寻成本函数的整体水平下降但其曲率发生改变(例如在特定搜寻强度区间内边际搜寻成本 c′(s)c\prime(s) 更高)时,正在进行搜寻的高估值买方的最优搜寻努力会被抑制,从而降低了其找到优质外部选项的概率,增加了其事后行使购买期权返回当前卖方的概率,进而提升卖方的延后购买收益。

当成本函数的下降以特定形态发生时,卖方为吸引买方接受机制所需让渡的信息租金(即买方拒绝机制直接搜寻的机会成本 ΔB(u)≡B(0,s*(0))−B(λ(u),s*(u))\Delta B(u) \equiv B(0,s^{*}(0)) - B(\lambda(u),s^{*}(u)))被大幅压缩,搜寻威慑效应完全压倒搜寻便利效应,从而驱动卖方总收益出现反直觉的逆势上涨。

第二章 数理模型建立与博弈时序详细解析

2.1 参与人、私人信息与标的物设定

考虑一个风险中性的卖方(Seller,女性代词 she,委托人 Principal)向一个风险中性的买方(Buyer,男性代词 he,代理人 Agent)出售一件不可分割的商品或服务。卖方对该标的物的保留价值标准化为 00,卖方的目标是最大化自身的期望总收益。

买方对卖方标的物的真实估值记为 uu,属于一维连续支撑集 [0,u¯]\lbrack 0,\overline{u}\rbrack(以下称为买方的第一阶段类型或初始估值)。估值 uu 服从先验累积分布函数 F(u)F(u),对应的概率密度函数为 f(u)>0f(u) > 0。假定 F(u)F(u) 是二次连续可微的,并且满足微观经济学和机制设计中标准的单调危险率假设(Monotone Hazard Rate Condition, MHR),即危险率的反函数满足:

ddu(1−F(u)f(u))≤0\frac{d}{du}\left( \frac{1 - F(u)}{f(u)} \right) \leq 0

单调危险率保证了卖方的虚拟价值函数(Virtual Valuation)λ(u)≡u−1−F(u)f(u)\lambda(u) \equiv u - \frac{1 - F(u)}{f(u)} 在买方估值空间上严格单调递增,排除了复杂的熨平(Ironing)技术需求。

2.2 外部选项、连续搜寻强度与成本结构

除了从当前卖方处购买标的物外,买方还可以在市场上搜寻外部替代品。将买方从外部替代品中获得的净收益记为 v∈[0,v¯]v \in \lbrack 0,\overline{v}\rbrack(以下称为外部收益或第二阶段类型)。如果买方同时消费外部替代品和卖方标的物,在忽略任何向卖方支付的转移支付前提下,买方获得的毛效用为 max{u,v}\max\{ u,v\}。这意味着外部替代品与卖方标的物具有功能可替代性,买方仅在外部收益 vv 严格大于标的物估值 uu 时,才能从外部选项中获得额外的增量剩余 v−u>0v - u > 0。

与以往文献不同,本文设定买方的搜寻强度 ss 是一个在闭区间 [0,s¯]\lbrack 0,\overline{s}\rbrack 上连续可取的内生变量,其中 s=0s = 0 表示完全不进行搜寻,s=s¯s = \overline{s} 代表系统允许的最大搜寻强度。在给定搜寻强度 ss 下,外部收益 vv 的条件累积分布函数记为 G(v|s)G(v|s),其搜寻成本函数记为 c(s)c(s)。模型对 G(v|s)G(v|s) 和 c(s)c(s) 做出如下标准的正则性假设:

Assumption 1 & Assumption 2:分布与成本结构假设

【Assumption 1(外部选项分布的一阶随机占优与边际递减)】

设定 G(⋅|0)=1G( \cdot |0) = 1(不搜寻时外部收益退化为 00)。当 s∈(0,s¯]s \in (0,\overline{s}\rbrack 时,G(v|s)G(v|s) 关于 ss 和 vv 二次连续可微,且满足:

(1) G2(v|s)=∂G(v|s)∂s≤0G_{2}(v|s) = \frac{\partial G(v|s)}{\partial s} \leq 0:更高的搜寻努力在一阶随机占优(FOSD)意义下带来更优的外部收益分布;

(2) G22(v|s)=∂2G(v|s)∂s2≥0G_{22}(v|s) = \frac{\partial^{2}G(v|s)}{\partial s^{2}} \geq 0:搜寻强度对外部收益分布改善的边际效应递减。

【Assumption 2(搜寻成本函数的单调性与凸性)】

设定 c(0)=0c(0) = 0。当 s∈(0,s¯]s \in (0,\overline{s}\rbrack 时,c(s)c(s) 二次连续可微,且满足:

(1) c′(s)≥0c\prime(s) \geq 0 且 c′′(s)≥0c\prime\prime(s) \geq 0:搜寻成本关于搜寻强度严格递增且严格凸;

(2) c′(0+)=0c\prime(0^{+}) = 0:保证买方一旦决定发起搜寻,其最优正搜寻强度内生存在;

(3) c(0+)≥0c(0^{+}) \geq 0:允许存在发起搜寻的固定启动成本(Fixed Setup Cost)。

G2(v|s)≤0,G22(v|s)≥0,∀v∈[0,v¯],s∈(0,s¯]G_{2}(v|s) \leq 0,G_{22}(v|s) \geq 0,\forall v \in \lbrack 0,\overline{v}\rbrack,s \in (0,\overline{s}\rbrack

c′(s)≥0,c′′(s)≥0,c′(0+)=0,c(0+)≥0c\prime(s) \geq 0,c\prime\prime(s) \geq 0,c\prime(0^{+}) = 0,c(0^{+}) \geq 0

2.3 两阶段动态销售机制与博弈时序

根据 Myerson (1986) 的多阶段博弈显示原理(Revelation Principle),卖方的最优机制可以在直接显示机制(Direct Mechanism)类中求解。卖方在博弈开始时承诺一个两阶段契约:

M≡{x(u′),t(u′),s(u′),X(u′,v′),T(u′,v′)}M \equiv \{ x(u\prime),t(u\prime),s(u\prime),X(u\prime,v\prime),T(u\prime,v\prime)\}

其中各项契约变量的经济学含义定义如下:

• u′∈[0,u¯]u\prime \in \lbrack 0,\overline{u}\rbrack:买方在第一阶段向机制汇报的估值类型;

• x(u′)∈[0,1]x(u\prime) \in \lbrack 0,1\rbrack:第一阶段根据汇报 u′u\prime 确定的即时成交分配概率;

• t(u′)∈ℝt(u\prime) \in {\mathbb{R}}:第一阶段根据汇报 u′u\prime 收取的转移支付;

• s(u′)∈[0,s¯]s(u\prime) \in \lbrack 0,\overline{s}\rbrack:当第一阶段未发生成交时,机制向买方推荐的搜寻强度;

• v′∈[0,v¯]v\prime \in \lbrack 0,\overline{v}\rbrack:买方在第二阶段向机制汇报的外部收益实现值;

• X(u′,v′)∈[0,1]X(u\prime,v\prime) \in \lbrack 0,1\rbrack:第二阶段在历史汇报 (u′,v′)(u\prime,v\prime) 下的延后成交分配概率;

• T(u′,v′)∈ℝT(u\prime,v\prime) \in {\mathbb{R}}:第二阶段在历史汇报 (u′,v′)(u\prime,v\prime) 下收取的延后转移支付。

博弈的时序进程(Timing of the Game)精确展开如下:

【阶段 0(Stage 0:机制公布与参与决策)】买方私下观察到自身的真实估值 uu。卖方公布并承诺执行两阶段销售机制 MM。若买方拒绝该机制,博弈脱离机制,买方在第一阶段可自主决定是否发起搜寻;若买方接受该机制,博弈进入第一阶段。

【阶段 1(Stage 1:初始汇报、即时结算与搜寻决策)】买方向机制汇报估值 u′u\prime。机制收取费用 t(u′)t(u\prime) 并以概率 x(u′)x(u\prime) 将标的物分配给买方。若标的物在阶段 1 成功售出,博弈终止,买方在获得标的物后自主决定是否搜寻;若标的物在阶段 1 未售出(概率为 1−x(u′)1 - x(u\prime)),机制推荐买方以强度 s(u′)s(u\prime) 展开搜寻。买方私下自主选择实际搜寻强度 ss(买方可以选择服从推荐 s=s(u′)s = s(u\prime),也可以违规偏离),并承担搜寻成本 c(s)c(s)。阶段 1 结束后,不再有新的搜寻机会。

【阶段 2(Stage 2:外部收益实现、二次汇报与延后结算)】买方的外部收益 vv 按照分布 G(v|s)G(v|s) 私下实现。买方向机制汇报外部收益 v′v\prime。机制收取第二阶段费用 T(u′,v′)T(u\prime,v\prime) 并以概率 X(u′,v′)X(u\prime,v\prime) 交付标的物。博弈全部结束,各方结算最终收益。

2.4 与 Armstrong and Zhou (2016) 模型的系统对比

为了清晰凸显本文模型的一般性与突破性,下表系统对比了本文模型与经典文献 Armstrong and Zhou (2016) 的核心结构差异:

对比维度 Armstrong and Zhou (2016) 基准模型 本文连续搜寻强度模型 (Liu and Lu, 2026)
买方估值类型 uu 一维连续分布 u∈[0,u¯]u \in \lbrack 0,\overline{u}\rbrack 一维连续分布 u∈[0,u¯]u \in \lbrack 0,\overline{u}\rbrack
外部收益类型 vv 一维连续分布 v∈[0,v¯]v \in \lbrack 0,\overline{v}\rbrack 一维连续分布 v∈[0,v¯]v \in \lbrack 0,\overline{v}\rbrack
搜寻强度选择 ss 二元离散选择 s∈{0,s¯}s \in \{ 0,\overline{s}\} 全区间连续可变 s∈[0,s¯]s \in \lbrack 0,\overline{s}\rbrack
搜寻成本结构 固定常数 c¯\overline{c}(独立于努力程度) 凸成本函数 c(s)c(s),边际成本 c′(s)c\prime(s) 连续变化
外部收益条件分布 固定不变分布 G¯(v)\overline{G}(v) 内生受控分布 G(v|s)G(v|s),满足一阶随机占优

表 1:本文模型与 Armstrong and Zhou (2016) 核心设定对比

可以看出,Armstrong and Zhou (2016) 模型是本文在搜寻成本函数为平坦常数 c(s)≡c¯c(s) \equiv \overline{c} 时的退化特例。连续搜寻强度的引入使得买方在面对不同机制设计时具有更细腻的边际调整空间,极大地丰富了机制设计的约束形态。

第三章 逆向归纳法与卖方最优机制数理推导

3.1 第二阶段事后决策与激励约束分析

采用逆向归纳法(Backward Induction),首先分析阶段 2 中类型为 (u,v)(u,v) 的买方行为。假定买方在阶段 1 如实汇报了 uu,在阶段 2 真实外部收益为 vv 但汇报为 v′v\prime。给定机制 MM,买方的第二阶段偏离收益为:

π∼(v,v′;u)=X(u,v′)max{u−v,0}−T(u,v′)+v\overset{\sim}{\pi}(v,v\prime;u) = X(u,v\prime)\max\{ u - v,0\} - T(u,v\prime) + v

第二阶段激励兼容约束(AS-2)要求买方如实汇报外部收益 vv:

π∼(v,v;u)≥π∼(v,v′;u),∀v′∈[0,v¯](AS−2)\overset{\sim}{\pi}(v,v;u) \geq \overset{\sim}{\pi}(v,v\prime;u),\forall v\prime \in \lbrack 0,\overline{v}\rbrack(AS - 2)

第二阶段个体理性约束(IR-2)要求买方自愿参与第二阶段交易:

π∼(v,v;u)≥v,∀v∈[0,v¯](IR−2)\overset{\sim}{\pi}(v,v;u) \geq v,\forall v \in \lbrack 0,\overline{v}\rbrack(IR - 2)

Lemma 1(第二阶段分配规则的半单调性)

在第二阶段逆向选择约束(AS-2)下,第二阶段分配规则 X(u,⋅)X(u, \cdot ) 必须满足如下半单调性(Semi-monotonicity):

(i) 对于任意给定的 uu,X(u,v)X(u,v) 在区间 [0,u]\lbrack 0,u\rbrack 上关于 vv 弱单调递减;

(ii) 当 v∈[0,u)v \in \lbrack 0,u) 且 v′∈[u,v¯]v\prime \in \lbrack u,\overline{v}\rbrack 时,恒有 X(u,v)≥X(u,v′)X(u,v) \geq X(u,v\prime);而在区间 [u,v¯]\lbrack u,\overline{v}\rbrack 内部,AS-2 对 X(u,⋅)X(u, \cdot ) 不施加任何单调性约束。

【Lemma 1 的数理证明推导】

由 AS-2 约束,对于任意两点 vv 和 v′v\prime,买方在真实类型为 vv 时的真实汇报收益不低于汇报 v′v\prime 的收益:

π∼(v,v;u)−π∼(v′,v′;u)≥X(u,v′)[max{u−v,0}−max{u−v′,0}]+v−v′\overset{\sim}{\pi}(v,v;u) - \overset{\sim}{\pi}(v\prime,v\prime;u) \geq X(u,v\prime)\lbrack\max\{ u - v,0\} - \max\{ u - v\prime,0\}\rbrack + v - v\prime

交换 vv 与 v′v\prime 的角色,同理可得:

π∼(v′,v′;u)−π∼(v,v;u)≥X(u,v)[max{u−v′,0}−max{u−v,0}]+v′−v\overset{\sim}{\pi}(v\prime,v\prime;u) - \overset{\sim}{\pi}(v,v;u) \geq X(u,v)\lbrack\max\{ u - v\prime,0\} - \max\{ u - v,0\}\rbrack + v\prime - v

将上述两个不等式左右两边相加,中间收益项相互抵消,整理得到:

[X(u,v′)−X(u,v)]⋅[max{u−v,0}−max{u−v′,0}]≤0\lbrack X(u,v\prime) - X(u,v)\rbrack \cdot \lbrack\max\{ u - v,0\} - \max\{ u - v\prime,0\}\rbrack \leq 0

设 v<v′v < v\prime。分情形讨论:

(1)若 v,v′∈[0,u]v,v\prime \in \lbrack 0,u\rbrack,或 v∈[0,u)v \in \lbrack 0,u) 且 v′∈[u,v¯]v\prime \in \lbrack u,\overline{v}\rbrack,则 max{u−v,0}−max{u−v′,0}>0\max\{ u - v,0\} - \max\{ u - v\prime,0\} > 0。为使乘积非正,必须有 X(u,v′)−X(u,v)≤0X(u,v\prime) - X(u,v) \leq 0,即 X(u,v)≥X(u,v′)X(u,v) \geq X(u,v\prime),证明了区间 [0,u]\lbrack 0,u\rbrack 上的弱递减性以及跨越分界点 uu 的单调性。

(2)若 v,v′∈[u,v¯]v,v\prime \in \lbrack u,\overline{v}\rbrack,则 max{u−v,0}=max{u−v′,0}=0\max\{ u - v,0\} = \max\{ u - v\prime,0\} = 0,上述不等式恒为 0≤00 \leq 0。这意味着当外部收益已经超过买方对标的物的估值时,买方根本无意消费卖方标的物,此时次级分配规则 X(u,⋅)X(u, \cdot ) 在该区间上不受单调性限制。证毕。

接下来,必须确定当买方在第一阶段撒谎汇报了 u′u\prime 之后,在第二阶段面对外部实现值 vv 时的最优跟进谎言 σ(v;u,u′)\sigma(v;u,u\prime)。这是分析跨阶段联合偏离(Joint Deviations)的关键工具。

Lemma 2(买方一阶段撒谎后的最优二阶段汇报策略)

给定(AS-2)约束成立,若类型为 (u,v)(u,v) 的买方在第一阶段偏离汇报了 u′u\prime,则其在第二阶段的最优汇报策略 σ(v;u,u′)\sigma(v;u,u\prime) 为:

σ(v;u,u′)=u′−u+v\sigma(v;u,u\prime) = u\prime - u + v, 若 0≤u−v≤u′0 \leq u - v \leq u\prime;

σ(v;u,u′)=v¯\sigma(v;u,u\prime) = \overline{v}, 若 u−v<0u - v < 0;

σ(v;u,u′)=0\sigma(v;u,u\prime) = 0, 若 u−v>u′u - v > u\prime。

{u′−u+v,若0≤u−v≤u′v¯,若u−v<00,若u−v>u′\left\{ \begin{matrix} u\prime - u + v, & 若\ 0 \leq u - v \leq u\prime \\ \overline{v}, & 若\ u - v < 0 \\ 0, & 若\ u - v > u\prime \end{matrix} \right.\

【Lemma 2 的数理证明与经济学解释】

买方在第二阶段选择 v′v\prime 最大化其偏离收益:

maxv′∈[0,v¯]π∼(v,v′;u,u′)≡X(u′,v′)max{u−v,0}−T(u′,v′)+v\max_{v\prime \in \lbrack 0,\overline{v}\rbrack}\overset{\sim}{\pi}(v,v\prime;u,u\prime) \equiv X(u\prime,v\prime)\max\{ u - v,0\} - T(u\prime,v\prime) + v

由阶段 2 的 AS-2 约束,对于契约 u′u\prime 而言,对于任意 v′,v′′v\prime,v\prime\prime 均有:

[X(u′,v′)−X(u′,v′′)]max{u′−v′,0}≥T(u′,v′)−T(u′,v′′)\lbrack X(u\prime,v\prime) - X(u\prime,v\prime\prime)\rbrack\max\{ u\prime - v\prime,0\} \geq T(u\prime,v\prime) - T(u\prime,v\prime\prime)

若买方选取的汇报 v′v\prime 能够满足“拟合恒等式”:

max{u′−v′,0}=max{u−v,0}\max\{ u\prime - v\prime,0\} = \max\{ u - v,0\}

则代入上述不等式直接可得:[X(u′,v′)−X(u′,v′′)]max{u−v,0}≥T(u′,v′)−T(u′,v′′)\lbrack X(u\prime,v\prime) - X(u\prime,v\prime\prime)\rbrack\max\{ u - v,0\} \geq T(u\prime,v\prime) - T(u\prime,v\prime\prime),即 π∼(v,v′;u,u′)≥π∼(v,v′′;u,u′)\overset{\sim}{\pi}(v,v\prime;u,u\prime) \geq \overset{\sim}{\pi}(v,v\prime\prime;u,u\prime),此时汇报 v′v\prime 构成对所有其他可能汇报的弱占优策略。

• 情形 1(完全修复谎言):当 0≤u−v≤u′0 \leq u - v \leq u\prime 时,令 u′−v′=u−vu\prime - v\prime = u - v,解得 v′=u′−u+v∈[0,v¯]v\prime = u\prime - u + v \in \lbrack 0,\overline{v}\rbrack。此时买方通过在第二阶段精巧地微调汇报,完美还原了自身的事后净剩余 max{u−v,0}\max\{ u - v,0\},实现了对第一阶段谎言的完全事后修正。

• 情形 2(外部选项绝对占优):当 u−v<0u - v < 0 时,买方必然消费外部选项,事后净剩余为 00。买方汇报最高外部类型 v′=v¯v\prime = \overline{v} 是弱占优的。

• 情形 3(标的物价值极大):当 u−v>u′u - v > u\prime 时,不存在区间内的 v′v\prime 能满足拟合恒等式。由 Lemma 1 的半单调性,X(u′,0)≥X(u′,v′′)X(u\prime,0) \geq X(u\prime,v\prime\prime),买方通过汇报最低外部类型 v′=0v\prime = 0 来最大化获得标的物的概率。证毕。

3.2 第一阶段搜寻收益函数与搜寻决策分析

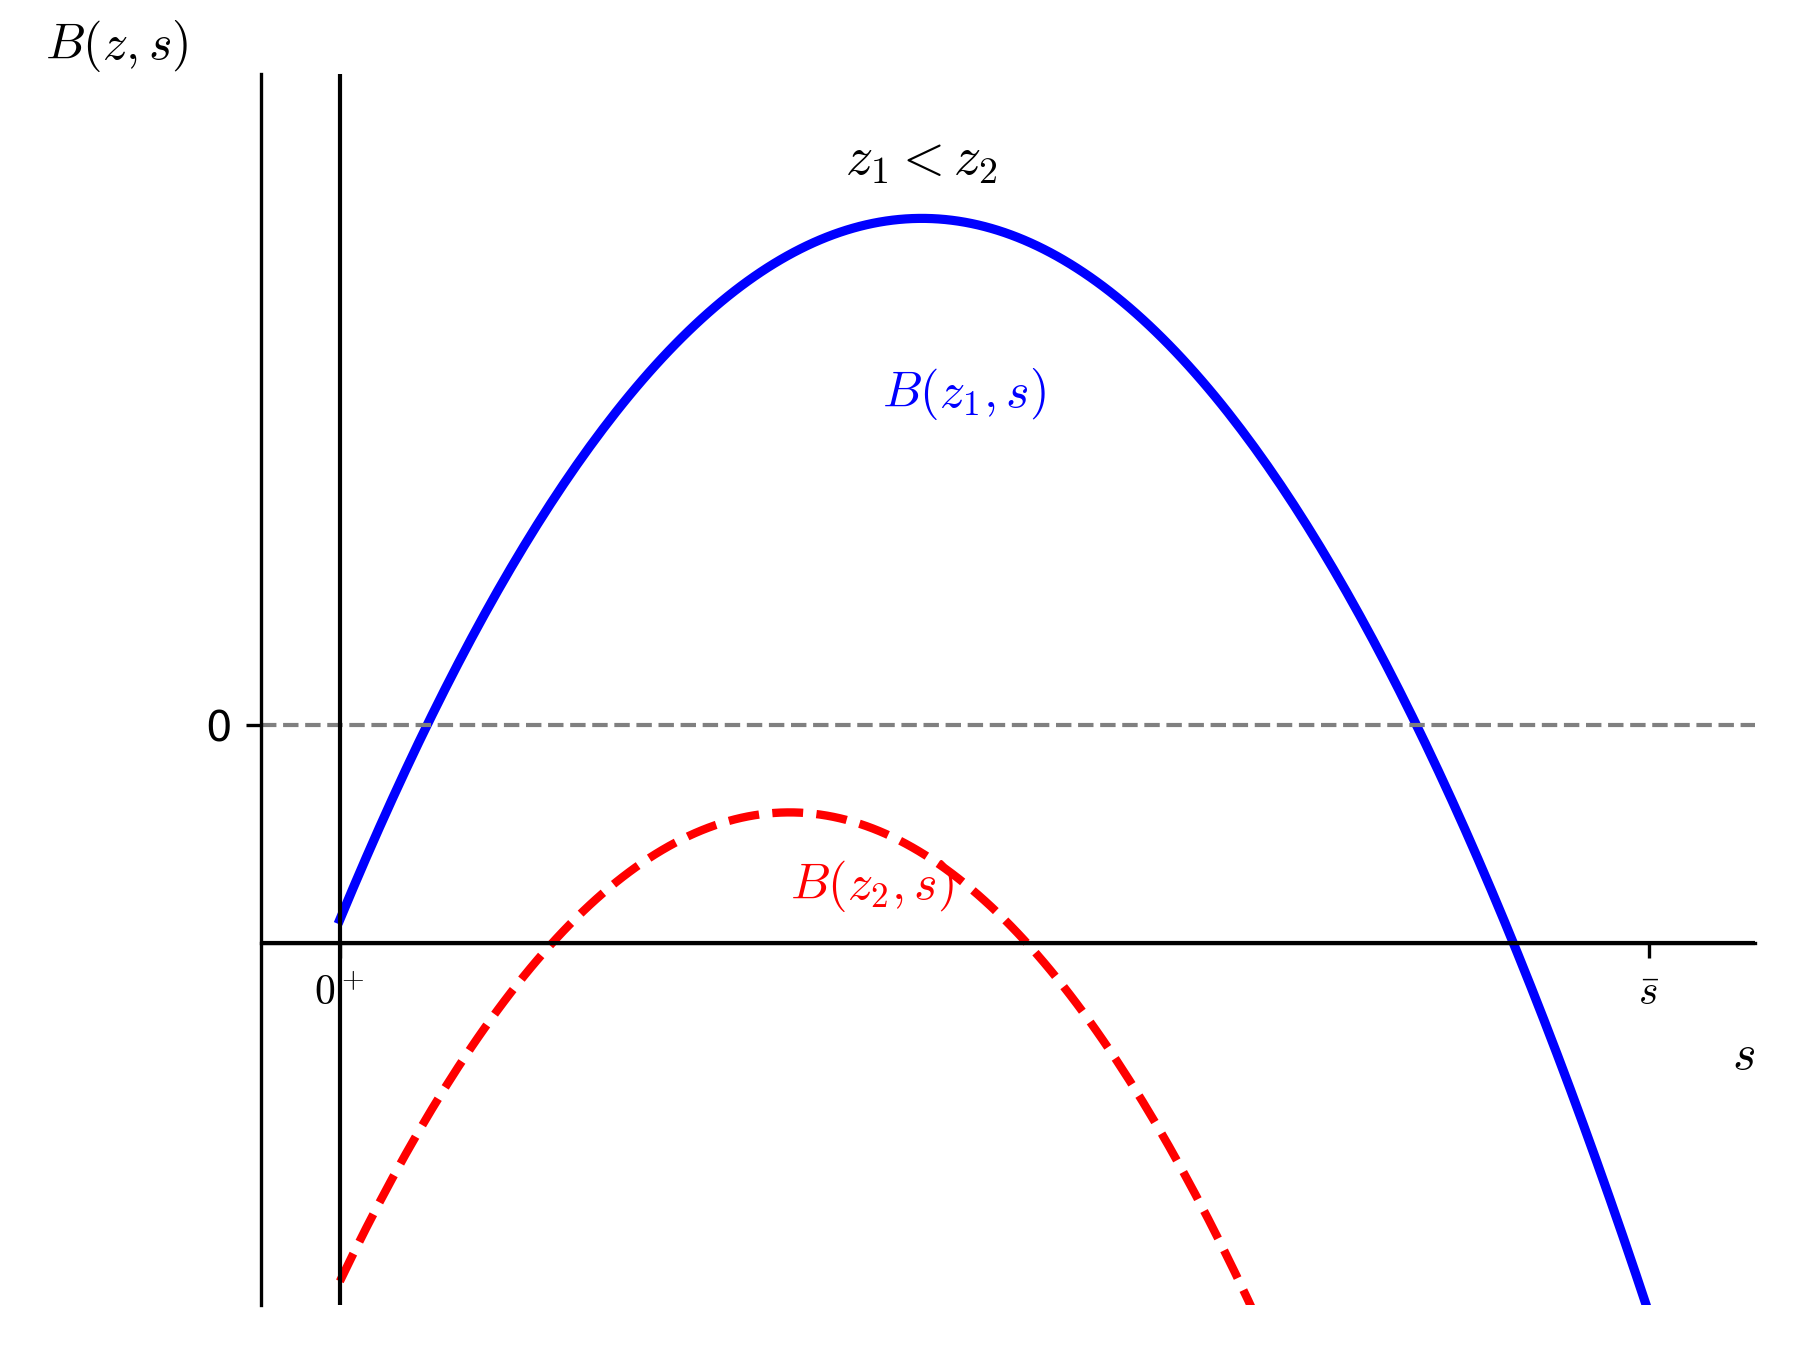
回到第一阶段,引入核心分析工具——搜寻净收益函数(Search-benefit Function)B(z,s)B(z,s):

B(z,s)≡∫0v¯max{v−z,0}dG(v|s)−c(s)=∫zv¯[1−G(v|s)]dv−c(s),∀z≥0,s∈[0,s¯]B(z,s) \equiv \int_{0}^{\overline{v}}{}\max\{ v - z,0\} dG(v|s) - c(s) = \int_{z}^{\overline{v}}{}\lbrack 1 - G(v|s)\rbrack dv - c(s),\forall z \geq 0,s \in \lbrack 0,\overline{s}\rbrack

B(z,s)B(z,s) 衡量了当买方在搜寻前已经锁定了基础剩余 zz 时,以强度 ss 展开搜寻所能获得的期望净增量收益。显然 B(z,0)=0B(z,0) = 0。对 ss 求偏导数得到边际搜寻净收益函数 B2(z,s)B_{2}(z,s):

{−∫zv¯G2(v|s)dv−c′(s),若z∈[0,v¯]且s∈(0,s¯]−c′(s),若z∈(v¯,+∞)且s∈(0,s¯]\left\{ \begin{matrix} - \int_{z}^{\overline{v}}G_{2}(v|s)dv - c\prime(s), & 若\ z \in \lbrack 0,\overline{v}\rbrack\ 且\ s \in (0,\overline{s}\rbrack \\ - c\prime(s), & 若\ z \in (\overline{v}, + \infty)\ 且\ s \in (0,\overline{s}\rbrack \end{matrix} \right.\

Lemma 3(搜寻净收益函数的凹性与单调性)

在 Assumption 1 和 Assumption 2 下,搜寻净收益函数 B(z,s)B(z,s) 具有如下性质:

(1) B(z,s)B(z,s) 在定义域上关于已锁定剩余 zz 严格单调递减;

(2) B(z,s)B(z,s) 在区间 (0,s¯](0,\overline{s}\rbrack 上关于搜寻强度 ss 是严格凹函数(Strictly Concave);

(3) 边际搜寻收益 B2(z,s)B_{2}(z,s) 关于已锁定剩余 zz 严格单调递减。

【Lemma 3 的证明】由公式直接求导:∂B(z,s)∂z=−(1−G(z|s))≤0\frac{\partial B(z,s)}{\partial z} = - (1 - G(z|s)) \leq 0,因此 B(z,s)B(z,s) 随已锁定剩余 zz 的增加而递减(买方已有保障越丰厚,外部搜寻的吸引力越小)。关于 ss 的二阶导数为 ∂2B∂s2=−∫zv¯G22(v|s)dv−c′′(s)≤0\frac{\partial^{2}B}{\partial s^{2}} = - \int_{z}^{\overline{v}}{}G_{22}(v|s)dv - c\prime\prime(s) \leq 0(由 Assumption 1 的 G22≥0G_{22} \geq 0 与 Assumption 2 的 c′′≥0c\prime\prime \geq 0 保证),因此 B(z,s)B(z,s) 关于 ss 严格凹。此外,∂B2(z,s)∂z=G2(z|s)≤0\frac{\partial B_{2}(z,s)}{\partial z} = G_{2}(z|s) \leq 0,证明了边际收益随 zz 递减。

图 1:搜寻净收益函数 B(z,s)B(z,s) 的形态与性质(z1<z2z_{1} < z_{2})

图解与经济学意义:图中展示了两条搜寻收益曲线 B(z1,s)B(z_{1},s) 与 B(z2,s)B(z_{2},s)。两条曲线在区间 (0,s¯](0,\overline{s}\rbrack 上均呈现严格的倒 U 型凹曲线。由于 z1<z2z_{1} < z_{2},较低保障水平下的收益曲线 B(z1,s)B(z_{1},s) 整体位于较高保障水平曲线 B(z2,s)B(z_{2},s) 的上方。同时,由于边际搜寻收益 B2(z,s)B_{2}(z,s) 随 zz 递减,高剩余曲线 B(z2,s)B(z_{2},s) 的峰值顶点(最优搜寻努力)严格位于低剩余曲线 B(z1,s)B(z_{1},s) 峰值的左侧,直观展现了'已获剩余抑制搜寻努力'的经济学机理。

定义买方在已锁定剩余 zz 下的最优搜寻强度为:

s∼(z)≡argmaxs∈[0,s¯]B(z,s),∀z∈[0,+∞)\overset{\sim}{s}(z) \equiv \arg\max_{s \in \lbrack 0,\overline{s}\rbrack}B(z,s),\forall z \in \lbrack 0, + \infty)

为排除平凡情形(即拒绝机制的买方也不搜寻,或估值最高且价格为0的买方仍然搜寻),引入正则性假设 Assumption 3:maxsB(0,s)>0\max_{s}B(0,s) > 0 且 maxsB(u¯,s)<0\max_{s}B(\overline{u},s) < 0。

Lemma 4(搜寻门槛 k̂\hat{k} 与最优搜寻强度函数的性质)

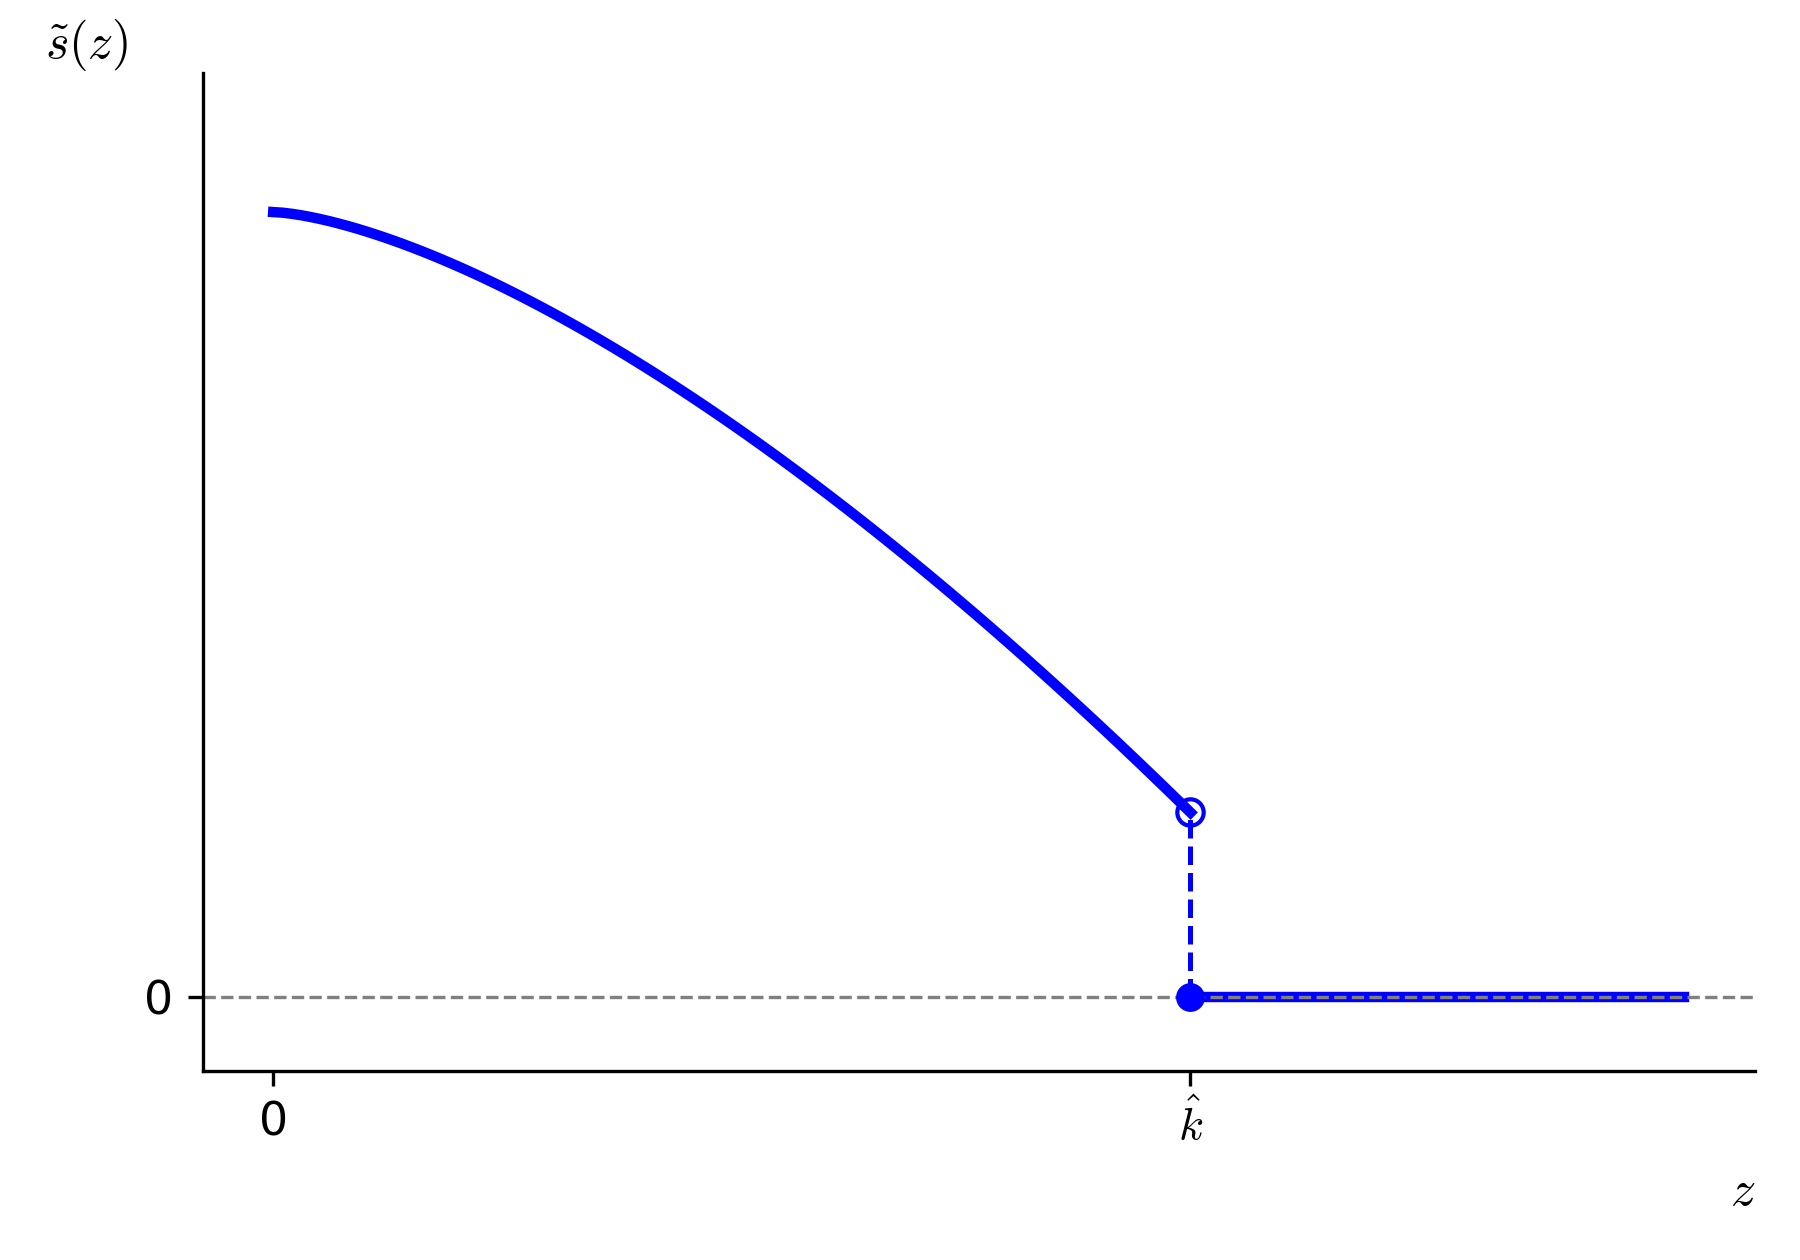
定义临界门槛值 k̂≡sup{z|maxs∈(0,s¯]B(z,s)≥0}\hat{k} \equiv \sup\{ z|\max_{s \in (0,\overline{s}\rbrack}B(z,s) \geq 0\},则 k̂∈[0,u¯]\hat{k} \in \lbrack 0,\overline{u}\rbrack 且唯一存在。最优搜寻强度函数 s∼(z)\overset{\sim}{s}(z) 满足:

s∼(z)=sup{s|B2(z,s)≥0}\overset{\sim}{s}(z) = \sup\{ s|B_{2}(z,s) \geq 0\}, 若 z∈[0,k̂]z \in \lbrack 0,\hat{k}\rbrack;

s∼(z)=0\overset{\sim}{s}(z) = 0, 若 z∈(k̂,+∞)z \in (\hat{k}, + \infty)。

此外,函数 s∼(z)\overset{\sim}{s}(z) 在其定义域上关于 zz 严格单调递减,并在分界点 k̂\hat{k} 处发生向下的离散跳跃(从正值跳跃至 00)。

{sup{s|B2(z,s)≥0},若z∈[0,k̂]0,若z∈(k̂,+∞)\left\{ \begin{matrix} \sup\{ s|B_{2}(z,s) \geq 0\}, & 若\ z \in \lbrack 0,\hat{k}\rbrack \\ 0, & 若\ z \in (\hat{k}, + \infty) \end{matrix} \right.\

图 2:最优搜寻强度函数 s∼(z)\overset{\sim}{s}(z) 随已获剩余 zz 的变动轨迹

图解与经济学意义:图中清晰刻画了最优搜寻强度 s∼(z)\overset{\sim}{s}(z) 随已锁定剩余 zz 的变化规律:当 z∈[0,k̂]z \in \lbrack 0,\hat{k}\rbrack 时,买方搜寻净收益非负,最优搜寻努力 s∼(z)\overset{\sim}{s}(z) 随 zz 平滑单调递减;一旦已锁定剩余超过临界门槛 k̂\hat{k}(即 z>k̂z > \hat{k}),搜寻的最大可能期望净收益转为负值,买方最优决策发生结构性突变,搜寻强度断崖式跳跃降至 00。因此 k̂\hat{k} 构成了买方'搜寻与不搜寻'的核心临界阈值。

3.3 卖方期望收益泛函与松弛问题(Relaxed Problem)求解

定义 Myerson 标准虚拟价值函数(Virtual Valuation Function)λ(u)\lambda(u):

λ(u)≡u−1−F(u)f(u),∀u∈[0,u¯]\lambda(u) \equiv u - \frac{1 - F(u)}{f(u)},\forall u \in \lbrack 0,\overline{u}\rbrack

在单调危险率假设下,λ′(u)=1−ddu[(1−F)/f]≥1\lambda\prime(u) = 1 - \frac{d}{du}\lbrack(1 - F)/f\rbrack \geq 1,虚拟价值严格单调递增。令 m*=λ−1(0)m^{*} = \lambda^{- 1}(0) 表示卖方在标准无外部选项垄断定价下的保留价格门槛。

Lemma 5(卖方期望收益的积分泛函表达)

在满足一阶段与二阶段激励兼容(AS-1, AS-2)以及道德风险(MH)约束的前提下,卖方的期望收益 RR 可精确表示为:

R=∫0u¯{x(u)[B(0,s(u))+∫0u(λ(u)−v)dG(v|s(u))]+(1−x(u))[B(0,s(u))+∫0uX(u,v)(λ(u)−v)dG(v|s(u))]}dF(u)−π(0,0)R = \int_{0}^{\overline{u}}{}\{ x(u)\lbrack B(0,s(u)) + \int_{0}^{u}{}(\lambda(u) - v)dG(v|s(u))\rbrack + (1 - x(u))\lbrack B(0,s(u)) + \int_{0}^{u}{}X(u,v)(\lambda(u) - v)dG(v|s(u))\rbrack\} dF(u) - \pi(0,0)

R=∫0u¯{x(u)[B(0,s(u))+∫0u(λ(u)−v)dG(v|s(u))]+(1−x(u))[B(0,s(u))+∫0uX(u,v)(λ(u)−v)dG(v|s(u))]}dF(u)−π(0,0)R = \int_{0}^{\overline{u}}{}\left\{ x(u)\left\lbrack B(0,s(u)) + \int_{0}^{u}{}(\lambda(u) - v)dG(v|s(u)) \right\rbrack + (1 - x(u))\left\lbrack B(0,s(u)) + \int_{0}^{u}{}X(u,v)(\lambda(u) - v)dG(v|s(u)) \right\rbrack \right\} dF(u) - \pi(0,0)

【Lemma 5 的数理证明推导】

应用 Milgrom and Segal (2002) 积分包络定理,买方在第一阶段的均衡信息租金斜率为:

dπ(u,u)du=∂π(u,u′)∂u|u′=u=x(u)G(u|s∼(u))+(1−x(u))∫0uX(u,v)dG(v|s(u))\frac{d\pi(u,u)}{du} = \left. \ \frac{\partial\pi(u,u\prime)}{\partial u} \right|_{u\prime = u} = x(u)G(u|\overset{\sim}{s}(u)) + (1 - x(u))\int_{0}^{u}{}X(u,v)dG(v|s(u))

社会总剩余等于买方与卖方期望剩余之和。当买方获得标的物与未获得标的物时,社会总剩余分别为:

u+B(u,s∼(u))=B(0,s∼(u))+∫0u(u−v)dG(v|s∼(u))u + B(u,\overset{\sim}{s}(u)) = B(0,\overset{\sim}{s}(u)) + \int_{0}^{u}{}(u - v)dG(v|\overset{\sim}{s}(u))

∫0v¯[v+X(u,v)max{u−v,0}]dG(v|s(u))−c(s(u))=B(0,s(u))+∫0uX(u,v)(u−v)dG(v|s(u))\int_{0}^{\overline{v}}{}\lbrack v + X(u,v)\max\{ u - v,0\}\rbrack dG(v|s(u)) - c(s(u)) = B(0,s(u)) + \int_{0}^{u}{}X(u,v)(u - v)dG(v|s(u))

卖方期望收益等于期望社会总剩余减去买方的期望租金 ∫0u¯π(u,u)dF(u)\int_{0}^{\overline{u}}{}\pi(u,u)dF(u)。对买方租金项应用分部积分法(Integration by Parts):

∫0u¯π(u,u)dF(u)=π(0,0)+∫0u¯1−F(u)f(u)dπ(u,u)dudF(u)\int_{0}^{\overline{u}}{}\pi(u,u)dF(u) = \pi(0,0) + \int_{0}^{\overline{u}}{}\frac{1 - F(u)}{f(u)}\frac{d\pi(u,u)}{du}dF(u)

将租金斜率代入并合并同类项,利用虚拟价值定义 λ(u)=u−1−F(u)f(u)\lambda(u) = u - \frac{1 - F(u)}{f(u)},即可精确导出 Lemma 5 的收益泛函。证毕。

为了求解复杂的原优化问题 (O),构建松弛问题(Problem O-R):忽略一阶段复杂的全局单调性约束与偏离路径下的道德风险约束,仅保留最底层个体理性约束 π(0,0)≥B(0,s∼(0))\pi(0,0) \geq B(0,\overset{\sim}{s}(0)),对被积表达式进行点对点(Pointwise)最大化。

Lemma 6(松弛问题的最优解与理论收益上界 R*R^{*})

定义临界截断点 m*=λ−1(0)m^{*} = \lambda^{- 1}(0) 以及 û=λ−1(k̂)\hat{u} = \lambda^{- 1}(\hat{k})。松弛问题 (O-R) 的全局最优解 {x*(u),s*(u),X*(u,v)}\{ x^{*}(u),s^{*}(u),X^{*}(u,v)\} 为:

(1) 一阶段即时分配规则:x*(u)=1x^{*}(u) = 1, 若 u∈(û,u¯]u \in (\hat{u},\overline{u}\rbrack;x*(u)=0x^{*}(u) = 0, 若 u∈[0,û]u \in \lbrack 0,\hat{u}\rbrack;

(2) 推荐搜寻强度规则:s*(u)=0s^{*}(u) = 0, 若 u∈(û,u¯]u \in (\hat{u},\overline{u}\rbrack;s*(u)=s∼(λ(u))s^{*}(u) = \overset{\sim}{s}(\lambda(u)), 若 u∈[m*,û]u \in \lbrack m^{*},\hat{u}\rbrack;s*(u)=s∼(0)s^{*}(u) = \overset{\sim}{s}(0), 若 u∈[0,m*)u \in \lbrack 0,m^{*});

(3) 二阶段延后分配规则:X*(u,v)=1X^{*}(u,v) = 1, 若 u∈[m*,û]u \in \lbrack m^{*},\hat{u}\rbrack 且 v∈[0,λ(u)]v \in \lbrack 0,\lambda(u)\rbrack;X*(u,v)=0X^{*}(u,v) = 0, 其他情形。

该解构成了卖方期望收益的理论全局上界 R*R^{*}:

R*=∫m*u¯[λ(u)+B(λ(u),s*(u))−B(0,s*(0))]dF(u)R^{*} = \int_{m^{*}}^{\overline{u}}{}\lbrack\lambda(u) + B(\lambda(u),s^{*}(u)) - B(0,s^{*}(0))\rbrack dF(u)

{1,若u∈(û,u¯]0,若u∈[0,û]\left\{ \begin{matrix} 1, & 若\ u \in (\hat{u},\overline{u}\rbrack \\ 0, & 若\ u \in \lbrack 0,\hat{u}\rbrack \end{matrix} \right.\

{1,若u∈[m*,û]且v∈[0,λ(u)]0,其他\left\{ \begin{matrix} 1, & 若\ u \in \lbrack m^{*},\hat{u}\rbrack\ 且\ v \in \lbrack 0,\lambda(u)\rbrack \\ 0, & 其他 \end{matrix} \right.\

R*=∫m*u¯[λ(u)+B(λ(u),s*(u))−B(0,s*(0))]dF(u)R^{*} = \int_{m^{*}}^{\overline{u}}{}\lbrack\lambda(u) + B(\lambda(u),s^{*}(u)) - B(0,s^{*}(0))\rbrack dF(u)

3.4 最优机制设计与购买期权菜单间接实现

首先回顾 Armstrong and Zhou (2016) 在二元搜寻设定下的基准结果。

Proposition 1(Armstrong and Zhou 2016 二元搜寻基准机制)

在搜寻成本为固定常数 c¯\overline{c}、搜寻强度仅有 s∈{0,s¯}s \in \{ 0,\overline{s}\} 的设定下,最优销售机制可通过购买期权菜单 {p(u),D¯(u)}\{ p(u),\overline{D}(u)\} 实现:

执行价格:p(u)=u−λ(u)p(u) = u - \lambda(u);期权溢价:D¯(u)=∫m*uG¯(λ(z))[λ′(z)−1]dz\overline{D}(u) = \int_{m^{*}}^{u}{}\overline{G}(\lambda(z))\lbrack\lambda\prime(z) - 1\rbrack dz。

• 即时购买型(Buy-now, u∈(u∼,u¯]u \in (\overset{\sim}{u},\overline{u}\rbrack):以价格 D¯(u∼)+p(u∼)\overline{D}(\overset{\sim}{u}) + p(\overset{\sim}{u}) 直接购买,不进行搜寻;

• 延后购买型(Buy-later, u∈[m*,u∼]u \in \lbrack m^{*},\overset{\sim}{u}\rbrack):以费用 D¯(u)\overline{D}(u) 购买期权,展开搜寻,当外部收益 v≤u−p(u)=λ(u)v \leq u - p(u) = \lambda(u) 时行使期权;

• 永不购买型(Buy-never, u∈[0,m*)u \in \lbrack 0,m^{*})):拒绝机制,直接以固定强度 s¯\overline{s} 搜寻外部选项。

现在给出本文针对连续搜寻强度的核心理论成果——卖方最优机制结构定理(Proposition 2):

Proposition 2(连续搜寻强度下的卖方最优销售机制)

设定 m*=λ−1(0)m^{*} = \lambda^{- 1}(0),û=λ−1(k̂)\hat{u} = \lambda^{- 1}(\hat{k})。定义执行价格 p(u)p(u) 与期权溢价 D(u)D(u) 如下:

p(u)=u−λ(u)=1−F(u)f(u)p(u) = u - \lambda(u) = \frac{1 - F(u)}{f(u)};

D(u)=∫m*uG(λ(z)|s*(z))[λ′(z)−1]dzD(u) = \int_{m^{*}}^{u}{}G(\lambda(z)|s^{*}(z))\lbrack\lambda\prime(z) - 1\rbrack dz。

卖方最优机制可通过购买期权菜单 {p(u),D(u)}\{ p(u),D(u)\}(u∈[m*,û]u \in \lbrack m^{*},\hat{u}\rbrack)完全实现,买方的均衡行为划分为三个内生类型区间:

(1) 即时购买型(Buy-now types, u∈(û,u¯]u \in (\hat{u},\overline{u}\rbrack):买方不进行搜寻,以全款价格 D(û)+p(û)D(\hat{u}) + p(\hat{u}) 立即购买标的物;

(2) 延后购买型(Buy-later types, u∈[m*,û]u \in \lbrack m^{*},\hat{u}\rbrack):买方支付不可退还的期权溢价 D(u)D(u),获得以执行价格 p(u)p(u) 购买标的物的权利;买方随后以连续强度 s*(u)=s∼(λ(u))s^{*}(u) = \overset{\sim}{s}(\lambda(u)) 展开搜寻;当搜寻结果不理想(即 v≤u−p(u)=λ(u)v \leq u - p(u) = \lambda(u))时行权购买,否则放弃行权直接消费外部选项;

(3) 永不购买型(Buy-never types, u∈[0,m*)u \in \lbrack 0,m^{*})):买方拒绝接受机制,直接以最优强度 s*(0)=s∼(0)s^{*}(0) = \overset{\sim}{s}(0) 展开外部搜寻。

p(u)=u−λ(u)=1−F(u)f(u),D(u)=∫m*uG(λ(z)|s*(z))[λ′(z)−1]dzp(u) = u - \lambda(u) = \frac{1 - F(u)}{f(u)},D(u) = \int_{m^{*}}^{u}{}G(\lambda(z)|s^{*}(z))\lbrack\lambda\prime(z) - 1\rbrack dz

Buy−nowPrice:Pnow=D(û)+p(û)=û−B(0,s*(0))−∫m*ûG(λ(z)|s*(z))dzBuy - now\ Price:\ P_{now} = D(\hat{u}) + p(\hat{u}) = \hat{u} - B(0,s^{*}(0)) - \int_{m^{*}}^{\hat{u}}{}G(\lambda(z)|s^{*}(z))dz

【Proposition 2 的全面数理验证与证明】

证明的核心分为两大部分:第一,验证该购买期权菜单完全满足原问题 (O) 的全部 5 个约束(IR-2, AS-2, MH, AS-1, IR-1);第二,证明该机制实现的卖方收益严格达到 Lemma 6 中的理论上限 R*R^{*}。

【Step 1:验证第二阶段约束 IR-2 与 AS-2】买方在搜寻后选择返回行权并支付执行价格 p(u)p(u) 的充要条件是 u−p(u)≥vu - p(u) \geq v,即 v≤λ(u)v \leq \lambda(u)。此时买方获得净剩余 u−p(u)≥vu - p(u) \geq v,自愿行权,IR-2 自动满足。第二阶段转移支付为固定执行价格 p(u)p(u),与二阶段汇报 vv 独立,AS-2 显然满足。

【Step 2:验证道德风险约束 MH(内生契合机制)】这是本论文最精妙的理论发现!在购买期权菜单下,类型为 uu 的买方在第一阶段真实签约后,其在搜寻前已经锁定的确定性剩余为 u−p(u)=λ(u)u - p(u) = \lambda(u)。买方在第一阶段自主选择搜寻强度的目标函数为:

maxs∈[0,s¯]𝔼v[max{u−p(u),v}|s]−c(s)=λ(u)+maxs∈[0,s¯]B(λ(u),s)\max_{s \in \lbrack 0,\overline{s}\rbrack}{\mathbb{E}}_{v}\lbrack\max\{ u - p(u),v\}|s\rbrack - c(s) = \lambda(u) + \max_{s \in \lbrack 0,\overline{s}\rbrack}B(\lambda(u),s)

由 Lemma 4,买方自发选择的最优搜寻强度为 ŝ(u,u)=s∼(λ(u))\hat{s}(u,u) = \overset{\sim}{s}(\lambda(u))。而根据 Lemma 6,卖方推荐的最优搜寻强度恰好也是 s*(u)=s∼(λ(u))s^{*}(u) = \overset{\sim}{s}(\lambda(u))!两者在最优点实现 100% 完美对齐:

ŝ(u,u)≡s*(u),∀u∈[0,u¯]\hat{s}(u,u) \equiv s^{*}(u),\forall u \in \lbrack 0,\overline{u}\rbrack

这一完美的内生一致性使得道德风险约束在最优点非绑定(Non-binding),卖方无需为了诱导买方选择特定搜寻努力而额外扭曲支付规则!

【Step 3:验证第一阶段逆向选择约束 AS-1(跨阶段联合偏离分析)】假定真实类型为 uu 的买方偏离汇报为 u′u\prime。若 u′∈[m*,û]u\prime \in \lbrack m^{*},\hat{u}\rbrack,买方购买了期权 {p(u′),D(u′)}\{ p(u\prime),D(u\prime)\},其锁定的事前剩余变为 u−p(u′)u - p(u\prime)。买方的偏离收益为:

π(u,u′)=−D(u′)+u−p(u′)+B(u−p(u′),ŝ(u,u′))\pi(u,u\prime) = - D(u\prime) + u - p(u\prime) + B(u - p(u\prime),\hat{s}(u,u\prime))

其中 ŝ(u,u′)=s∼(u−p(u′))\hat{s}(u,u\prime) = \overset{\sim}{s}(u - p(u\prime))。对真实类型 uu 求全偏导数:

∂π(u,u′)∂u=1+∂B(z,s)∂z|z=u−p(u′)=1−[1−G(u−p(u′)|ŝ(u,u′))]=G(u−p(u′)|ŝ(u,u′))\frac{\partial\pi(u,u\prime)}{\partial u} = 1 + \left. \ \frac{\partial B(z,s)}{\partial z} \right|_{z = u - p(u\prime)} = 1 - \lbrack 1 - G(u - p(u\prime)|\hat{s}(u,u\prime))\rbrack = G(u - p(u\prime)|\hat{s}(u,u\prime))

而真实汇报时的租金全导数为 dπ(u,u)du=G(λ(u)|s*(u))\frac{d\pi(u,u)}{du} = G(\lambda(u)|s^{*}(u))。当 u>u′u > u\prime 时,由于 p(u′)>p(u)p(u\prime) > p(u)(pp 单调递减),有 u−p(u)>u−p(u′)u - p(u) > u - p(u\prime),且由 Lemma 4,s*(u)≤ŝ(u,u′)s^{*}(u) \leq \hat{s}(u,u\prime)。由 Assumption 1,GG 关于第一参数递增、关于第二参数递减,因此:

dπ(u,u)du=G(λ(u)|s*(u))≥G(u−p(u′)|ŝ(u,u′))=∂π(u,u′)∂u,∀u>u′\frac{d\pi(u,u)}{du} = G(\lambda(u)|s^{*}(u)) \geq G(u - p(u\prime)|\hat{s}(u,u\prime)) = \frac{\partial\pi(u,u\prime)}{\partial u},\forall u > u\prime

根据包络积分公式:π(u,u)−π(u,u′)=∫u′u[dπ(z,z)dz−∂π(z,u′)∂z]dz≥0\pi(u,u) - \pi(u,u\prime) = \int_{u\prime}^{u}{}\left\lbrack \frac{d\pi(z,z)}{dz} - \frac{\partial\pi(z,u\prime)}{\partial z} \right\rbrack dz \geq 0。同理可证 u<u′u < u\prime 时的情形。因此全局 AS-1 严格成立!

【Step 4:验证第一阶段 IR-1 与达到收益上界】由递增性,π(u,u)≥π(0,0)=B(0,s∼(0))\pi(u,u) \geq \pi(0,0) = B(0,\overset{\sim}{s}(0)),IR-1 满足。将期权菜单的期望收费带入卖方总收益公式,利用分部积分展开,可精确得到 Rev=R*Rev = R^{*}。证毕。

机制特征 Armstrong and Zhou (2016) 二元模型 本文连续搜寻强度模型 (Proposition 2)
期权溢价 D(u)D(u) 表达式 D¯(u)=∫G(λ(z))[λ′(z)−1]dz\overline{D}(u) = \int_{}^{}{}G(\lambda(z))\lbrack\lambda\prime(z) - 1\rbrack dz D(u)=∫G(λ(z)|s*(z))[λ′(z)−1]dzD(u) = \int_{}^{}{}G(\lambda(z)|s^{*}(z))\lbrack\lambda\prime(z) - 1\rbrack dz
期权溢价对搜寻成本的敏感性 完全独立(Unaffected by search cost) 内生依赖于成本函数 c(s)c(s) 的全貌与斜率

表 2:期权溢价定价结构对比与机制机理差异

3.5 均衡搜寻强度与成交概率分布特性

Proposition 3(均衡搜寻强度与成交概率的分布形态)

在 Proposition 2 的最优销售机制下:

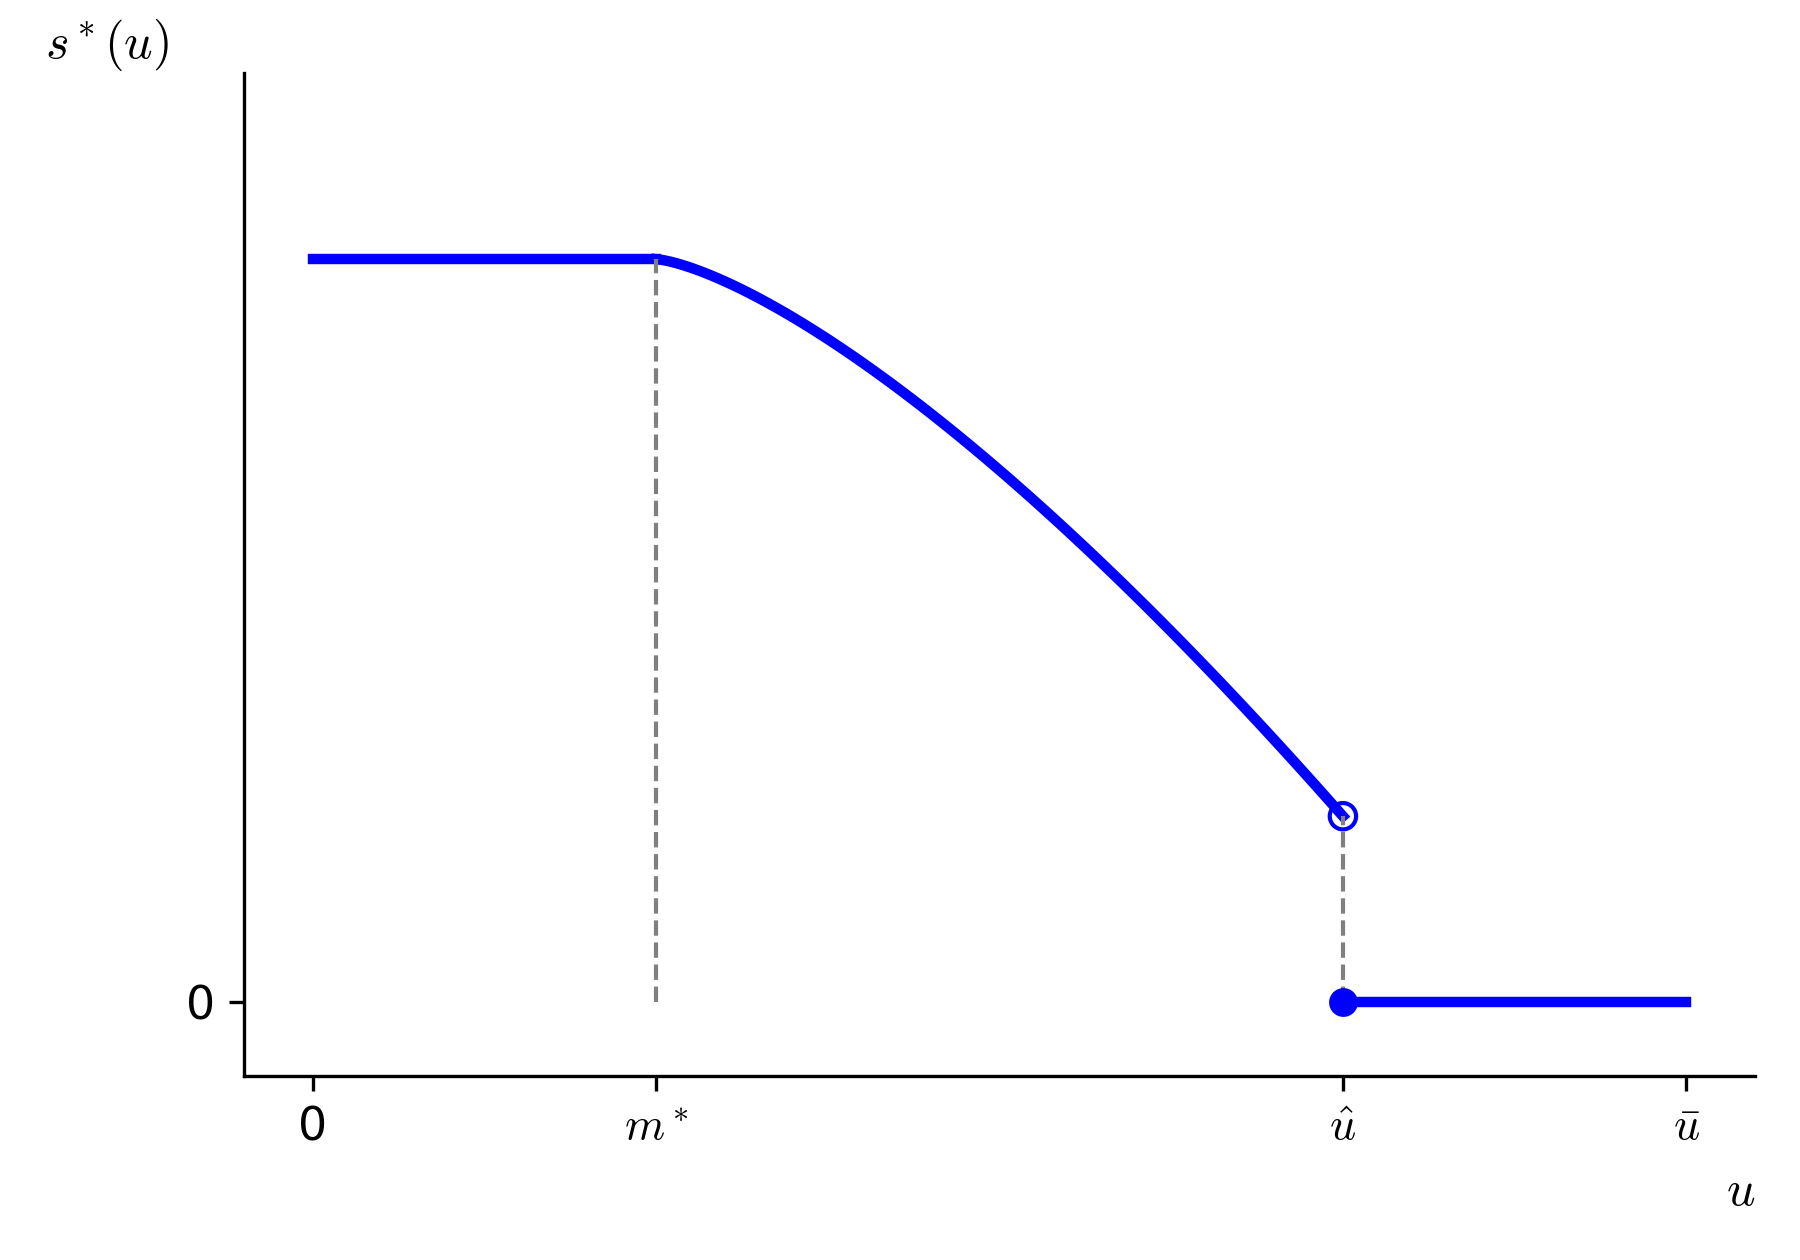
(i) 买方的均衡搜寻强度 s*(u)s^{*}(u) 在区间 [0,m*]\lbrack 0,m^{*}\rbrack 上保持水平常数 s∼(0)\overset{\sim}{s}(0),在区间 [m*,û]\lbrack m^{*},\hat{u}\rbrack 上随估值 uu 严格单调递减,并在区间 (û,u¯](\hat{u},\overline{u}\rbrack 上直接跳降并归零;

(ii) 卖方向买方的成交概率 G(λ(u)|s*(u))G(\lambda(u)|s^{*}(u)) 在区间 [0,m*]\lbrack 0,m^{*}\rbrack 上恒为 00,在区间 [m*,û]\lbrack m^{*},\hat{u}\rbrack 上随估值 uu 严格单调递增,并在临界点 û\hat{u} 处发生向上的离散跳跃,在区间 (û,u¯](\hat{u},\overline{u}\rbrack 上恒等于 11。

图 3:买方均衡搜寻强度 s*(u)s^{*}(u) 随其估值 uu 的分布曲线

图解与经济学意义:低估值买方(u<m*u < m^{*})拒绝机制并以最高努力 s∼(0)\overset{\sim}{s}(0) 搜寻;延后购买型买方(m*≤u≤ûm^{*} \leq u \leq \hat{u})的搜寻努力随自身估值 uu 严格递减;高估值买方(u>ûu > \hat{u})选择即时购买,搜寻强度降为 00。这一递减性源于两个微观力量:一是买方估值越高,外部搜寻对社会总剩余的增量贡献越低;二是高估值买方获得标的物的概率更高,从而内生削弱了其搜寻动力。
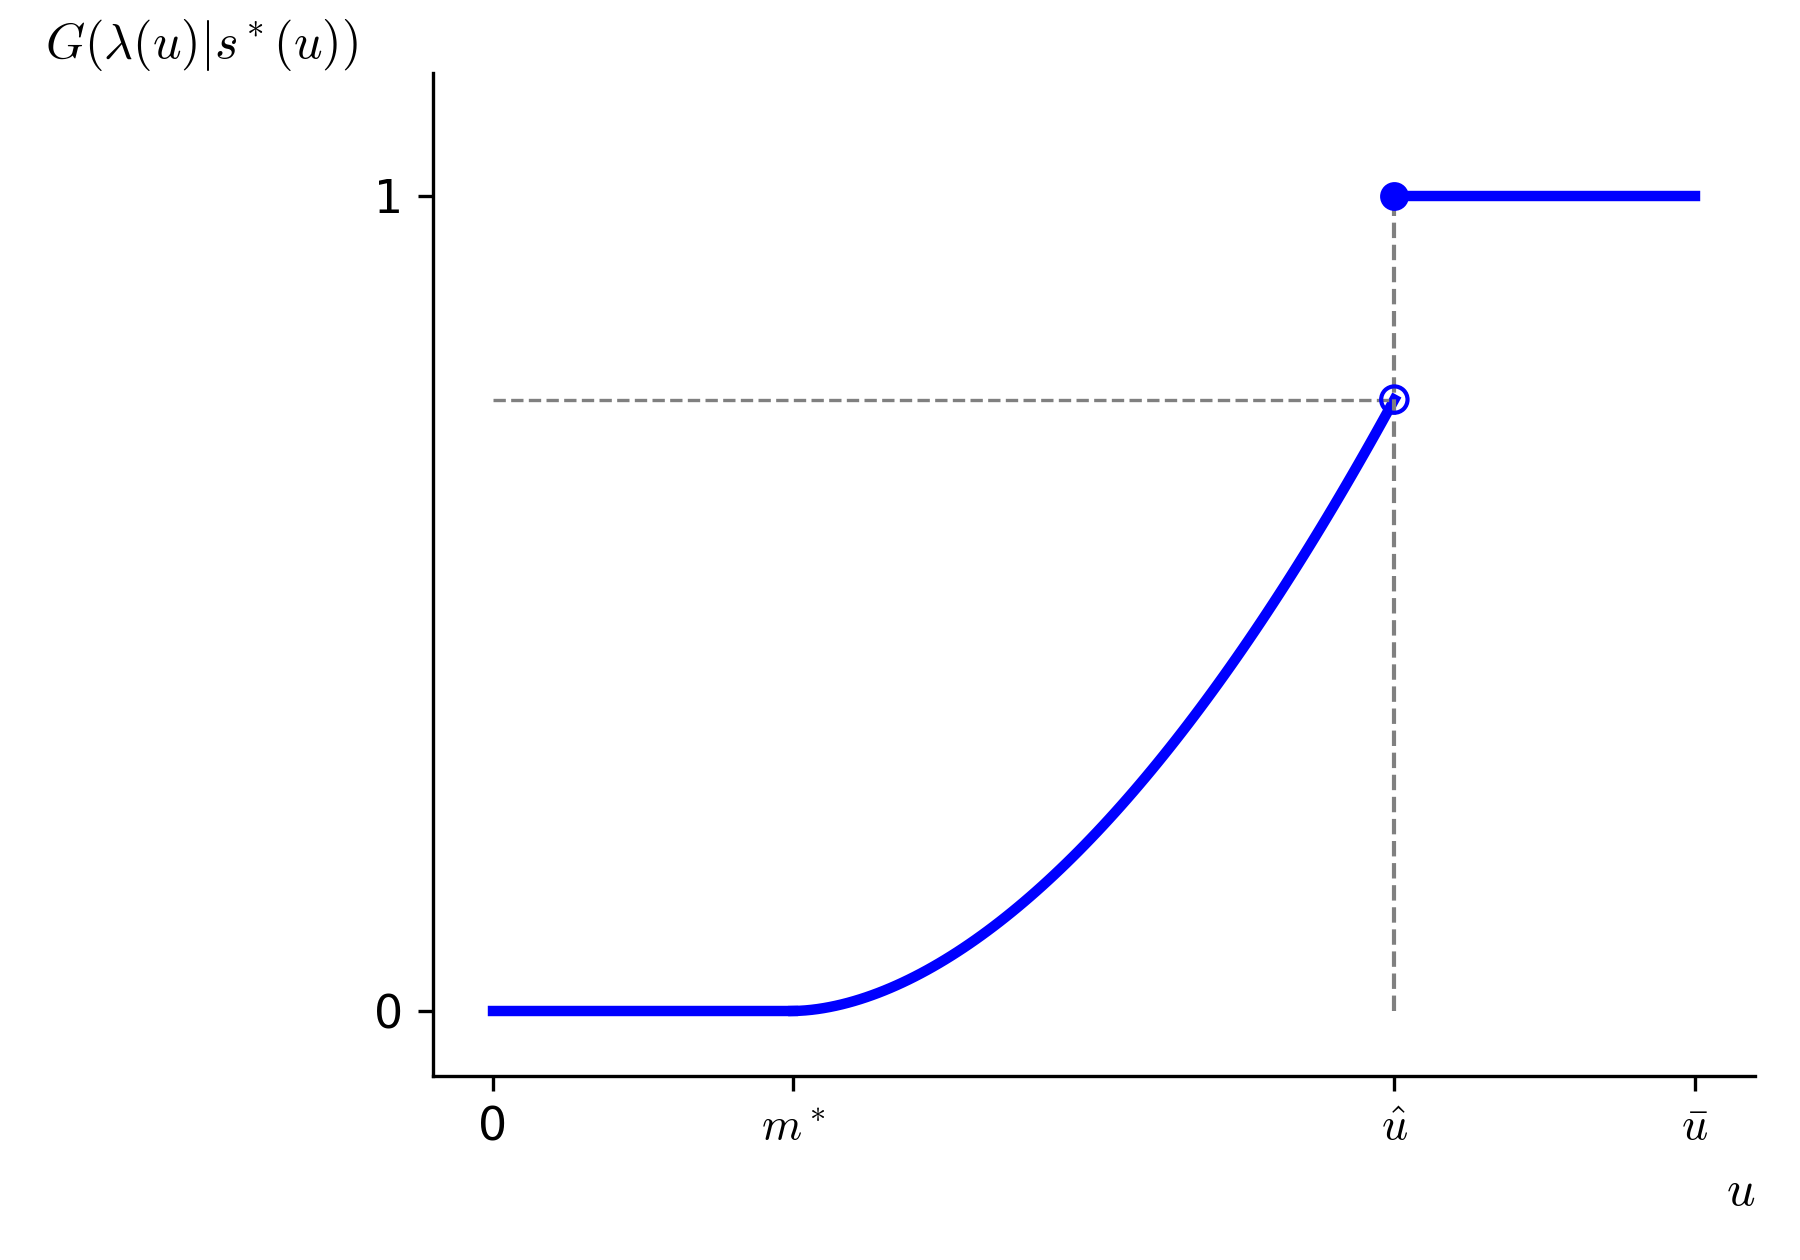
图 4:卖方成交概率 G(λ(u)|s*(u))G(\lambda(u)|s^{*}(u)) 随买方估值 uu 的分布曲线

图解与经济学意义:成交概率在低估值区为 00;在延后购买区随估值提高而平滑上升(买方估值越高,搜寻努力越低且行权门槛 λ(u)\lambda(u) 越高,因而返回购买概率越大);在搜寻临界点 û\hat{u} 处,由于买方彻底停止搜寻,成交概率发生结构性向上跳跃直达 1.01.0。

第四章 搜寻成本对卖方收益的影响与反常效应数理推导

4.1 买方期望支付函数与卖方收益结构分解

Lemma 7(买方期望支付函数 β(u)\beta(u) 的解析表达)

在 Proposition 2 最优机制下,类型为 uu 的买方向卖方的期望支付可统一表示为函数 β(u)\beta(u):

β(u)=0\beta(u) = 0, 若 u∈[0,m*)u \in \lbrack 0,m^{*});

β(u)=∫m*u[λ′(z)−1]G(λ(z)|s*(z))dz+[u−λ(u)]G(λ(u)|s*(u))\beta(u) = \int_{m^{*}}^{u}{}\lbrack\lambda\prime(z) - 1\rbrack G(\lambda(z)|s^{*}(z))dz + \lbrack u - \lambda(u)\rbrack G(\lambda(u)|s^{*}(u)), 若 u∈[m*,û]u \in \lbrack m^{*},\hat{u}\rbrack;

β(u)=D(û)+p(û)\beta(u) = D(\hat{u}) + p(\hat{u}), 若 u∈(û,u¯]u \in (\hat{u},\overline{u}\rbrack。

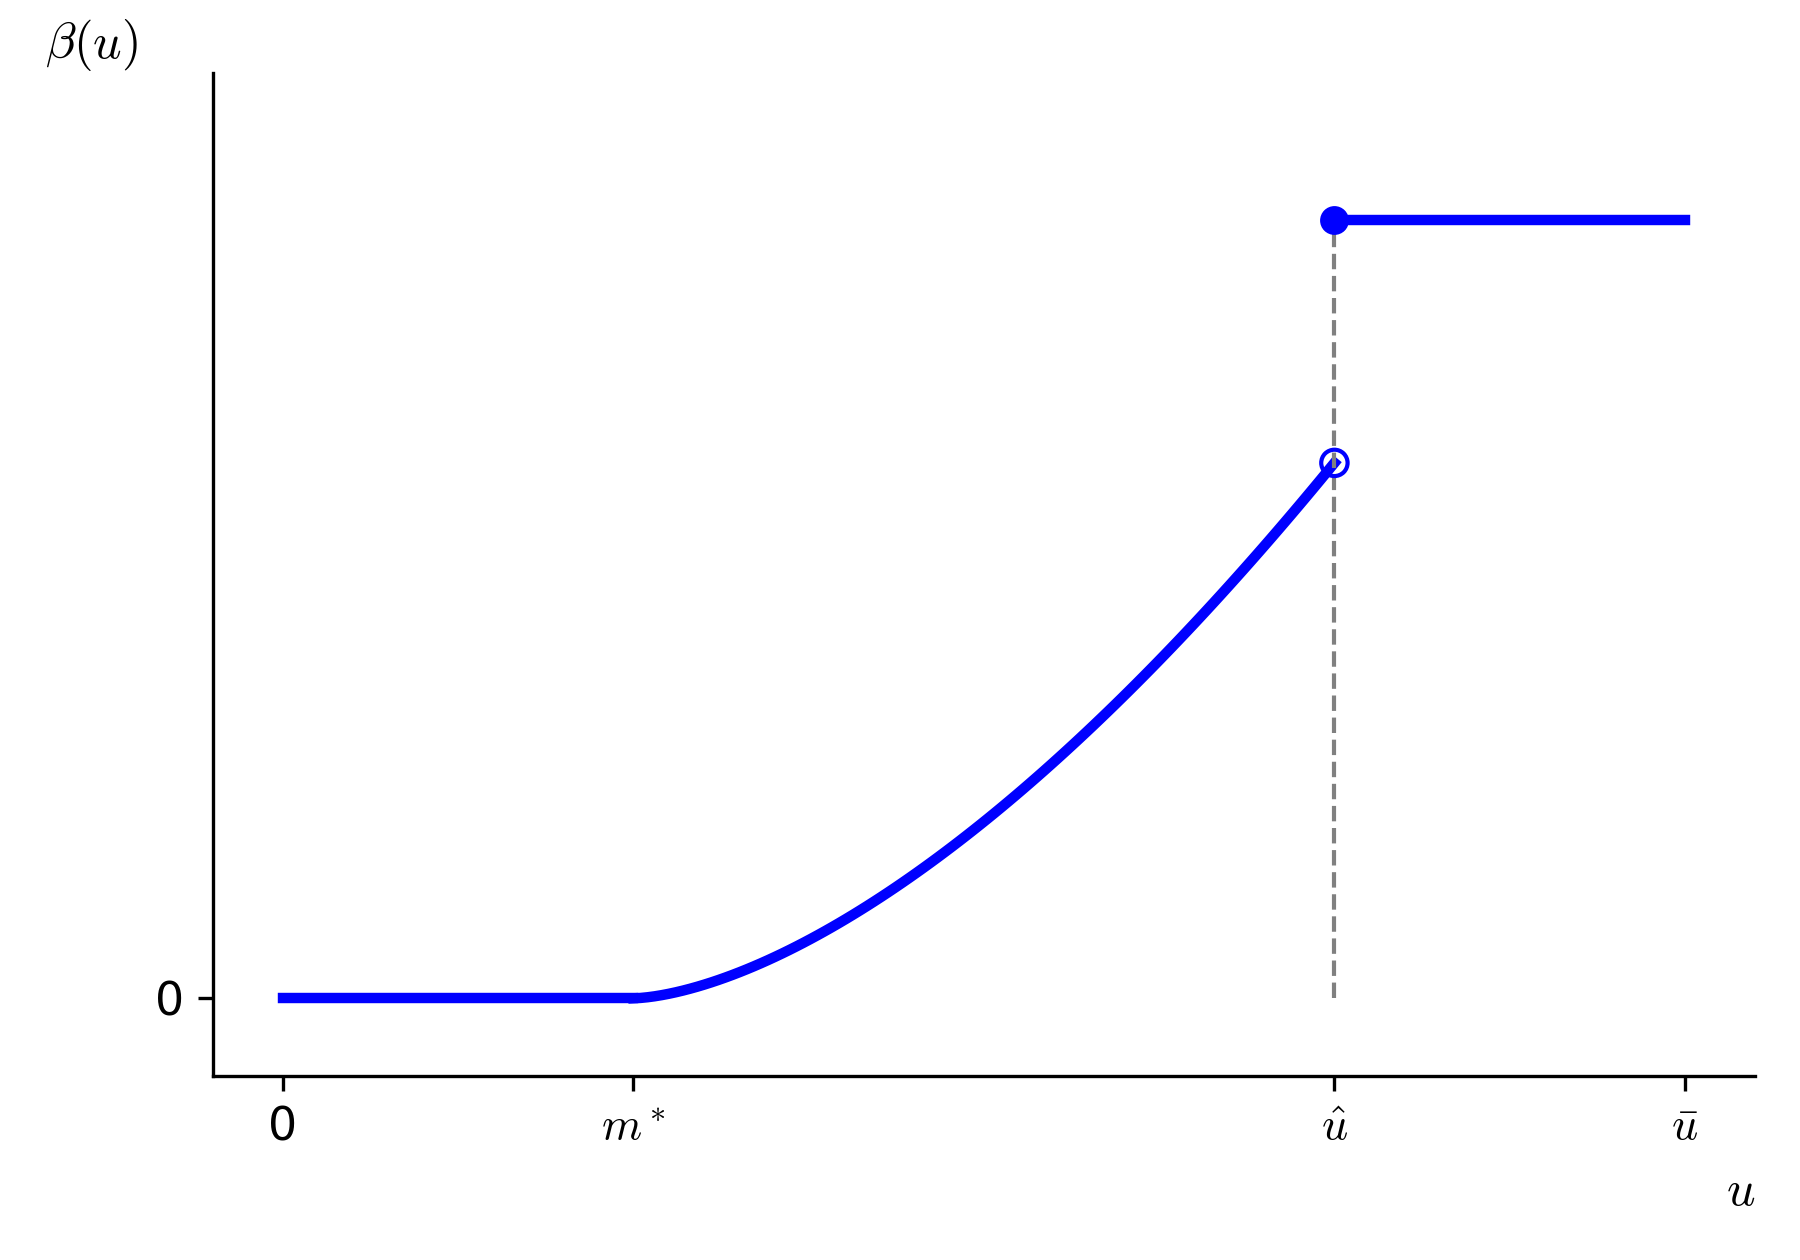
β(u)\beta(u) 在 [m*,û]\lbrack m^{*},\hat{u}\rbrack 上严格递增,在 û\hat{u} 处向上跳跃,并在 (û,u¯](\hat{u},\overline{u}\rbrack 上保持常数。

{0,若u∈[0,m*)∫m*u[λ′(z)−1]G(λ(z)|s*(z))dz+[u−λ(u)]G(λ(u)|s*(u)),若u∈[m*,û]D(û)+p(û),若u∈(û,u¯]\left\{ \begin{matrix} 0, & 若\ u \in \lbrack 0,m^{*}) \\ \int_{m^{*}}^{u}\lbrack\lambda\prime(z) - 1\rbrack G(\lambda(z)|s^{*}(z))dz + \lbrack u - \lambda(u)\rbrack G(\lambda(u)|s^{*}(u)), & 若\ u \in \lbrack m^{*},\hat{u}\rbrack \\ D(\hat{u}) + p(\hat{u}), & 若\ u \in (\hat{u},\overline{u}\rbrack \end{matrix} \right.\

买方类型区间 类型 uu 买方的期望支付表达式
永不购买型(Buy-never, u∈[0,m*)u \in \lbrack 0,m^{*})) 00
延后购买型(Buy-later, u∈[m*,û]u \in \lbrack m^{*},\hat{u}\rbrack) D(u)+p(u)G(λ(u)|s*(u))D(u) + p(u)G(\lambda(u)|s^{*}(u))
即时购买型(Buy-now, u∈(û,u¯]u \in (\hat{u},\overline{u}\rbrack) D(û)+p(û)D(\hat{u}) + p(\hat{u})

表 3:均衡状态下各类型买方向卖方的期望支付汇总

图 5:买方期望支付函数 β(u)\beta(u) 随估值 uu 的变化轨迹

图解与经济学意义:期望支付在低估值区为 00;在延后购买区随估值上升而单调增加(期权费增加且行权概率上升);在门槛 û\hat{u} 处向上跳跃至即时全款价格 D(û)+p(û)D(\hat{u}) + p(\hat{u}) 并在此后保持水平常数。

由此,卖方的总期望收益 R*R^{*} 可以精妙地分解为两大部分:即时购买收益(Buy-now revenue)与延后购买收益(Buy-later revenue):

R*=underbrace∫ûu¯β(u)dF(u)即时购买收益(Buy−now)+underbrace∫m*ûβ(u)dF(u)延后购买收益(Buy−later)R^{*} = underbrace{\int_{\hat{u}}^{\overline{u}}\beta(u)dF(u)}_{即时购买收益\ (Buy - now)} + underbrace{\int_{m^{*}}^{\hat{u}}\beta(u)dF(u)}_{延后购买收益\ (Buy - later)}

Lemma 8 & Lemma 9(搜寻成本对临界阈值与即时购买收益的作用)

【Lemma 8(门槛收缩效应)】考虑两个搜寻成本函数 ca(⋅)c_{a}( \cdot ) 与 cb(⋅)c_{b}( \cdot )。若 ca(⋅)≥cb(⋅)c_{a}( \cdot ) \geq c_{b}( \cdot ),则对应的搜寻临界门槛必满足:ûa≤ûb{\hat{u}}_{a} \leq {\hat{u}}_{b}。

【Lemma 9(即时收益单调性)】更高的搜寻成本函数 ca(⋅)c_{a}( \cdot ) 必然导致卖方获得严格更高的即时购买收益(Buy-now revenue)。

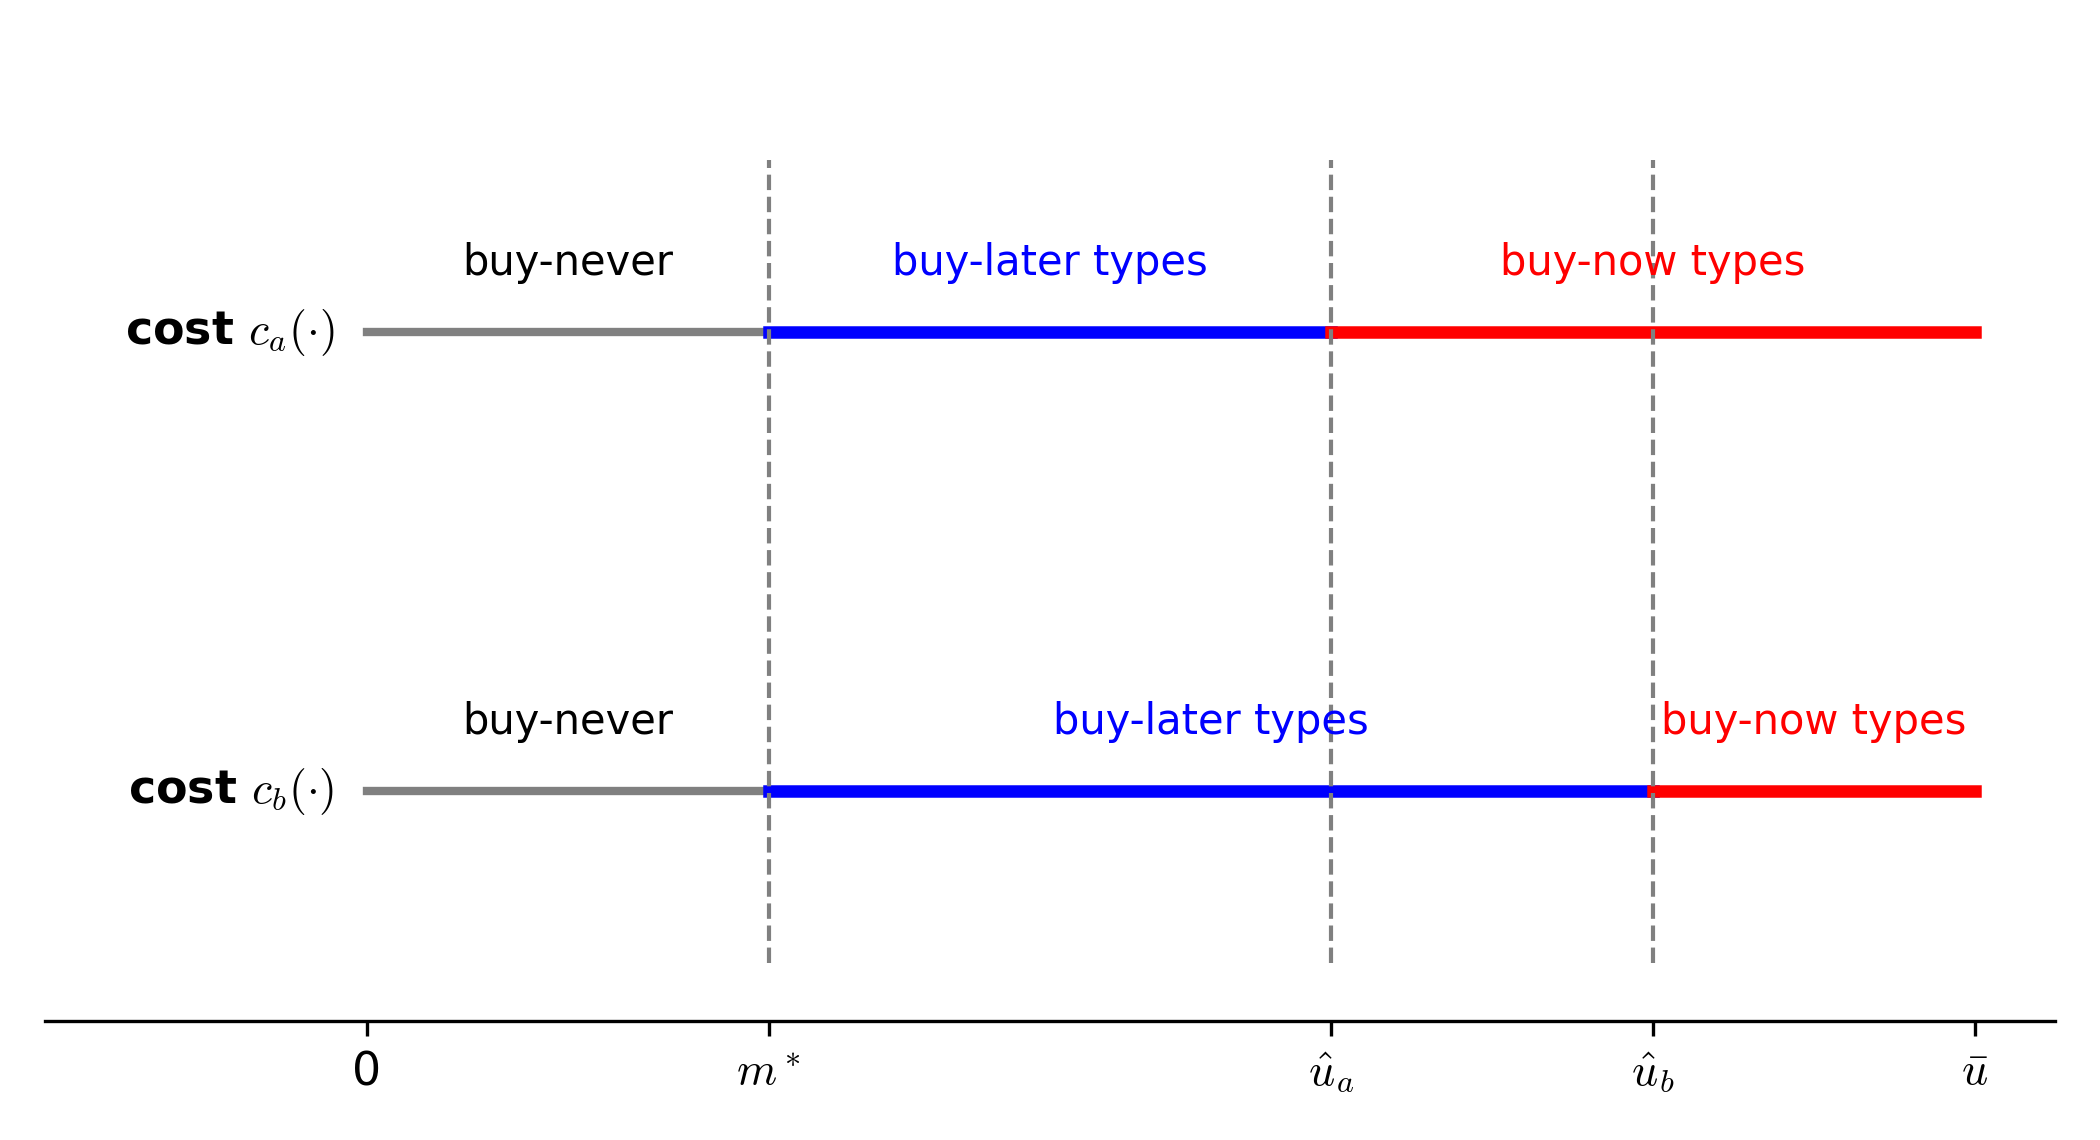
图 6:搜寻成本函数上升对买方类型区间的挤压重构(ca≥cbc_{a} \geq c_{b} 导致 ûa≤ûb{\hat{u}}_{a} \leq {\hat{u}}_{b})

图解与经济学意义:上层展示高成本 ca(⋅)c_{a}( \cdot ),下层展示低成本 cb(⋅)c_{b}( \cdot )。当搜寻成本整体上升时,搜寻门槛从 ûb{\hat{u}}_{b} 左移至 ûa{\hat{u}}_{a},导致延后购买区 [m*,ûa]\lbrack m^{*},{\hat{u}}_{a}\rbrack 被压缩,而即时购买区 (ûa,u¯]({\hat{u}}_{a},\overline{u}\rbrack 被拓宽。更高比例的买方被逼迫放弃搜寻并支付高额即时购买全款。

4.2 搜寻便利效应 vs 搜寻威慑效应

核心概念定义:搜寻便利效应 vs 搜寻威慑效应

【搜寻便利效应 (Search Facilitation Effect)】若搜寻成本函数的改变导致正测度买方子集的均衡搜寻强度严格上升(或诱导更多买方发起搜寻),称该改变对买方产生了搜寻便利效应。Lemma 10 证明:搜寻便利效应降低买方期望支付,损害卖方收益。

【搜寻威慑效应 (Search Deterrence Effect)】若搜寻成本函数的改变导致正测度买方子集的均衡搜寻强度严格下降(或抑制买方的边际搜寻努力),称该改变对买方产生了搜寻威慑效应。Lemma 10 证明:搜寻威慑效应提高买方期望支付,提升卖方收益。

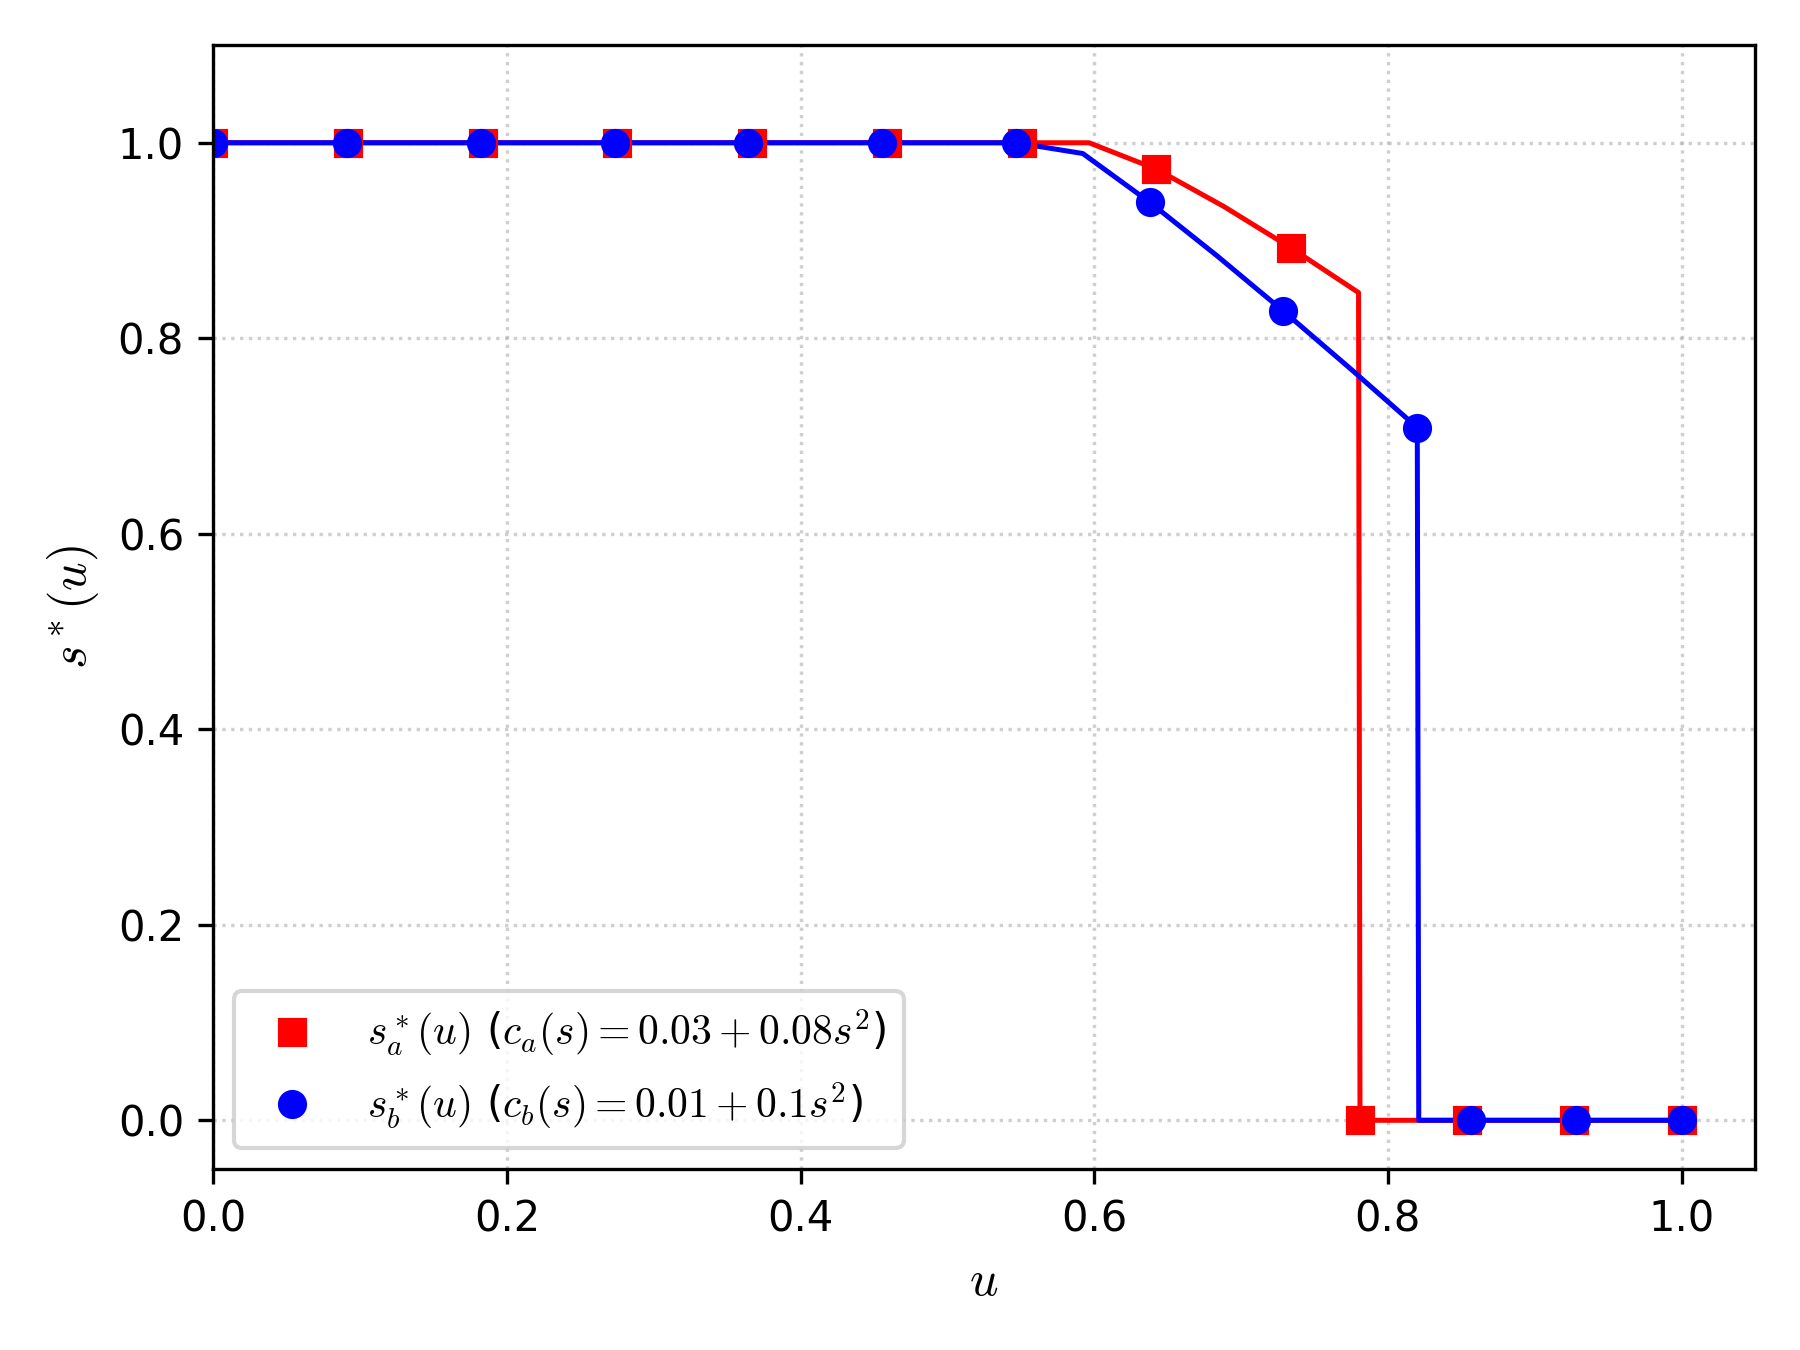
图 7:数值算例下两组成本函数对应的均衡搜寻努力对比曲线

图解与经济学意义:基于数值参数 ca(s)=0.03+0.08s2c_{a}(s) = 0.03 + 0.08s^{2}, cb(s)=0.01+0.1s2c_{b}(s) = 0.01 + 0.1s^{2}, F(u)=uF(u) = u, G(v|s)=vsG(v|s) = v^{s}。红色方块虚线代表 sa*(u)s_{a}^{*}(u),蓝色圆点实线代表 sb*(u)s_{b}^{*}(u)。在区间 [0,ûa]\lbrack 0,{\hat{u}}_{a}\rbrack 内,由于 cbc_{b} 的边际成本更高,sb*(u)≤sa*(u)s_{b}^{*}(u) \leq s_{a}^{*}(u)(产生了威慑效应);而在区间 (ûa,ûb]({\hat{u}}_{a},{\hat{u}}_{b}\rbrack 内,cbc_{b} 诱发了搜寻而 cac_{a} 阻止了搜寻(产生了便利效应)。

4.3 确定性外部选项基准与常规单调性命题

Lemma 11(确定性外部选项下的严格单调性基准)

在外部选项退化为确定性取值的极限情形(即波动参数 α→0\alpha \rightarrow 0)下,延后购买型买方完全消失,卖方收益全部来源于即时购买收益。此时更高的搜寻成本函数必定单调提高卖方收益。

Proposition 4(成本与边际成本同时上升的常规效应)

考虑两个给定的搜寻成本函数 ca(⋅)≥cb(⋅)c_{a}( \cdot ) \geq c_{b}( \cdot )。若同时满足边际搜寻成本更高,即 ca′(s)≥cb′(s)c_{a}\prime(s) \geq c_{b}\prime(s)(∀s\forall s),则卖方在高搜寻成本函数 cac_{a} 下获得的期望总收益严格更高,即:Ra*≥Rb*R_{a}^{*} \geq R_{b}^{*}。

【Proposition 4 的证明逻辑】当 ca≥cbc_{a} \geq c_{b} 且 ca′≥cb′c_{a}\prime \geq c_{b}\prime 时,高成本 cac_{a} 既通过门槛左移扩大了即时购买区间(增加即时购买收益),又通过更高的边际成本全面压低了延后购买区的搜寻强度(sa*(u)≤sb*(u)s_{a}^{*}(u) \leq s_{b}^{*}(u)),从而只诱发了搜寻威慑效应,排除了任何搜寻便利效应。两重正向效应叠加,确保总收益必然增加。

Proposition 5 & Proposition 6(加性平移、乘性尺度与 Armstrong-Zhou 模型的应用)

【Proposition 5(加性与乘性平移)】

(i) 对于加性平移 ca(s)=cb(s)+dc_{a}(s) = c_{b}(s) + d(d>0d > 0,见图 8),卖方收益单调递增:Ra*>Rb*R_{a}^{*} > R_{b}^{*};

(ii) 对于乘性平移 ca(s)=k⋅cb(s)c_{a}(s) = k \cdot c_{b}(s)(k>1k > 1,见图 9),卖方收益单调递增:Ra*>Rb*R_{a}^{*} > R_{b}^{*}。

【Proposition 6(Armstrong and Zhou 2016 模型的单调性特例)】

在 Armstrong and Zhou (2016) 的平坦固定成本模型中,提高搜寻成本必定单调增加卖方收益。

图 8:加性平移搜寻成本函数 ca(s)=cb(s)+dc_{a}(s) = c_{b}(s) + d

图解与经济学意义:两条成本曲线严格平行,ca′(s)≡cb′(s)c_{a}\prime(s) \equiv c_{b}\prime(s)。此时仅存在门槛左移带来的即时购买群体扩张,卖方收益严格随截距 dd 递增。

图 9:乘性尺度搜寻成本函数 ca(s)=k⋅cb(s)c_{a}(s) = k \cdot c_{b}(s) (k>1k > 1)

图解与经济学意义:曲线 ca(s)c_{a}(s) 在整体水平与斜率上均严格高于 cb(s)c_{b}(s),完全满足 Proposition 4 条件,卖方收益单调增加。

4.4 搜寻成本降低反常增加卖方收益:核心反常效应(Perverse Effect)

下面呈现本文最震撼、最具颠覆性的核心理论发现——反常效应定理(Proposition 7):

Proposition 7(降低搜寻成本提高卖方收益的反常效应定理)

考虑两个给定的搜寻成本函数 ca(⋅)c_{a}( \cdot ) 与 cb(⋅)c_{b}( \cdot ),满足 ca(s)≥cb(s)c_{a}(s) \geq c_{b}(s)(∀s∈[0,s¯]\forall s \in \lbrack 0,\overline{s}\rbrack)。

若两函数在最大搜寻强度端点处重合,即 cb(s¯)=ca(s¯)c_{b}(\overline{s}) = c_{a}(\overline{s}),且在端点处的导数满足:

cb′(s¯)≤−∫0v¯G2(v|s¯)dvc_{b}\prime(\overline{s}) \leq - \int_{0}^{\overline{v}}{}G_{2}(v|\overline{s})dv

则卖方在更低搜寻成本函数 cbc_{b} 下收集到的期望总收益反而严格高于在更高搜寻成本函数 cac_{a} 下的收益,即:

Rb*≥Ra*R_{b}^{*} \geq R_{a}^{*}

ca(s)≥cb(s),cb(s¯)=ca(s¯),cb′(s¯)≤−∫0v¯G2(v|s¯)dv⇒Rb*≥Ra*c_{a}(s) \geq c_{b}(s),c_{b}(\overline{s}) = c_{a}(\overline{s}),c_{b}\prime(\overline{s}) \leq - \int_{0}^{\overline{v}}{}G_{2}(v|\overline{s})dv \Longrightarrow R_{b}^{*} \geq R_{a}^{*}

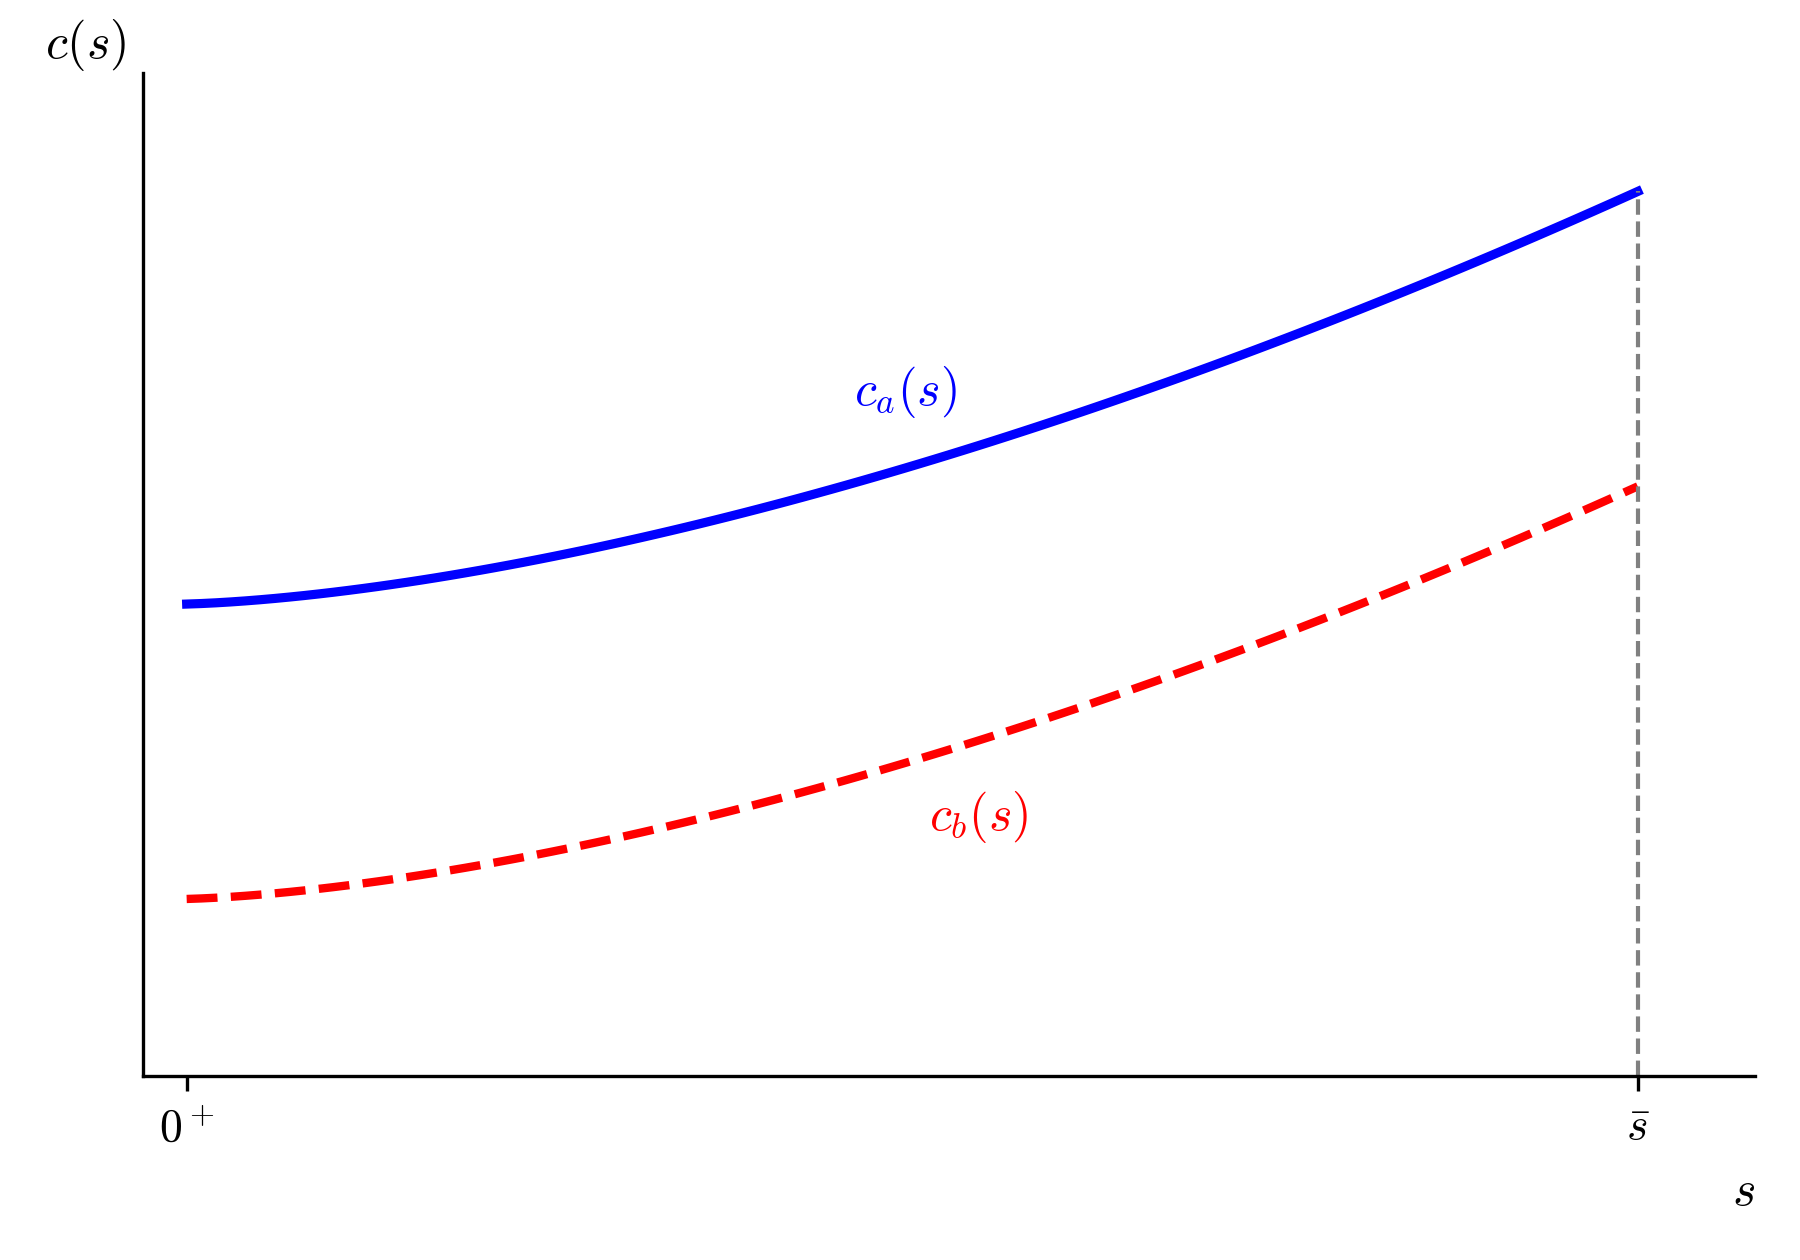
图 10:满足 Proposition 7 条件的反常效应搜寻成本函数形态

图解与经济学意义:实线为高成本函数 ca(s)c_{a}(s),虚线为低成本函数 cb(s)c_{b}(s)。cb(s)c_{b}(s) 整体位于 ca(s)c_{a}(s) 下方,但在最大努力点 s¯\overline{s} 处与 ca(s)c_{a}(s) 汇合相交,且在端点处斜率平缓。这意味着 cb(s)c_{b}(s) 在前半段上升更快(前期边际成本更高),对高估值买方产生了极强的边际搜寻抑制,成功压低了买方签约的机会成本。

【Proposition 7 的深度数理推导与经济学机理剖析】

要理解这一反直觉结果的数理本质,必须深入分析 Lemma 6 给出的卖方最优收益上界公式:

R*=∫m*u¯λ(u)dF(u)−∫m*u¯[B(0,s*(0))−B(λ(u),s*(u))]dF(u)R^{*} = \int_{m^{*}}^{\overline{u}}{}\lambda(u)dF(u) - \int_{m^{*}}^{\overline{u}}{}\lbrack B(0,s^{*}(0)) - B(\lambda(u),s^{*}(u))\rbrack dF(u)

其中,第一项 ∫m*u¯λ(u)dF(u)\int_{m^{*}}^{\overline{u}}{}\lambda(u)dF(u) 正是经典 Myerson (1981) 中买方无外部选项时的卖方垄断最大利润。第二项中的差额:

ΔB(u)≡B(0,s*(0))−B(λ(u),s*(u))\Delta B(u) \equiv B(0,s^{*}(0)) - B(\lambda(u),s^{*}(u))

代表了买方接受卖方机制的“机会成本(Opportunity Cost)”!因为买方若拒绝机制,可获得净搜寻收益 B(0,s*(0))B(0,s^{*}(0));若接受机制,在获得虚拟剩余 λ(u)\lambda(u) 的同时也保留了搜寻收益 B(λ(u),s*(u))B(\lambda(u),s^{*}(u))。卖方为了诱使买方签约,必须向买方让渡这一机会成本。因此,任何能够压缩机会成本 ΔB(u)\Delta B(u) 的成本结构改变,都将直接增加卖方收益!

现在严格推导 Proposition 7 的条件如何压缩机会成本:

(1)端点导数条件 cb′(s¯)≤−∫0v¯G2(v|s¯)dvc_{b}\prime(\overline{s}) \leq - \int_{0}^{\overline{v}}{}G_{2}(v|\overline{s})dv 意味着在最大努力 s¯\overline{s} 处,买方拒绝机制时的边际搜寻净收益仍为非负:B2(0,s¯)≥0B_{2}(0,\overline{s}) \geq 0。由 Lemma 4,拒绝机制的买方在两组成本下均选择最大搜寻强度:sa*(0)=sb*(0)=s¯s_{a}^{*}(0) = s_{b}^{*}(0) = \overline{s}。

(2)由于在端点处两成本严格相等 ca(s¯)=cb(s¯)c_{a}(\overline{s}) = c_{b}(\overline{s}),因此买方拒绝机制时的外部搜寻价值在两个情境下完全一致:

Ba(0,sa*(0))=Bb(0,sb*(0))B_{a}(0,s_{a}^{*}(0)) = B_{b}(0,s_{b}^{*}(0))

(3)而在机制内部,对于任意接受机制的买方 u∈[m*,u¯]u \in \lbrack m^{*},\overline{u}\rbrack,由于 ca(s)≥cb(s)c_{a}(s) \geq c_{b}(s)(整体成本更低),根据最优搜寻收益定义:

Ba(λ(u),sa*(u))≤Bb(λ(u),sb*(u))B_{a}(\lambda(u),s_{a}^{*}(u)) \leq B_{b}(\lambda(u),s_{b}^{*}(u))

两式相减,立即得到对于所有签约买方,接受机制的机会成本在低成本 cbc_{b} 下被严格压缩:

Bb(0,sb*(0))−Bb(λ(u),sb*(u))≤Ba(0,sa*(0))−Ba(λ(u),sa*(u))B_{b}(0,s_{b}^{*}(0)) - B_{b}(\lambda(u),s_{b}^{*}(u)) \leq B_{a}(0,s_{a}^{*}(0)) - B_{a}(\lambda(u),s_{a}^{*}(u))

将该不等式代入收益积分公式,被积函数处处增大,直接证明了 Rb*≥Ra*R_{b}^{*} \geq R_{a}^{*}!证毕。

Lemma 12 & 拓展算例(反常效应条件的温和松弛)

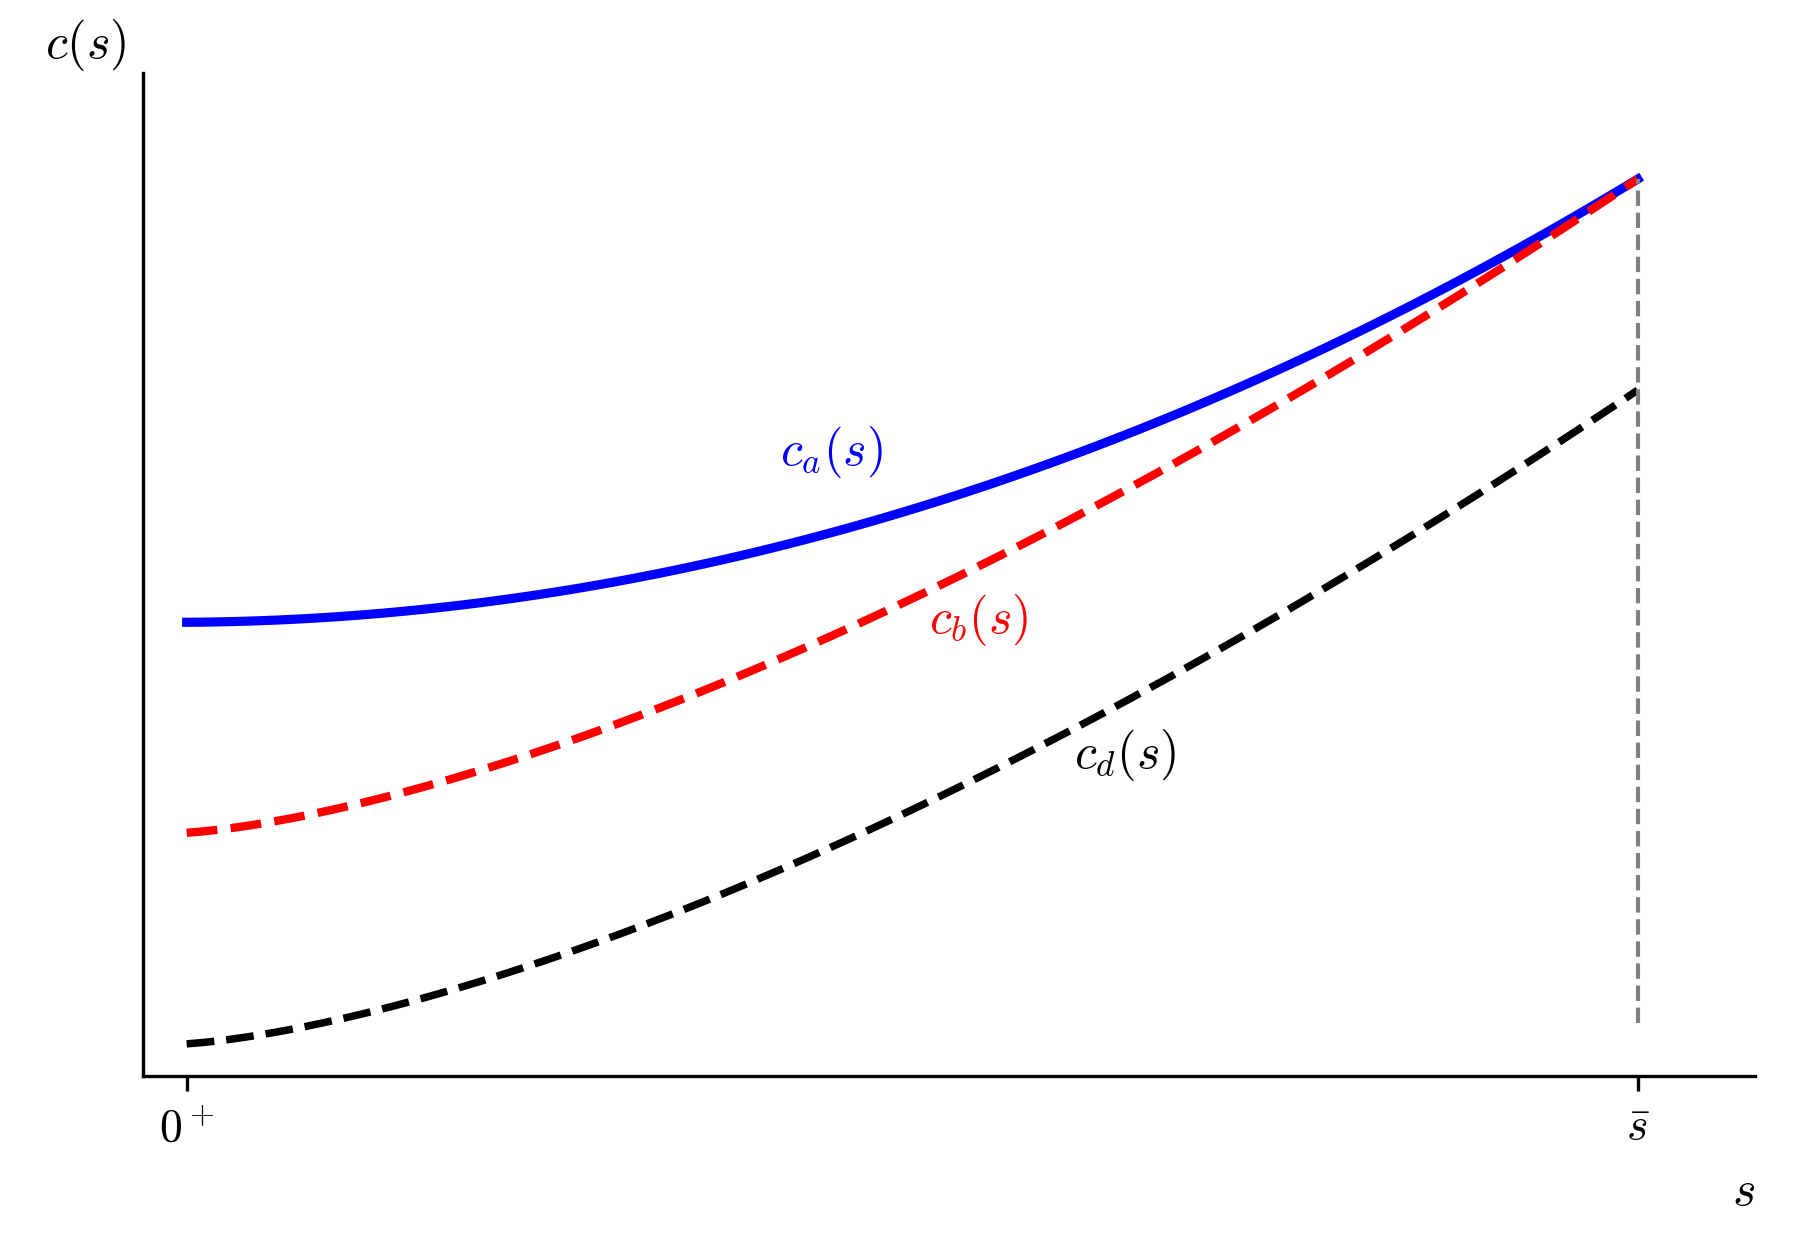
Lemma 12 证明:Proposition 7 中的端点重合条件 cb(s¯)=ca(s¯)c_{b}(\overline{s}) = c_{a}(\overline{s}) 和端点导数条件并非苛刻的刚性边界。对其中一个或两个条件进行温和松弛,反常效应依然严格成立!

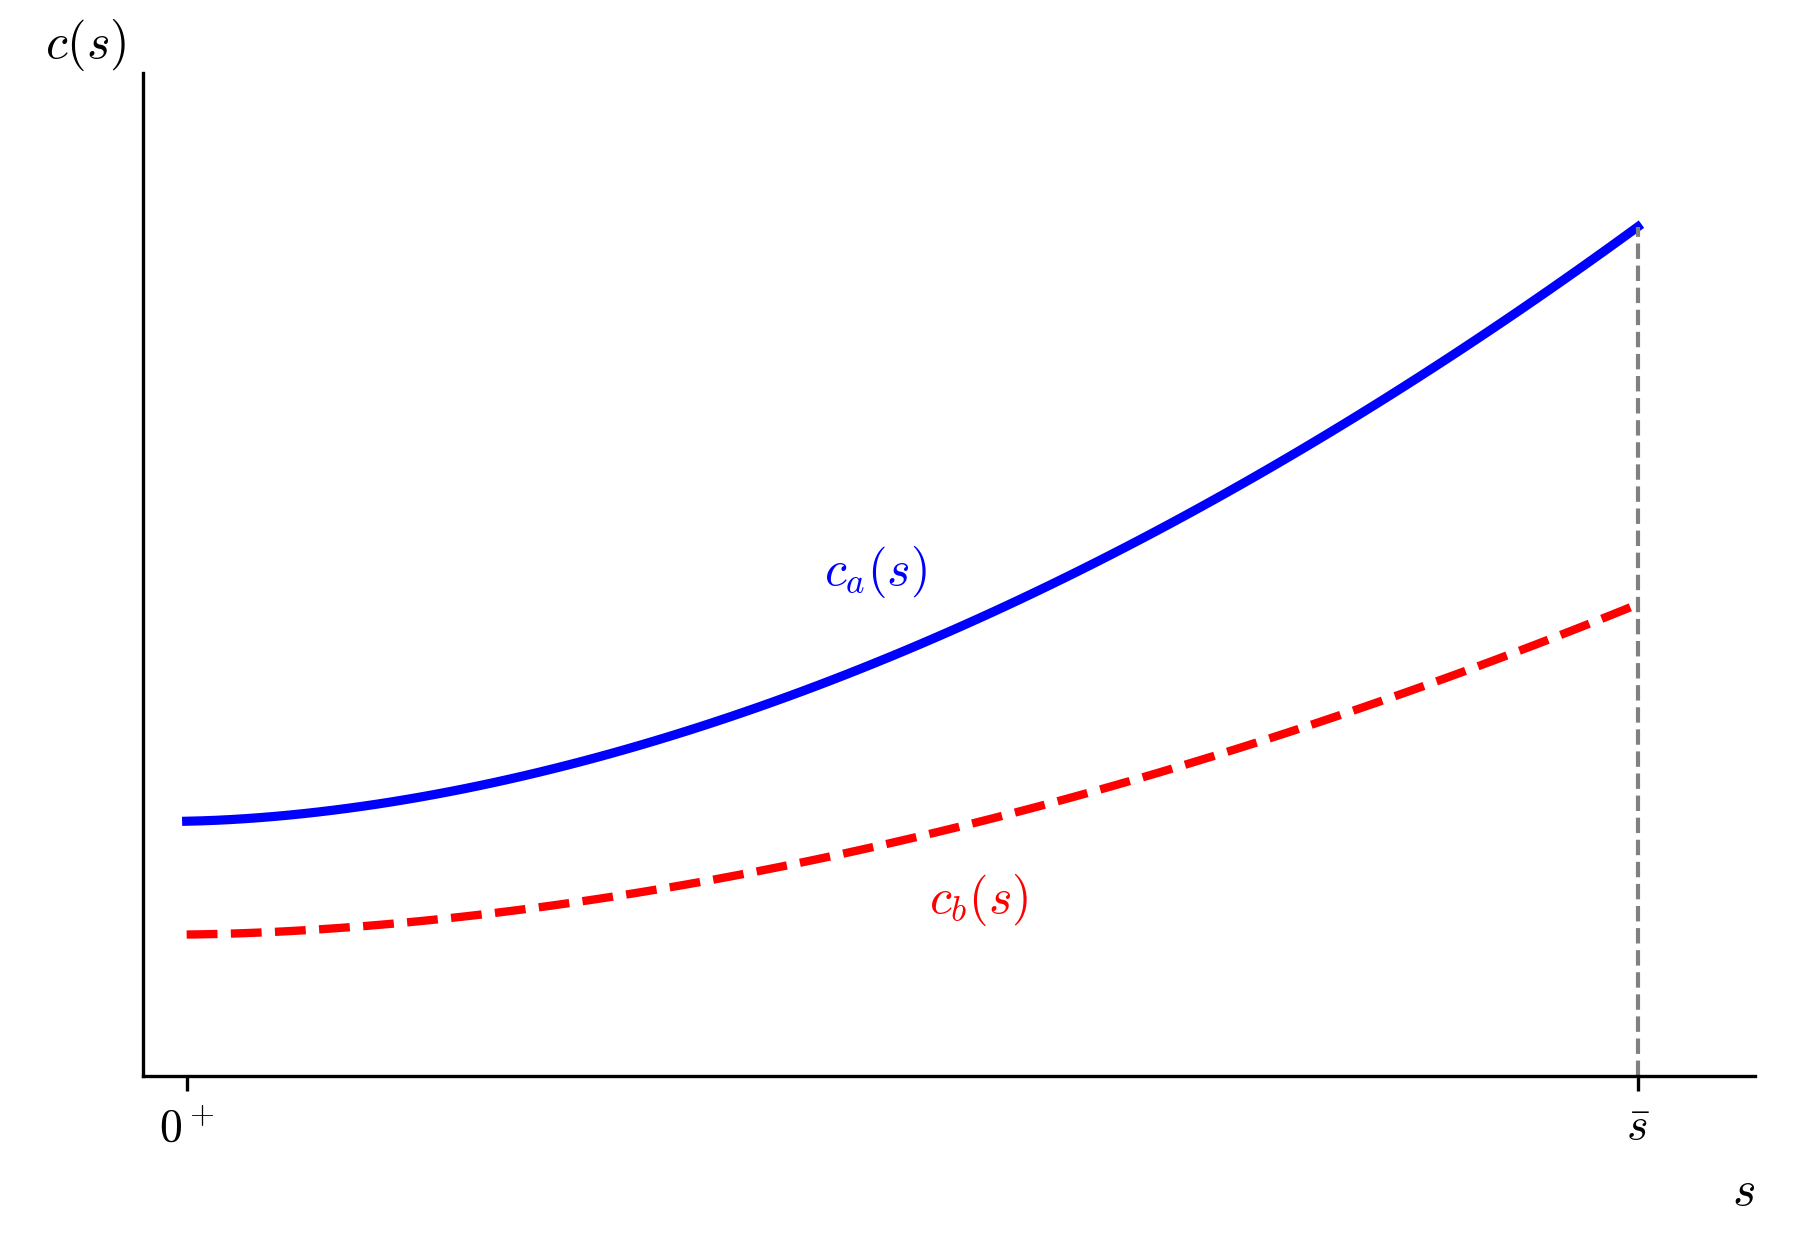
• Example 1(平行下移,图 11):在满足 Proposition 7 的 cb(s)c_{b}(s) 基础上向下平移常数 dd 得到 cd(s)=cb(s)−dc_{d}(s) = c_{b}(s) - d。对于介于 cbc_{b} 与 cdc_{d} 之间的所有曲线,其端点低于 ca(s¯)c_{a}(\overline{s}),但卖方收益依然严格高于 ca(s)c_{a}(s);

• Example 2(斜率放宽):从 cd(0+)c_{d}(0^{+}) 出发且斜率大于 cd′c_{d}\prime 的曲线,即使端点低于 ca(s¯)c_{a}(\overline{s}) 且端点斜率超过阈值,卖方收益依然高于高成本 ca(s)c_{a}(s)。

图 11:Lemma 12 中反常效应条件的温和松弛与成本曲线簇

图解与经济学意义:图中展示了基准高成本曲线 ca(s)c_{a}(s)、满足 Proposition 7 的中间曲线 cb(s)c_{b}(s) 以及平移下界曲线 cd(s)c_{d}(s)。介于 cbc_{b} 与 cdc_{d} 之间的广阔曲线族均能触发反常效应,证明了反常效应在现实中的普适性与稳健性。

4.5 灵活搜寻与受限搜寻的福利比较(Flexible vs. Restricted Search)

Proposition 8(灵活连续搜寻相较于受限固定搜寻的优越性)

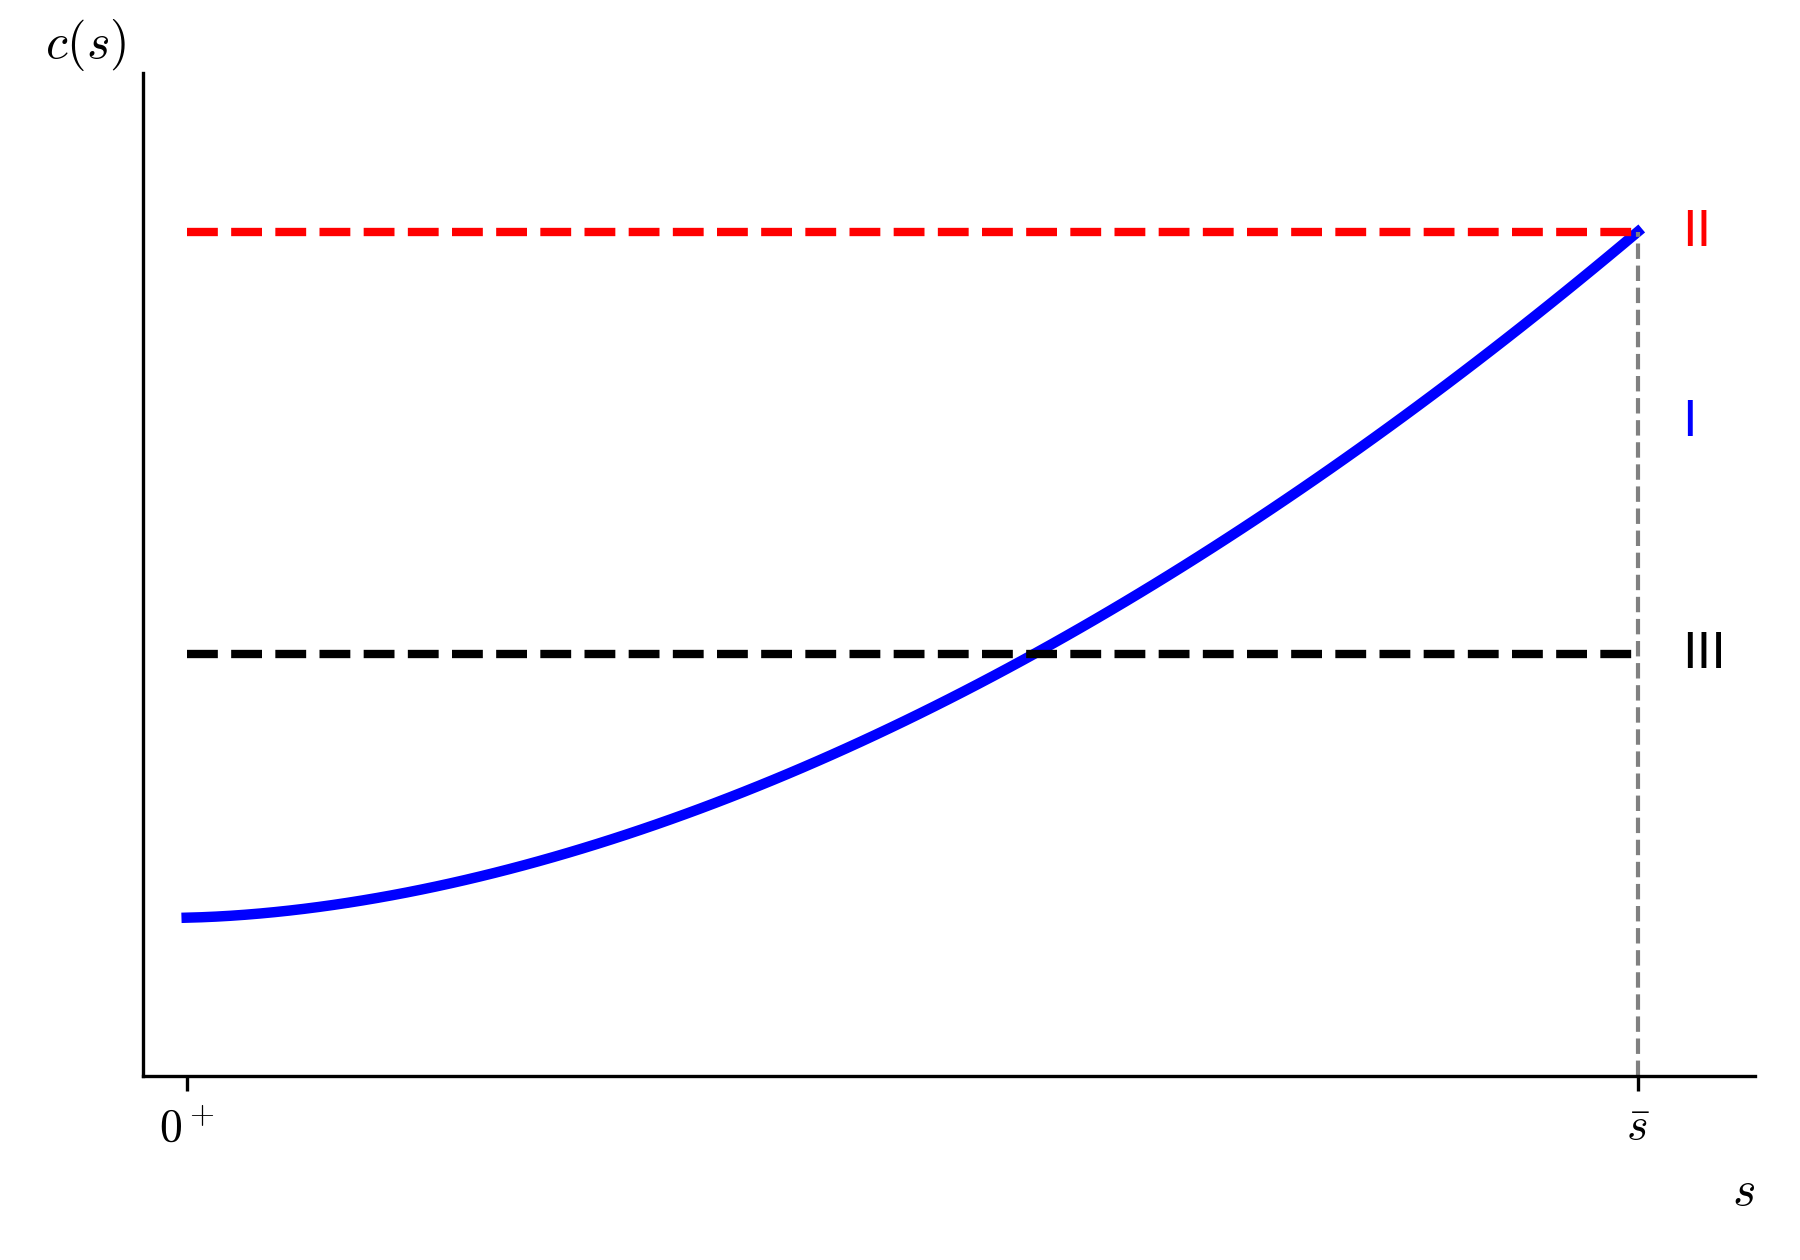
只要固定搜寻成本不超过连续可变成本的最大值,且连续成本满足 c′(s¯)≤−∫0v¯G2(v|s¯)dvc\prime(\overline{s}) \leq - \int_{0}^{\overline{v}}{}G_{2}(v|\overline{s})dv,则卖方在面对允许买方自由连续调整搜寻强度的灵活搜寻环境(情境 I)时,收集到的期望收益严格高于强制买方在 {0,s¯}\{ 0,\overline{s}\} 中二选一的受限搜寻环境(情境 III)。

图 12:三种搜寻情境的成本曲线对比(I: 灵活连续成本;II: 高固定成本;III: 低固定成本)

图解与经济学意义:由 Proposition 6,情境 II 优于情境 III(提高固定成本有益);由 Proposition 7,情境 I 优于情境 II(反常效应使连续曲线优于高固定线)。传递性推导得出:灵活连续搜寻(情境 I)严格优于低固定受限搜寻(情境 III)。

【Proposition 8 的经济学深意】为什么卖方更偏好买方拥有连续搜寻的自由度?根本原因在于,在卖方最优机制下,道德风险约束内生非绑定。卖方能够通过购买期权菜单中的执行价格 p(u)p(u) 与期权溢价 D(u)D(u),完美地引导买方自发选择符合社会效率的搜寻强度。连续搜寻赋予了卖方更精细地调控买方搜寻行为的自由度,将买方搜寻的灵活性完全转化为了卖方的额外利润!

4.6 数值模拟验证与参数敏感性分析

为了直观验证上述比较静态命题,论文开展了系统的数值模拟实验。设定基准环境为:买方估值服从标准均匀分布 F(u)=uF(u) = u(u∈[0,1]u \in \lbrack 0,1\rbrack),外部收益条件分布为幂律分布 G(v|s)=vsG(v|s) = v^{s}(v∈[0,1],s∈[0,1]v \in \lbrack 0,1\rbrack,s \in \lbrack 0,1\rbrack)。

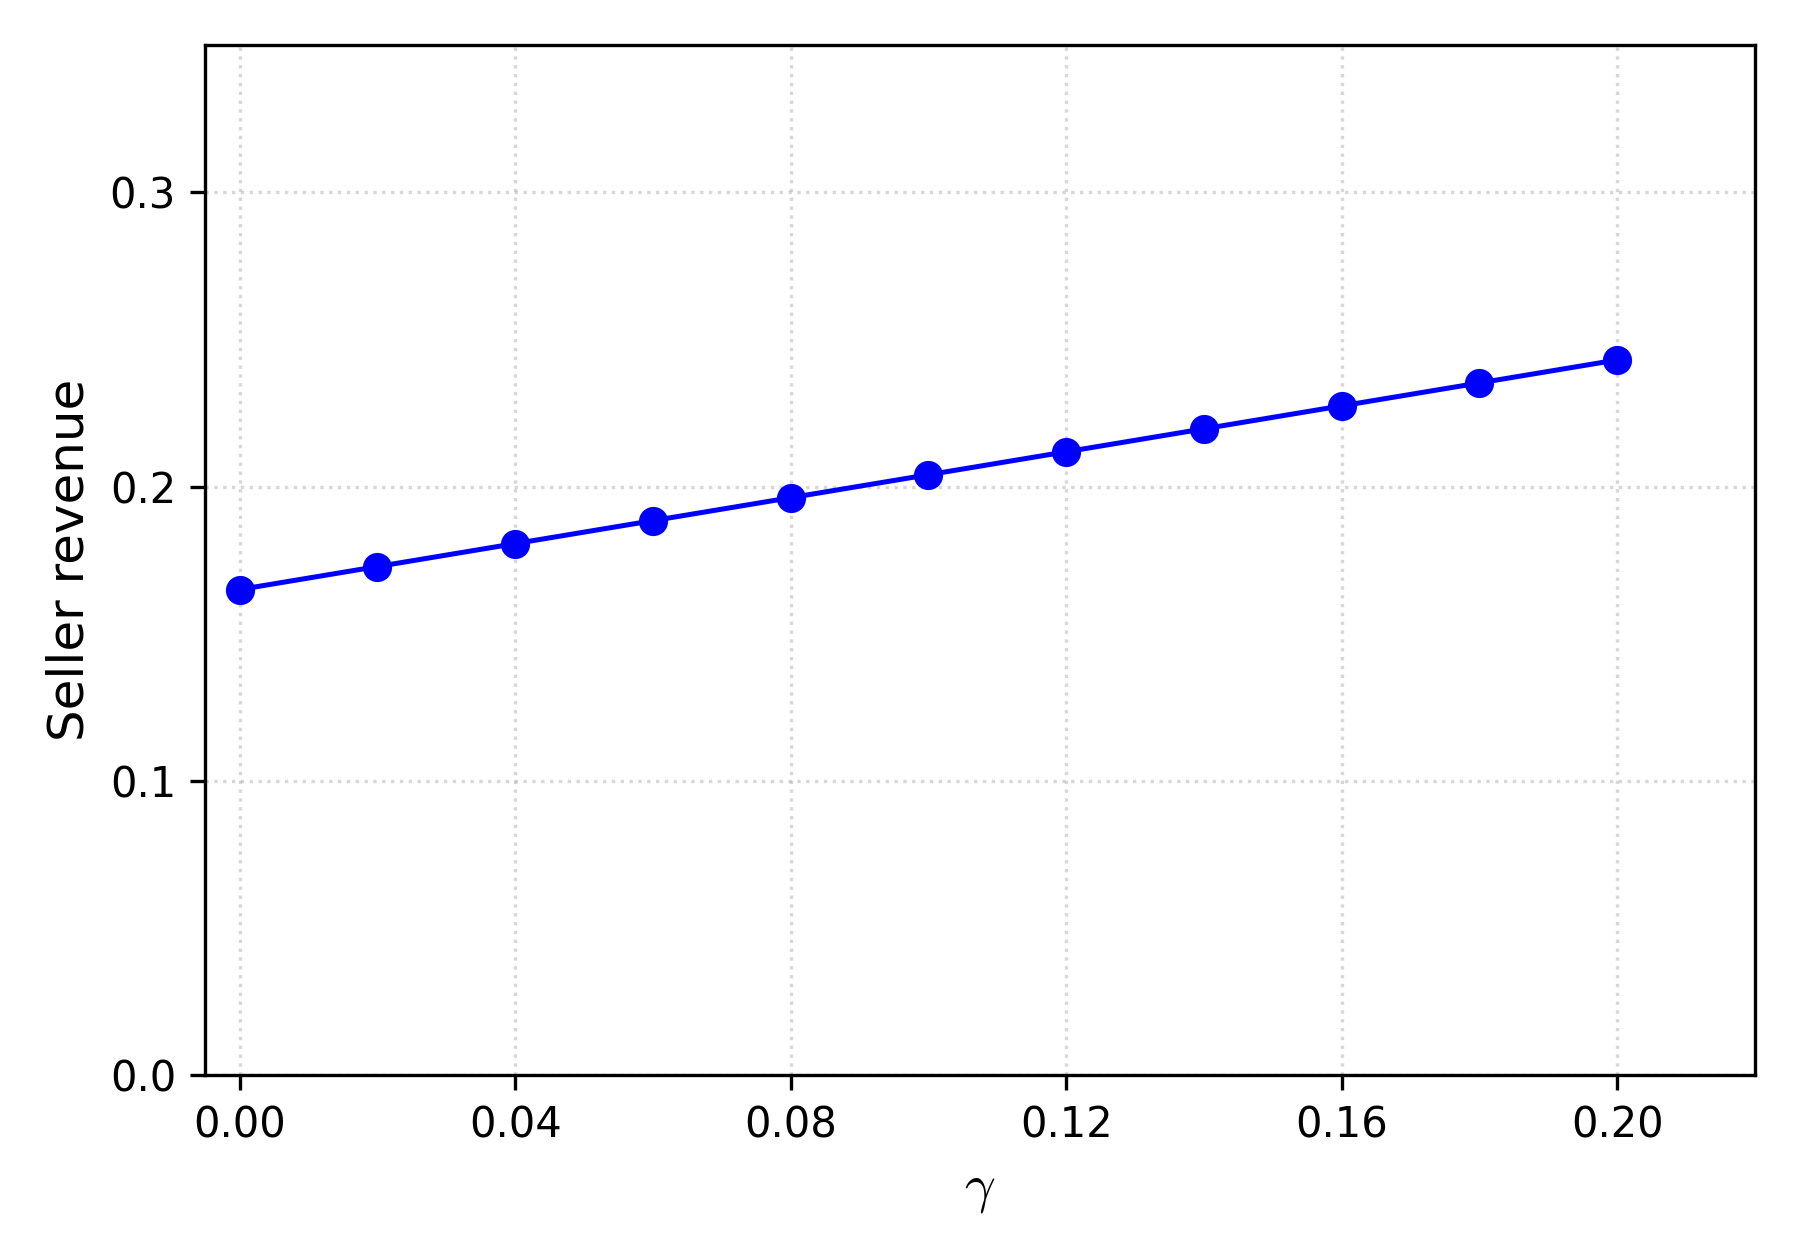
图 13:固定搜寻成本参数 γ\gamma 对卖方期望收益的影响 (c(s)=γ+0.5s2c(s) = \gamma + 0.5s^{2})

图解与经济学意义:图中清晰表明:当搜寻成本函数发生纯加性截距上移时(γ\gamma 从 00 上升至 0.200.20),卖方期望收益从 0.1650.165 单调线性增长至 0.2450.245,完美验证了 Proposition 5(i) 关于加性平移单调增益的结论。

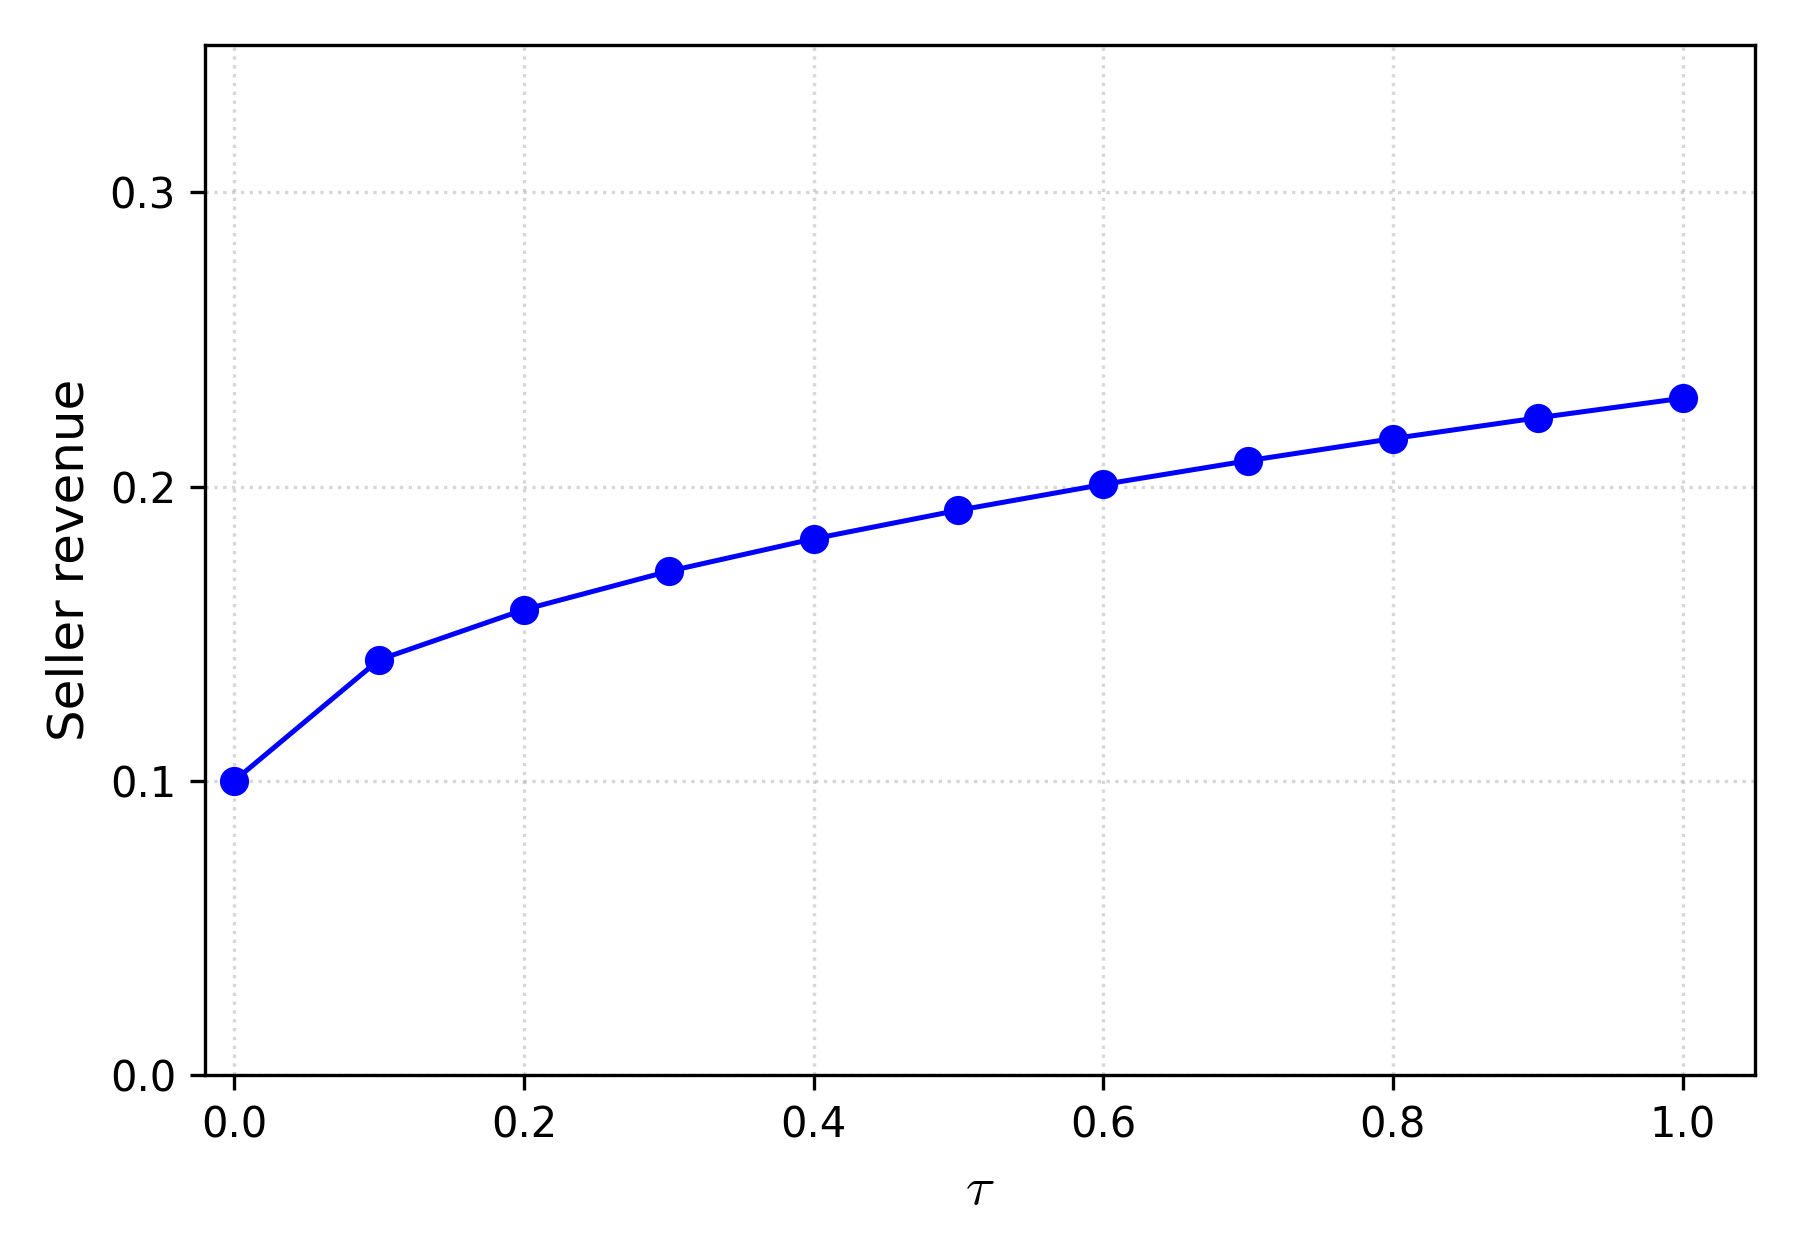
图 14:边际搜寻成本斜率参数 τ\tau 对卖方期望收益的影响 (c(s)=0.1+τs2c(s) = 0.1 + \tau s^{2})

图解与经济学意义:图中表明:当边际搜寻成本曲率增加时(τ\tau 从 00 上升至 1.01.0),卖方收益呈现单调递增且边际放缓的凹型增长曲线,由 0.100.10 上升至 0.230.23,严格印证了 Proposition 4 关于边际成本上升强化搜寻威慑效应的理论预测。

第五章 全文结论总结与管理/政策启示

5.1 理论结论全景回顾

本文突破性地将买方连续搜寻强度引入两阶段动态机制设计模型,彻底革新了对外部搜寻与最优定价互动的传统认知。研究表明:

1. 卖方最优机制可通过‘购买期权菜单’落地实施,期权溢价内生由搜寻成本函数决定;

2. 道德风险在最优点内生非绑定,卖方推荐与买方自发最优搜寻强度达成精妙统一;

3. 降低买方搜寻成本并非必然恶化卖方收益,在特定曲率结构下反常效应能够显著提升卖方利润;

4. 保持搜寻环境的灵活性优于粗暴限制买方搜寻选择。

5.2 对企业定价与销售机制设计的管理启示

【启示 1:积极引入具有不可退定金的购买期权机制】在婚宴、定制旅行、B2B设备采购、房地产租售等存在显著外部搜寻的行业,企业不应仅提供单一的‘即时一口价’,而应设计包含不可退订金(期权溢价 D(u)D(u))与锁定价格(执行价格 p(u)p(u))的期权菜单,允许高价值客户支付小额定金后继续比价,锁定犹豫型买方的返还概率。

【启示 2:战略性优化搜寻阻力而非盲目设立壁垒】传统商业观念认为企业应竭尽全力提高客户离开搜寻的门槛(如隐藏价格、制造信息迷雾)。本文表明,如果企业能够通过降低客户初步搜寻的启动成本、但借助专业对比工具让深度搜寻的边际成本提高,反而能通过反常效应降低客户的保留要价,实现卖方收益的最大化。

5.3 对数字电商平台与信息中介的商业启示

【启示 1:平台站内比价工具的机制重构】电商平台(如亚马逊、淘宝、携程)提供站内比价工具虽然降低了消费者的搜寻门槛,但平台可以通过推荐算法的设计,使消费者对差异化长尾商品的边际搜寻成本保持合理坡度,从而促进商家提供更优的购买期权与保价服务。

【启示 2:搜寻自由度与生态繁荣的共赢】平台不应过度限制消费者的比价跨度(如封禁外部比价插件),而应建立灵活开放的搜寻生态。在完全灵活的搜寻环境下,商家可以通过动态机制设计提取更高的渠道价值。

5.4 对反垄断与消费者保护政策的监管启示

【启示 1:审慎评估平台的搜寻便利化举措】反垄断监管机构在评估平台‘一键比价’或‘跨平台搜索’功能时,不能简单假定降低搜寻成本就必然等同于消费者剩余增加。若商家随之调整期权溢价与锁定价格,卖方可能通过反常效应提取更多剩余,监管部门需综合评估消费者最终成交价与福利分布。

【启示 2:警惕暗度陈仓的搜寻阻力重构】监管机构应重点关注平台是否通过‘初期便利、后期锁定’(即利用前期低成本吸引消费者,但在深度比价时制造算法摩擦)来人为构造有利于卖方提取租金的非常规成本曲线,切实保护消费者的知情权与自主选择权。

第六章 参考文献 (References)

Armstrong, M., and J. Zhou. 2016. "Search Deterrence." Review of Economic Studies 83 (1): 26–57.

Baron, D. P., and D. Besanko. 1984. "Regulation and Information in a Continuing Relationship." Information Economics and Policy 1 (3): 267–302.

Bergemann, D., and J. Välimäki. 2019. "Dynamic Mechanism Design: An Introduction." Journal of Economic Literature 57 (2): 235–274.

Chang, D. 2021. "Optimal Sales Mechanism With Outside Options." Journal of Economic Theory 195: 105279.

Choi, M., A. Y. Dai, and K. Kim. 2018. "Consumer Search and Price Competition." Econometrica 86 (4): 1257–1281.

Courty, P., and H. Li. 2000. "Sequential Screening." Review of Economic Studies 67 (4): 697–717.

Danskin, J. M. 1967. The Theory of Max-Min and Its Application to Weapons Allocation Problems. New York: Springer-Verlag.

Diamond, P. A. 1971. "A Model of Price Adjustment." Journal of Economic Theory 3 (2): 156–168.

Dogan, M., and J. Hu. 2022. "Consumer Search and Optimal Information." RAND Journal of Economics 53 (2): 386–403.

Eső, P., and B. Szentes. 2007. "Optimal Information Disclosure in Auctions and the Handicap Auction." Review of Economic Studies 74 (3): 705–731.

Eső, P., and B. Szentes. 2017. "Dynamic Contracting: An Irrelevance Theorem." Theoretical Economics 12 (1): 109–139.

Garrett, D. F., and A. Pavan. 2012. "Managerial Turnover in a Changing World." Journal of Political Economy 120 (5): 879–925.

Gershkov, A., and M. Perry. 2012. "Dynamic Contracts With Moral Hazard and Adverse Selection." Review of Economic Studies 79 (1): 268–306.

Gibbard, A. 1973. "Manipulation of Voting Schemes: A General Result." Econometrica 41 (4): 587–601.

Grossman, S. J., and O. D. Hart. 1983. "An Analysis of the Principal-Agent Problem." Econometrica 51 (1): 7–45.

Hadley, G., and W. R. Russell. 1969. "Rules for Ordering Uncertain Prospects." American Economic Review 59 (1): 25–34.

Halac, M., N. Kartik, and Q. Liu. 2016. "Optimal Contracts for Experimentation." Review of Economic Studies 83 (3): 1040–1091.

Holmström, B. 1979. "Moral Hazard and Observability." Bell Journal of Economics 10 (1): 74–91.

Hurwicz, L. 1972. "On Informationally Decentralized Systems." In Decision and Organization, edited by C. B. McGuire and R. Radner, 297–336. Amsterdam: North-Holland.

Kim, K., and M. Pease. 2017. "Costly Search With Adverse Selection: Solicitation Curse Versus Acceleration Blessing." RAND Journal of Economics 48 (2): 526–553.

Krähmer, D., and R. Strausz. 2011. "Optimal Procurement Contracts With Pre-Project Planning." Review of Economic Studies 78 (3): 1015–1041.

Krähmer, D., and R. Strausz. 2015. "Optimal Sales Contracts With Withdrawal Rights." Review of Economic Studies 82 (2): 762–790.

Li, H., and X. Shi. 2017. "Discriminatory Information Disclosure." American Economic Review 107 (11): 3363–3385.

Liu, B., D. Liu, and J. Lu. 2020. "Shifting Supports in Esö and Szentes (2007)." Economics Letters 193: 109251.

Liu, B., and J. Lu. 2018. "Pairing Provision Price and Default Remedy: Optimal Two-Stage Procurement With Private R&D Efficiency." RAND Journal of Economics 49 (3): 619–655.

Liu, D., and J. Lu. 2026. "Buyer's Hidden Search With Continuous Intensity: The Seller-Optimal Mechanism and a Perverse Effect." The RAND Journal of Economics 57 (3): 686–704.

Lu, J., and Z. Wang. 2021. "Optimal Selling Mechanisms With Buyer Price Search." Journal of Economic Theory 196: 105307.

Maskin, E., and J. Riley. 1984. "Monopoly with Incomplete Information." RAND Journal of Economics 15 (2): 171–196.

McCall, J. J. 1970. "Economics of Information and Job Search." Quarterly Journal of Economics 84 (1): 113–126.

Milgrom, P., and I. Segal. 2002. "Envelope Theorems for Arbitrary Choice Sets." Econometrica 70 (2): 583–601.

Mirrlees, J. A. 1971. "An Exploration in the Theory of Optimum Income Taxation." Review of Economic Studies 38 (2): 175–208.

Mirrlees, J. A. 1976. "The Optimal Structure of Incentives and Authority within an Organization." Bell Journal of Economics 7 (1): 105–131.

Mortensen, D. T. 1970. "A Theory of Wage and Employment Dynamics." In Microeconomic Foundations of Employment and Inflation Theory, edited by E. S. Phelps, 167–211. New York: Norton.

Myerson, R. B. 1979. "Incentive Compatibility and the Bargaining Problem." Econometrica 47 (1): 61–73.

Myerson, R. B. 1981. "Optimal Auction Design." Mathematics of Operations Research 6 (1): 58–73.

Myerson, R. B. 1986. "Multistage Games With Communication." Econometrica 54 (2): 323–358.

Pavan, A., I. Segal, and J. Toikka. 2014. "Dynamic Mechanism Design: A Myersonian Approach." Econometrica 82 (2): 601–653.

Riley, J. G., and W. F. Samuelson. 1981. "Optimal Auctions." American Economic Review 71 (3): 381–392.

Rothschild, M., and J. E. Stiglitz. 1970. "Increasing Risk: I. A Definition." Journal of Economic Theory 2 (3): 225–243.

Rothschild, M., and J. E. Stiglitz. 1976. "Equilibrium in Competitive Insurance Markets: An Essay on the Economics of Imperfect Information." Quarterly Journal of Economics 90 (4): 629–649.

Spence, M. 1973. "Job Market Signaling." Quarterly Journal of Economics 87 (3): 355–374.

Stigler, G. J. 1961. "The Economics of Information." Journal of Political Economy 69 (3): 213–225.

Wang, C. 2017. "Advertising as a Search Deterrent." RAND Journal of Economics 48 (4): 949–971.

Weitzman, M. L. 1979. "Optimal Search for the Best Alternative." Econometrica 47 (3): 641–654.