共享属性竞赛中的努力决策:数理模型、博弈均衡与机制设计全景解析
Effort Decisions in Contests with Shared Attributes · 全文深度重构与学术精解
📋 论文出版信息与排版规范说明 【论文原载】Mathematics of Operations Research, Volume 51, Number 3, August 2026, pp. 1794–1823 (INFORMS) 【作者团队】何嘉豪 (Jiahao He), 张季恒 (Jiheng Zhang), 张Rachel (Rachel Q. Zhang) · 香港科技大学工业工程与决策分析系 (HKUST IEDA) 【学科分类】MSC2020: 91A12 (Cooperative/Noncooperative Games), 91B32 (Resource Allocation); JEL: C72, D72, D74 【基金资助】香港研究资助局 (Hong Kong RGC) Grants 16200821, 16500023, T32-615/24-R 【排版规范】正文行距 1.5 倍行距,正文字体小四号 (12 pt),全部数学符号与表达式均采用 Word 原生公式 (OMML) 渲染。 |
|---|
一、论文概述与文献脉络定位
在现代政治竞选、商业竞标、学术科研以及体育竞技等诸多领域中,决策者往往需要同时应对多场相互关联的竞赛活动。例如,一名大学学者既需要申报面向前沿理论探索的基础研究基金,又需要争取面向产业实际落地的应用研发项目;一位政治家可能同时角逐多个委员会的主席或席位;一名服装设计师需要针对不同审美偏好的细分消费市场设计服饰;一名体操运动员则需同时备战自由体操、跳马、高低杠与平衡木等多项比赛。
这些并行的竞赛在底层往往依赖于若干共同的“技能”或“属性”(Attributes,如数学建模、实验技能、口头表达、人际沟通、美学鉴赏等)。由于这些属性在不同竞赛之间的重要程度不同,甚至存在冲突,参赛者在某一特定属性上投入成本所带来的技能提升,会对多场竞赛的获胜概率产生复杂的溢出效应(Spillover Effects):在某些竞赛中产生积极促进作用,在另一些竞赛中则可能带来负面制约。
传统竞赛理论(Contest Theory)大多建立在单一竞赛或无共享属性的多战场资源分配博弈(Colonel Blotto Games)框架之上,默认各竞赛战场之间是相互隔离的,竞赛者仅在总预算约束下对各个战场分配直接的资源投入。然而,现实中底层属性的共享导致了多场竞赛之间内生出复杂的统计与经济相关性。由香港科技大学(HKUST)工业工程与决策分析系的何嘉豪(Jiahao He)、张季恒(Jiheng Zhang)与张Rachel(Rachel Q. Zhang)三位学者于 2026 年发表在顶级运筹学与管理学期刊 Mathematics of Operations Research 上的开创性论文《Effort Decisions in Contests with Shared Attributes》,首次建立了完整的微观数理模型,系统解答了参赛者在共享属性约束下如何做出最优努力配置决策,并给出了竞赛设计者的最优机制设计原则。
1.1 经典文献演进与本文定位
为了准确把握本文在运筹学与微观博弈论中的学术坐标,我们将相关文献划分为两大经典脉络,并梳理其演进路径:
(1)单一竞赛理论(Single Contest Literature)
在经典单一竞赛模型中,参赛者通过付出努力成本来提升自身在 contest success functions(CSF)下的胜率,胜者赢得既定奖酬 (Corchón and Serena 2018)。在此基础上,创新竞赛与众包文献引入了随机绩效得分函数:Terwiesch and Xu (2008) 研究了三种典型随机环境下的最优奖酬方案,发现高随机性下“胜者全得(Winner-takes-all)”激励是最优的;Ales et al. (2017) 进一步给出了同质参赛者下胜者全得方案最优的充要条件;Stouras et al. (2022) 探讨了参赛者数量与能力不确定下的筛选机制;Mihm and Schlapp (2019) 则深入分析了信息反馈策略。另一支重要分支直接将参赛者的决策建模为绩效得分的概率分布,并在期望得分上施加约束(Bell and Cover 1980; Myerson 1993; Anderson 2012)。Alpern and Howard (2017) 提出了广义分布排序博弈(Distribution Ranking Games),为多人无声决斗博弈的混合策略求解提供了强大工具。
(2)多竞赛与布洛托上校博弈(Multiple Contests & Colonel Blotto Games)
当参赛者面对多场竞赛时,核心问题转变为有限资源在多个战场上的最优配置(Borel 1953)。Roberson (2006) 首次完全刻画了资源连续可分情形下一般战场数量的布洛托博弈均衡解。随后,学者们从多维度拓展了该框架:Macdonell and Mastronardi (2015) 探讨了非线性资源约束;Hart (2008, 2016) 以及 Kovenock and Roberson (2012, 2021) 将确定性预算推广为期望预算约束;Thomas (2012) 求解了异质奖酬战场的均衡;Shubik and Weber (1981) 引入了战场间的互补性;Boix-Adserà et al. (2020) 则构造了多人同质竞赛者的对称均衡。
在现有所有多竞赛文献中,竞赛的胜负完全由参赛者在该竞赛上的直接资源投入决定,并未刻画底层属性的交叉共享机制。本文首次将多维度属性空间 及其二次成本矩阵 引入多竞赛分析,填补了这一理论空白。
二、论文核心学术贡献体系
🌟 论文核心学术突破与理论创新体系 1. 首次确立共享属性微观机理:打破了多竞赛无底层属性关联的传统假设,建立了由属性权重向量 、二次成本矩阵 及竞赛相关性 构成的微观决策模型,揭示了技能在多场竞赛中的正向协同与负向替代效应。 2. 独创高维决策空间“降维定理”:属性维度 通常远超竞赛数量 ()。本文通过代数标准化与下层最优成本投影,证明了 维高维努力决策可严格等价规约为 维期望得分空间中的二次优化问题 ,使得高维混合策略的求解成为可能。 3. 完整刻画确定性博弈纳什均衡:在零随机性下,严格证明了正相关竞赛退化为单竞赛线性支持集均衡;负相关竞赛展现出极其优美的非线性椭圆弧段支持集;完全相反竞赛在对称两人博弈下产生独特的“全员零努力和平纯策略均衡”;并在多人极限下以 的速度收敛到边界射线。 4. 揭示噪声对混合策略的平滑过渡机制:在随机干扰下,证明了高噪声直接导致确定性纯策略均衡;低噪声(如均匀分布)下产生离散有限点支持集混合策略,并随噪声 平滑逼近确定性连续混合策略,完美桥接了博弈论中纯策略与混合策略的鸿沟。 5. 发现不完全信息对博弈决策的“纯化效应”:在异质参赛者拓展中,完全信息会导致冷酷的“挤出效应”(仅 Class 1 和 Class 2 付出努力,其余退出);而在不完全信息(私有能力分布 )下,参赛者的私有天赋天然转化为对手眼中的随机性,促使全员采用确定性纯策略积极参与,实现了博弈论中的经典纯化。 6. 提出多竞赛高效启发式聚类合并算法:针对 的复杂网络,提出了基于相关性贪心合并的启发式算法。数值实验证实其偏离收益率 极低,具备卓越的工程实用性。 7. 导出竞赛设计者的最优对称奖酬公式:给出了最大化总产出减奖酬成本的最优对称奖金闭式解 ,揭示了正相关性增强时应主动压缩奖酬以防止租金消散的管理新逻辑。 |
|---|
三、数理模型构建与降维定理推导
3.1 基本符号、设定与微观假设
考虑 个同质竞赛者,记为集合 ,同时参加 场竞赛,记为 。两场竞赛由 个潜在属性()共同表征。
(1)竞赛特征与属性权重向量
竞赛 由获胜奖金 以及单位属性重要性向量 刻画。 衡量了各项属性对竞赛 获胜概率的边际贡献:分量为正表示该属性有利于获胜,为负表示不利,为零表示无关。不失一般性,假设 为单位向量(),则内积 即为两竞赛属性向量夹角的余弦值。当 时两竞赛完全相同,当 时两竞赛属性要求完全相反。
(2)参赛者决策与绩效得分函数
参赛者 的决策变量为 维属性努力向量 。 表示提升属性 的水平, 表示刻意降低该属性水平。参赛者 在竞赛 中的最终得分由确定性努力产出与均值为零的随机冲击加总构成:
|
式 (1):参赛者实际得分公式 |
|---|
其中 为满足 的随机噪声。在竞赛 中,得分最高的参赛者赢得全部奖励 ;若有多人并列最高分,则均分该奖励。
(3)二次努力成本与最有效努力方向
参赛者付出非零努力 会产生二次成本 ,其中 为对称正定矩阵。 的对角线元素反映单独提升某一属性的边际成本,非对角线元素则反映同时发展两项属性时的协同成本节省(负值)或技能冲突成本惩罚(正值)。
数学性质推论:向量 代表参赛者能够以最低成本最有效提升竞赛 期望得分的努力方向。标量 衡量了参赛者在竞赛 中的综合竞争力(值越大,表明在该竞赛中将成本转化为得分的潜力越强)。
(4)共享属性下的竞赛相关性定义
当参赛者沿着第一场竞赛的最有效方向 提升自身期望得分时,其在第二场竞赛中的得分变动取决于 与 的内积。因此,论文将两场竞赛之间的相关性严格定义为:
|
式 (2):竞赛相关性数学定义 |
|---|
• 正相关竞赛(Positive Correlation):。朝竞赛 1 的最优方向投资会自发对竞赛 2 产生积极溢出。\n• 零相关竞赛(Uncorrelated Contests):。朝竞赛 1 努力对竞赛 2 无任何溢出效应。\n• 负相关竞赛(Negative Correlation):。提升竞赛 1 的得分必须以牺牲竞赛 2 的得分或承受高昂成本为代价。
3.2 原始高维博弈规划与降维定理推导
在同质参赛者对称博弈下,参赛者选择一个 维概率分布 作为混合策略,求解如下最大化期望净收益的博弈问题:
|
式 (3):高维原始博弈优化问题 (Problem 1) |
|---|
由于属性维度 通常很大,直接求解定义在 上的多维未知支持集与联合分布 在数学上极度棘手。为此,论文提出了两步降维技术:
第一步:消除二次成本交叉项(变量标准化)
令 ,,。经过上述线性坐标变换,原问题等价转化为具有单位成本矩阵 的标准博弈。因此,在后续同质博弈分析中,直接设 ,此时竞赛相关性即为 。
第二步:决策空间向竞赛得分空间的投影降维
定义参赛者 在两场竞赛中的期望得分向量为 ,其中 。由于竞赛胜负仅取决于得分向量 ,对于给定的期望得分向量 ,理性的参赛者必然会选择能够实现该得分且总成本最低的属性努力向量。定义下层最小成本函数:
|
式 (4):降维后二维最小成本函数 |
|---|
由此,原 维优化问题成功降维为关于二维期望得分向量分布 的规划问题:
|
式 (5):降维后二维得分博弈问题 (Problem 3) |
|---|
一旦求得二维得分均衡分布 ,可通过下式唯一重构出参赛者在 维原始属性空间上的最优努力水平向量 :
|
式 (6):最优属性努力向量逆向重构公式 |
|---|
四、确定性博弈下的纳什均衡全解
当消除环境随机噪声,设 时,博弈进入完全确定性环境。由于确定性全付拍卖博弈中纯策略极易被对手微弱超越(-undercutting),参赛者在均衡时通常采用混合策略。
4.1 基础引理:对称纳什均衡充要条件(Lemma A.1)
📌 Lemma A.1:确定性博弈对称纳什均衡的充要变分方程 【引理内容】设 ,,。对称二维分布 是纳什均衡的充要条件为: 且 的支持集是该最大化目标函数 的 argmax 集合的子集。此外,在支持集上:当 时 随 单调递增;当 时 随 单调递减。 【证明要点】由于参赛者完全同质,在对称均衡下均分总奖励 。任何单点偏离收益上限必须恰好等于平均净收益。通过将最优得分转运问题转化为关于二次成本的 Monge-Kantorovich 运输问题,由 Mitroi and Niculescu (2011) 结论即证单调性。 |
|---|
4.2 命题 1:正相关竞赛下的线性支持集均衡 ()
📐 Proposition 1:正相关竞赛的单一竞赛等价性与线性支持集 【命题内容】当两场竞赛正相关时,存在唯一的混合策略纳什均衡: 1. 若 (两竞赛完全相同):,定义域为 ,且 ,。 2. 若 :参赛者从边际分布 中采样,定义域为 ,并严格设定 ,其中常数比例系数 为: 对应最优属性努力向量为 。 |
|---|
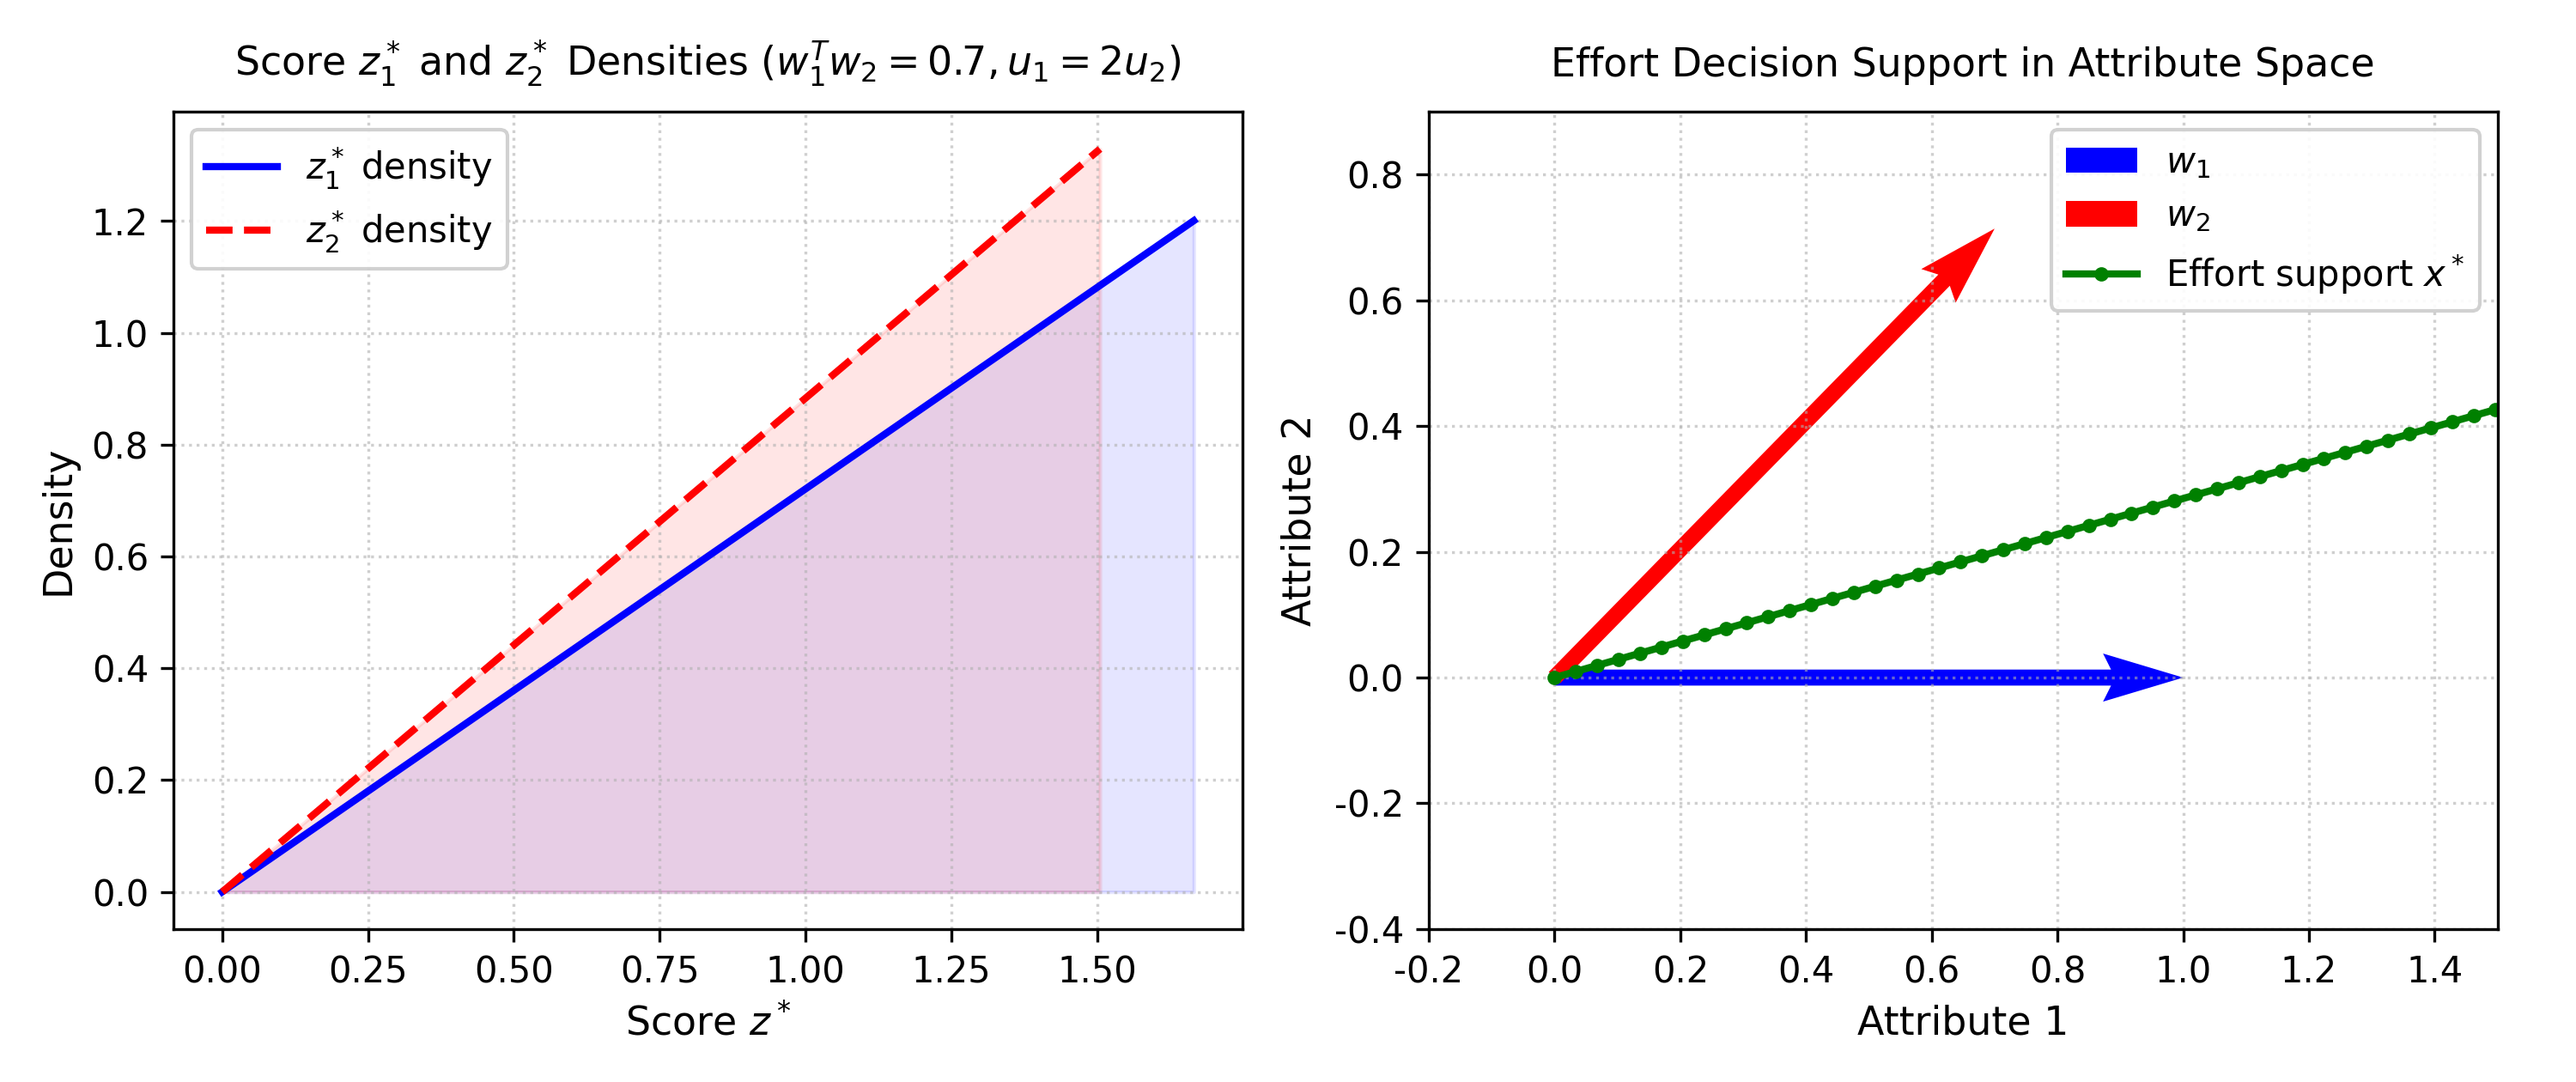
图 1:正相关竞赛下得分密度函数(左)与属性空间一维线性努力支持集(右,)
【图 1 深度解析与数理内涵】如上图所示,当 时,两场竞赛在努力方向上具有天然的协同性。参赛者无需分散精力去探索复杂的曲面,其最优决策直接坍缩为一条一维线性线段()。参赛者仅对“努力强度”进行随机化采样,而始终保持努力方向锁定在介于 与 之间的最优加权射线 上。这在数学上证明了正相关多竞赛等价于单一合成竞赛。
4.3 命题 2:零相关竞赛的独立分配均衡 ()
📊 Proposition 2:零相关竞赛的独立正交均衡与竞争稀释规律 【命题内容】当 时,任何边际分布满足 ()的二维分布 均为纳什均衡。总努力向量为 。 【竞争强度演化】随着参赛者总数 增加,边际概率密度函数呈现出显著形态演化:\n• 当 时,密度函数为严格递增的线性函数;\n• 当 时,密度函数退化为完全平坦的均匀分布(Uniform Distribution);\n• 当 时,密度函数转变为严格递减的凸函数,概率质量向 0 点聚集,体现出激烈的全员竞争导致的理性努力削减(理性放弃)。 |
|---|
4.4 命题 3:完全相反竞赛下的角点解与非对称博弈 ()
⚖️ Proposition 3:相反竞赛下的零努力纯策略与非对称右偏均衡 【命题内容】当 (即 )且 时,存在唯一纳什均衡: 1. 若 且 :存在唯一的纯策略纳什均衡,双方均付出零努力 ,直接平分总奖励 (和平博弈解)。 2. 若 且 :采用混合策略 ,支持集为 (退化为以 为奖金的单竞赛)。 3. 若 :混合策略满足隐式代数方程 ,定义域为 ,常数项为: |
|---|
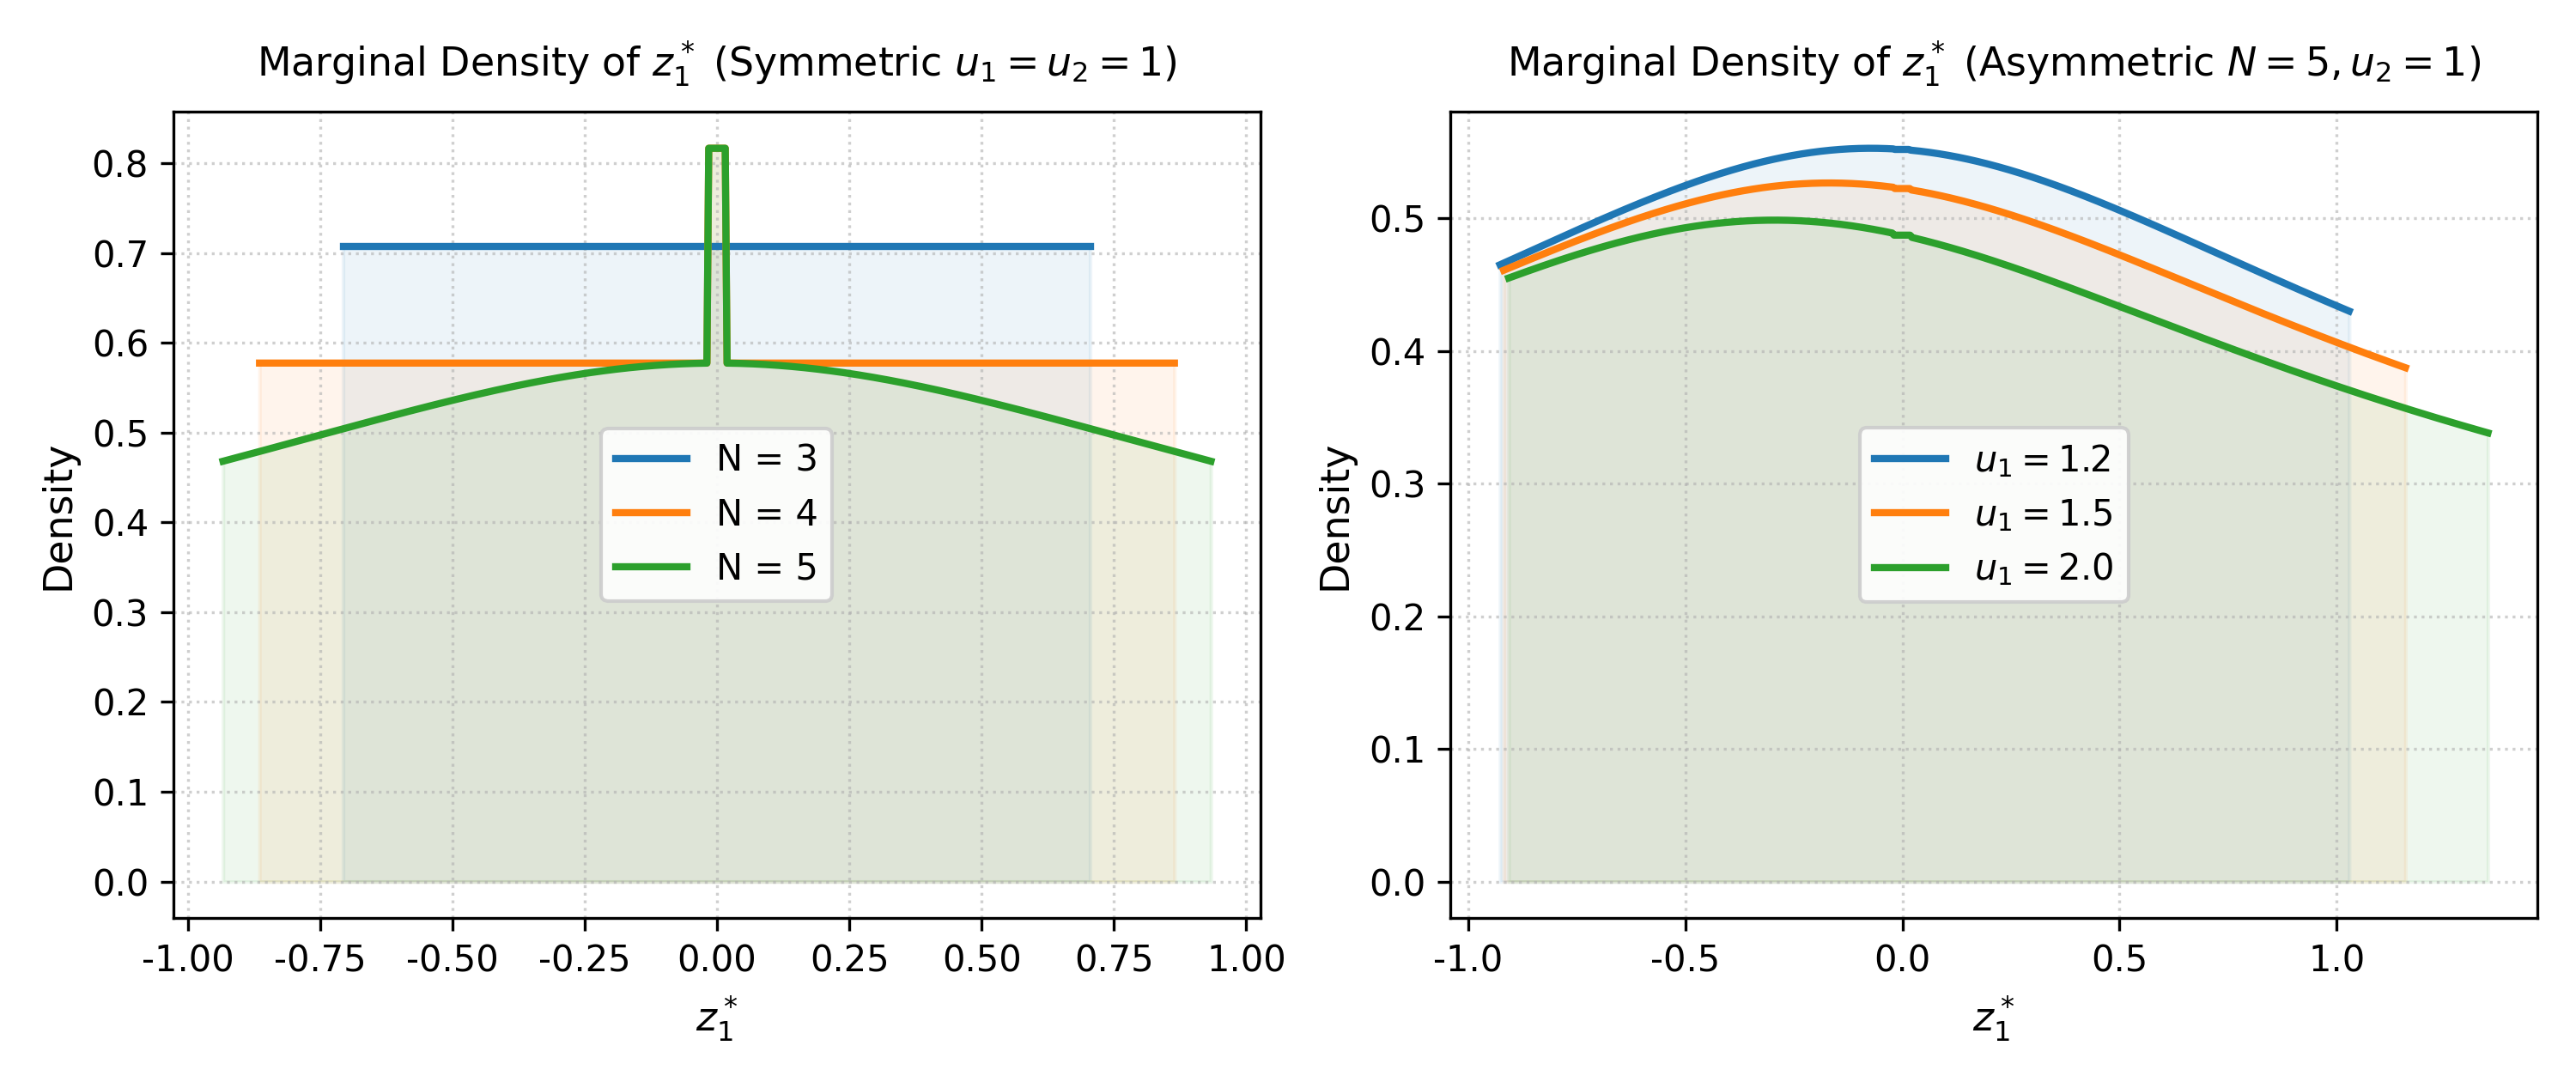
图 2:完全相反竞赛下边际密度曲线。左图:对称奖酬下 变动;右图:非对称奖酬下 变动引起的显著右偏
【图 2 深度解析】图 2(a) 清晰反映出,在对称相反竞赛中,增加竞争对手 会使得获胜概率被极度稀释,选手将密度集中在 0 附近;而图 2(b) 显示,当奖金出现非对称差距 时,选手会战略性地向高回报竞赛 1 倾斜,密度分布发生强烈的正向右偏。
4.5 命题 4:负相关竞赛中的椭圆支持集 ()
🌌 Proposition 4:负相关竞赛的非线性常微分方程组与椭圆弧段支持集 【命题内容】当两场竞赛负相关但非完全相反时,存在唯一的混合策略纳什均衡,其支持集为极坐标下的非线性曲线 ,,其中三元组 是如下常微分方程组的唯一解: 边界条件满足 。 【两选手对称特例 ()】闭式边际分布为: 其支持集为椭圆弧段:,其中 。 |
|---|
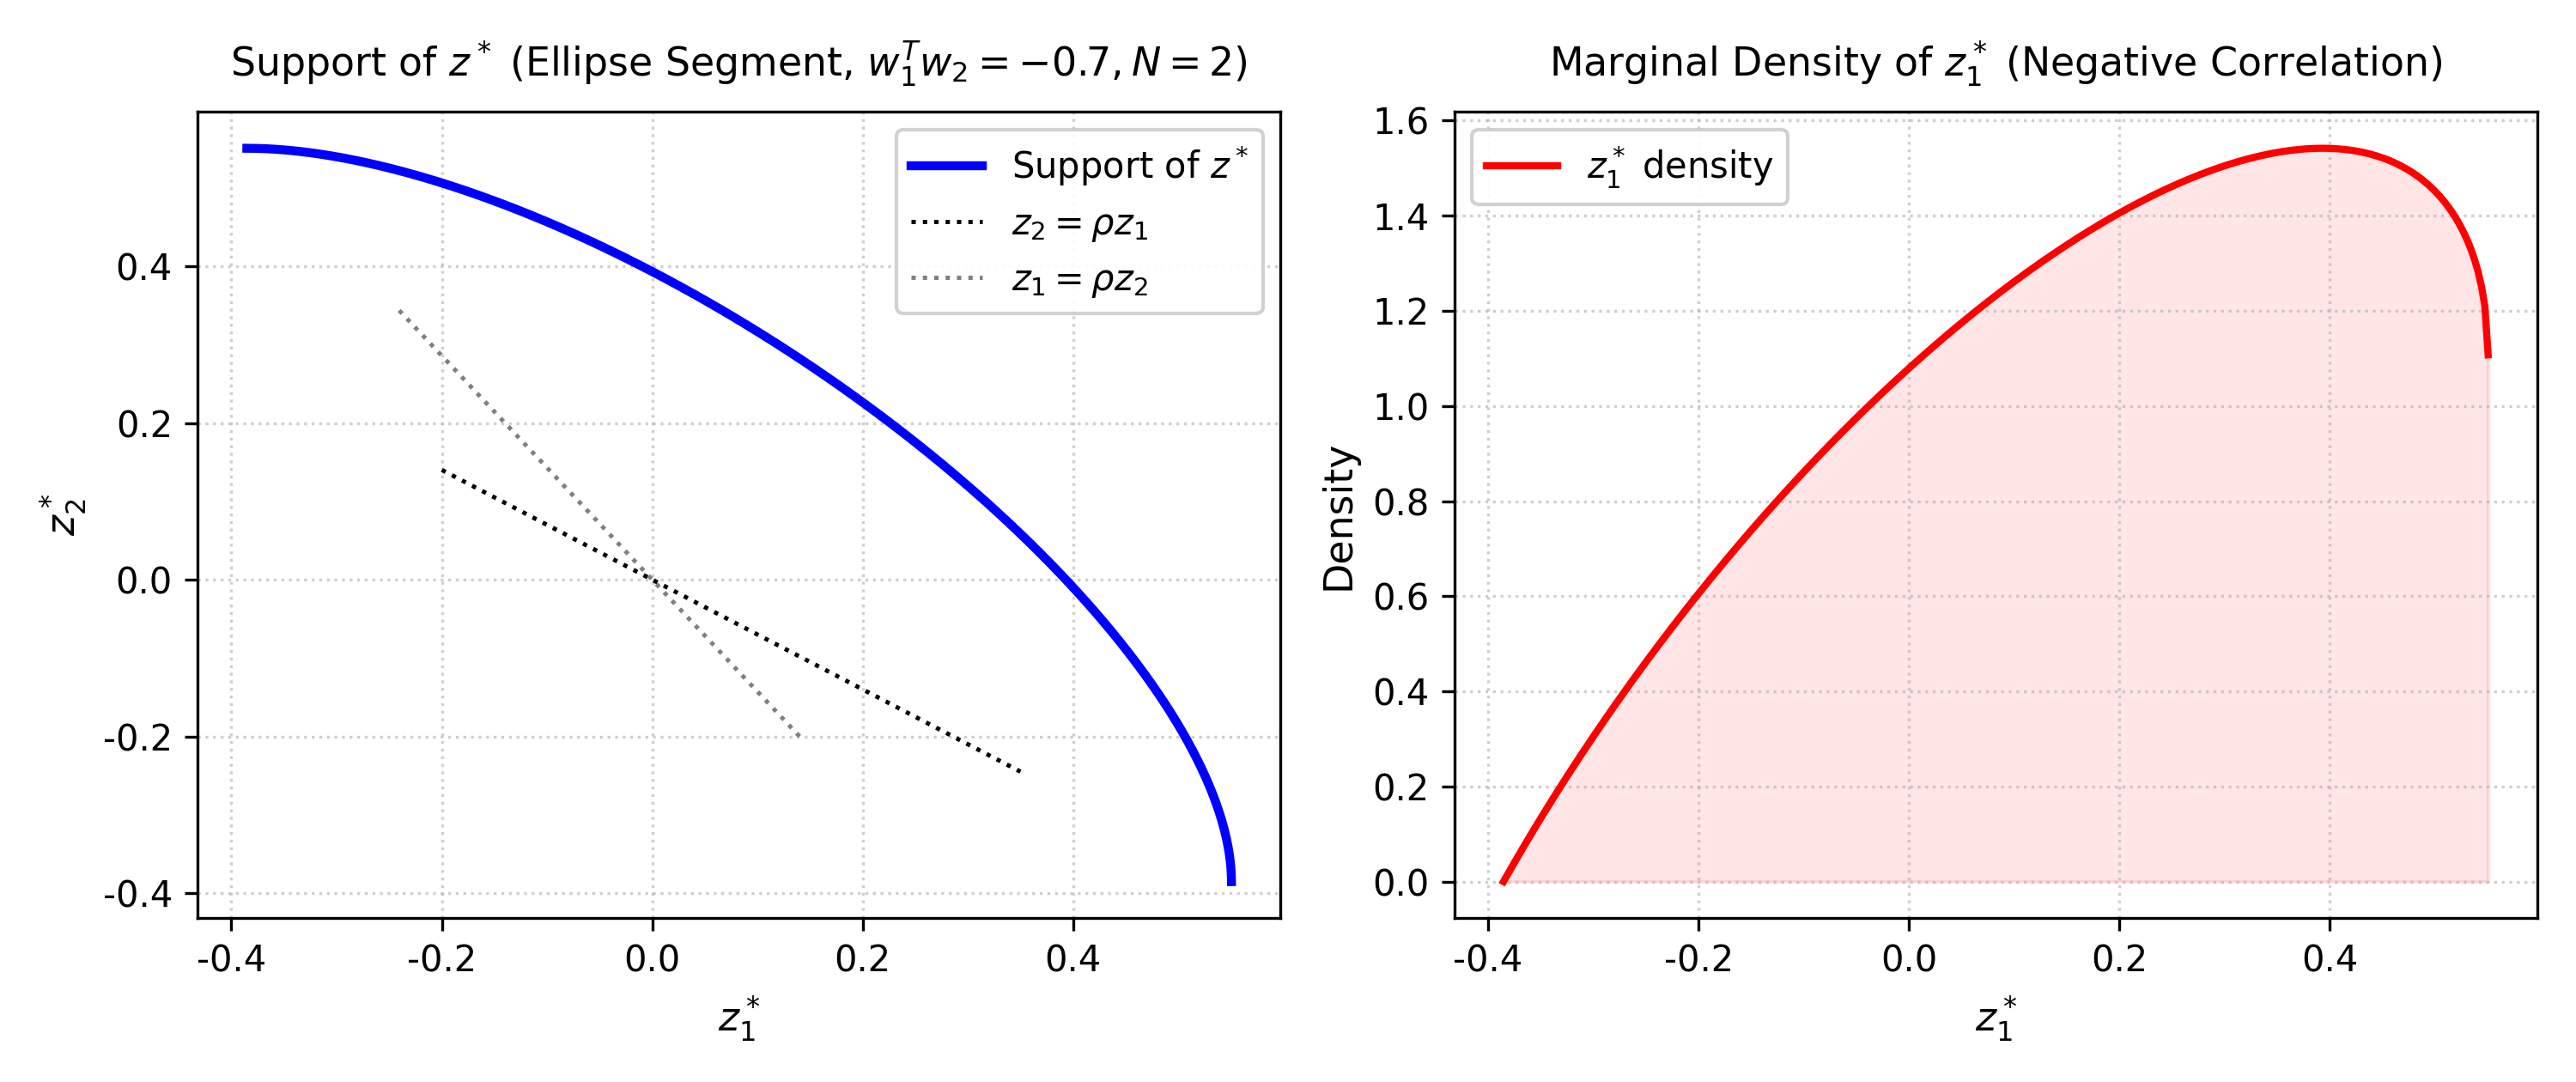
图 3:负相关 () 下向外弯曲的椭圆支持集(左)与中间隆起的倒 U 型边际密度(右)
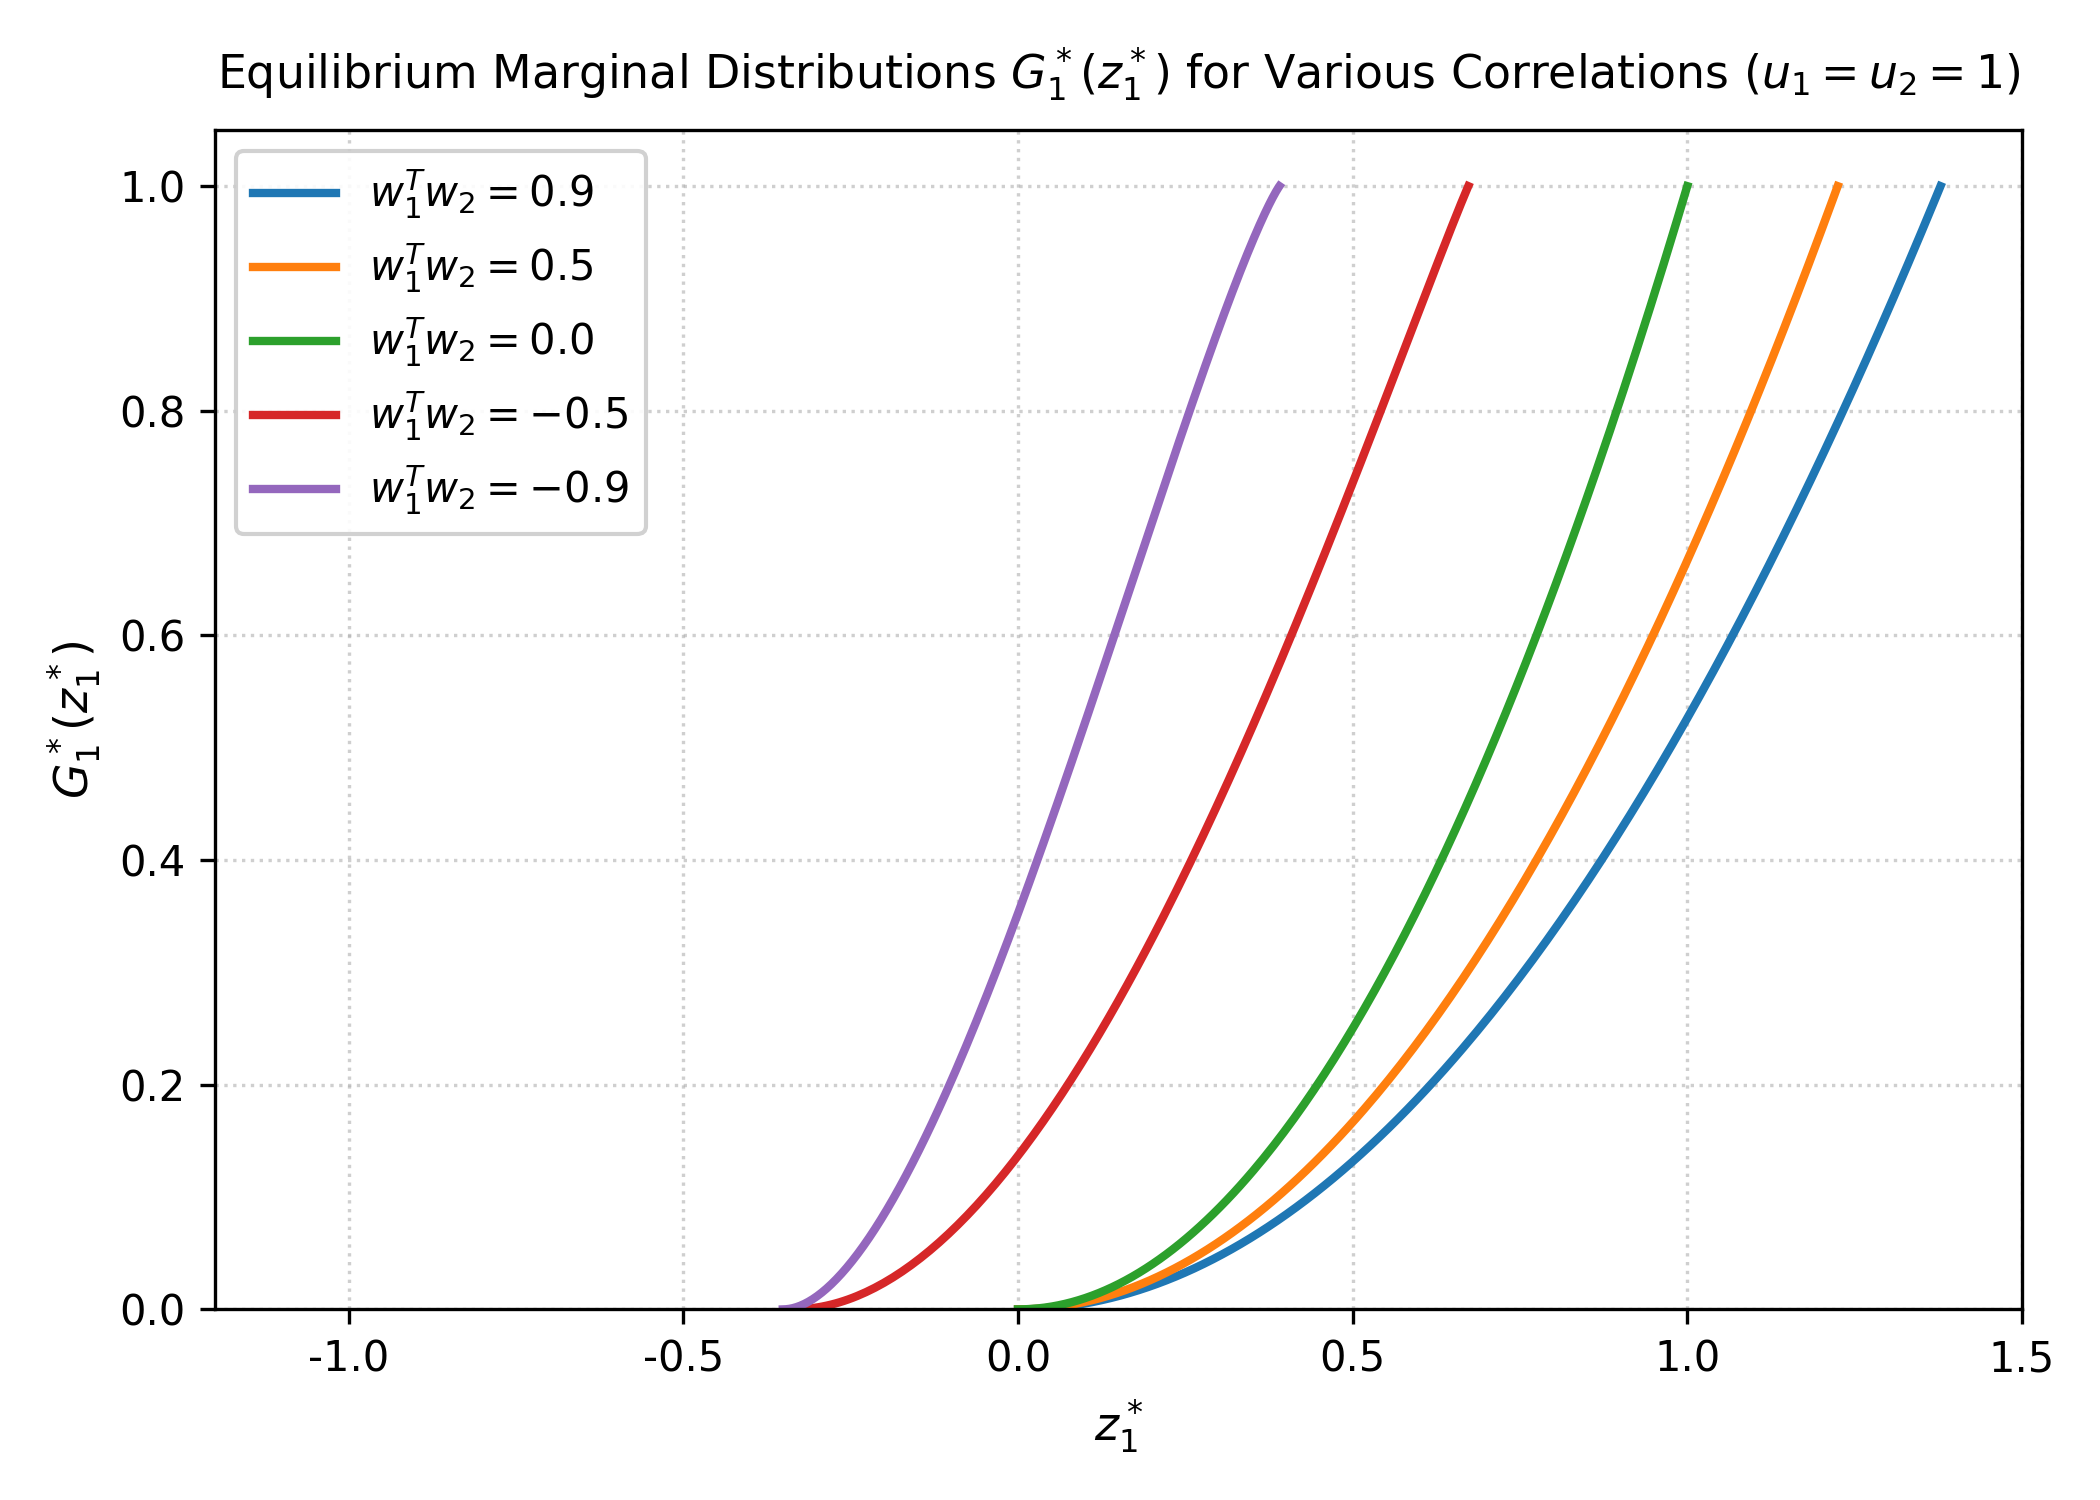
图 4:两场竞赛相关性从强正相关 (+0.9) 平滑演化至强负相关 (−0.9) 时边际分布 的连续相变
4.6 命题 5:高竞争强度极限下的边界射线收敛定理
⚡ Proposition 5:极度激烈竞争下的战略聚焦与边界射线收敛定理 【命题内容】当 时,随着参赛者数量 ,混合策略均衡分布 的二维支持集在概率测度上以 的指数级速度迅速收敛到两条边界折线射线: |
|---|
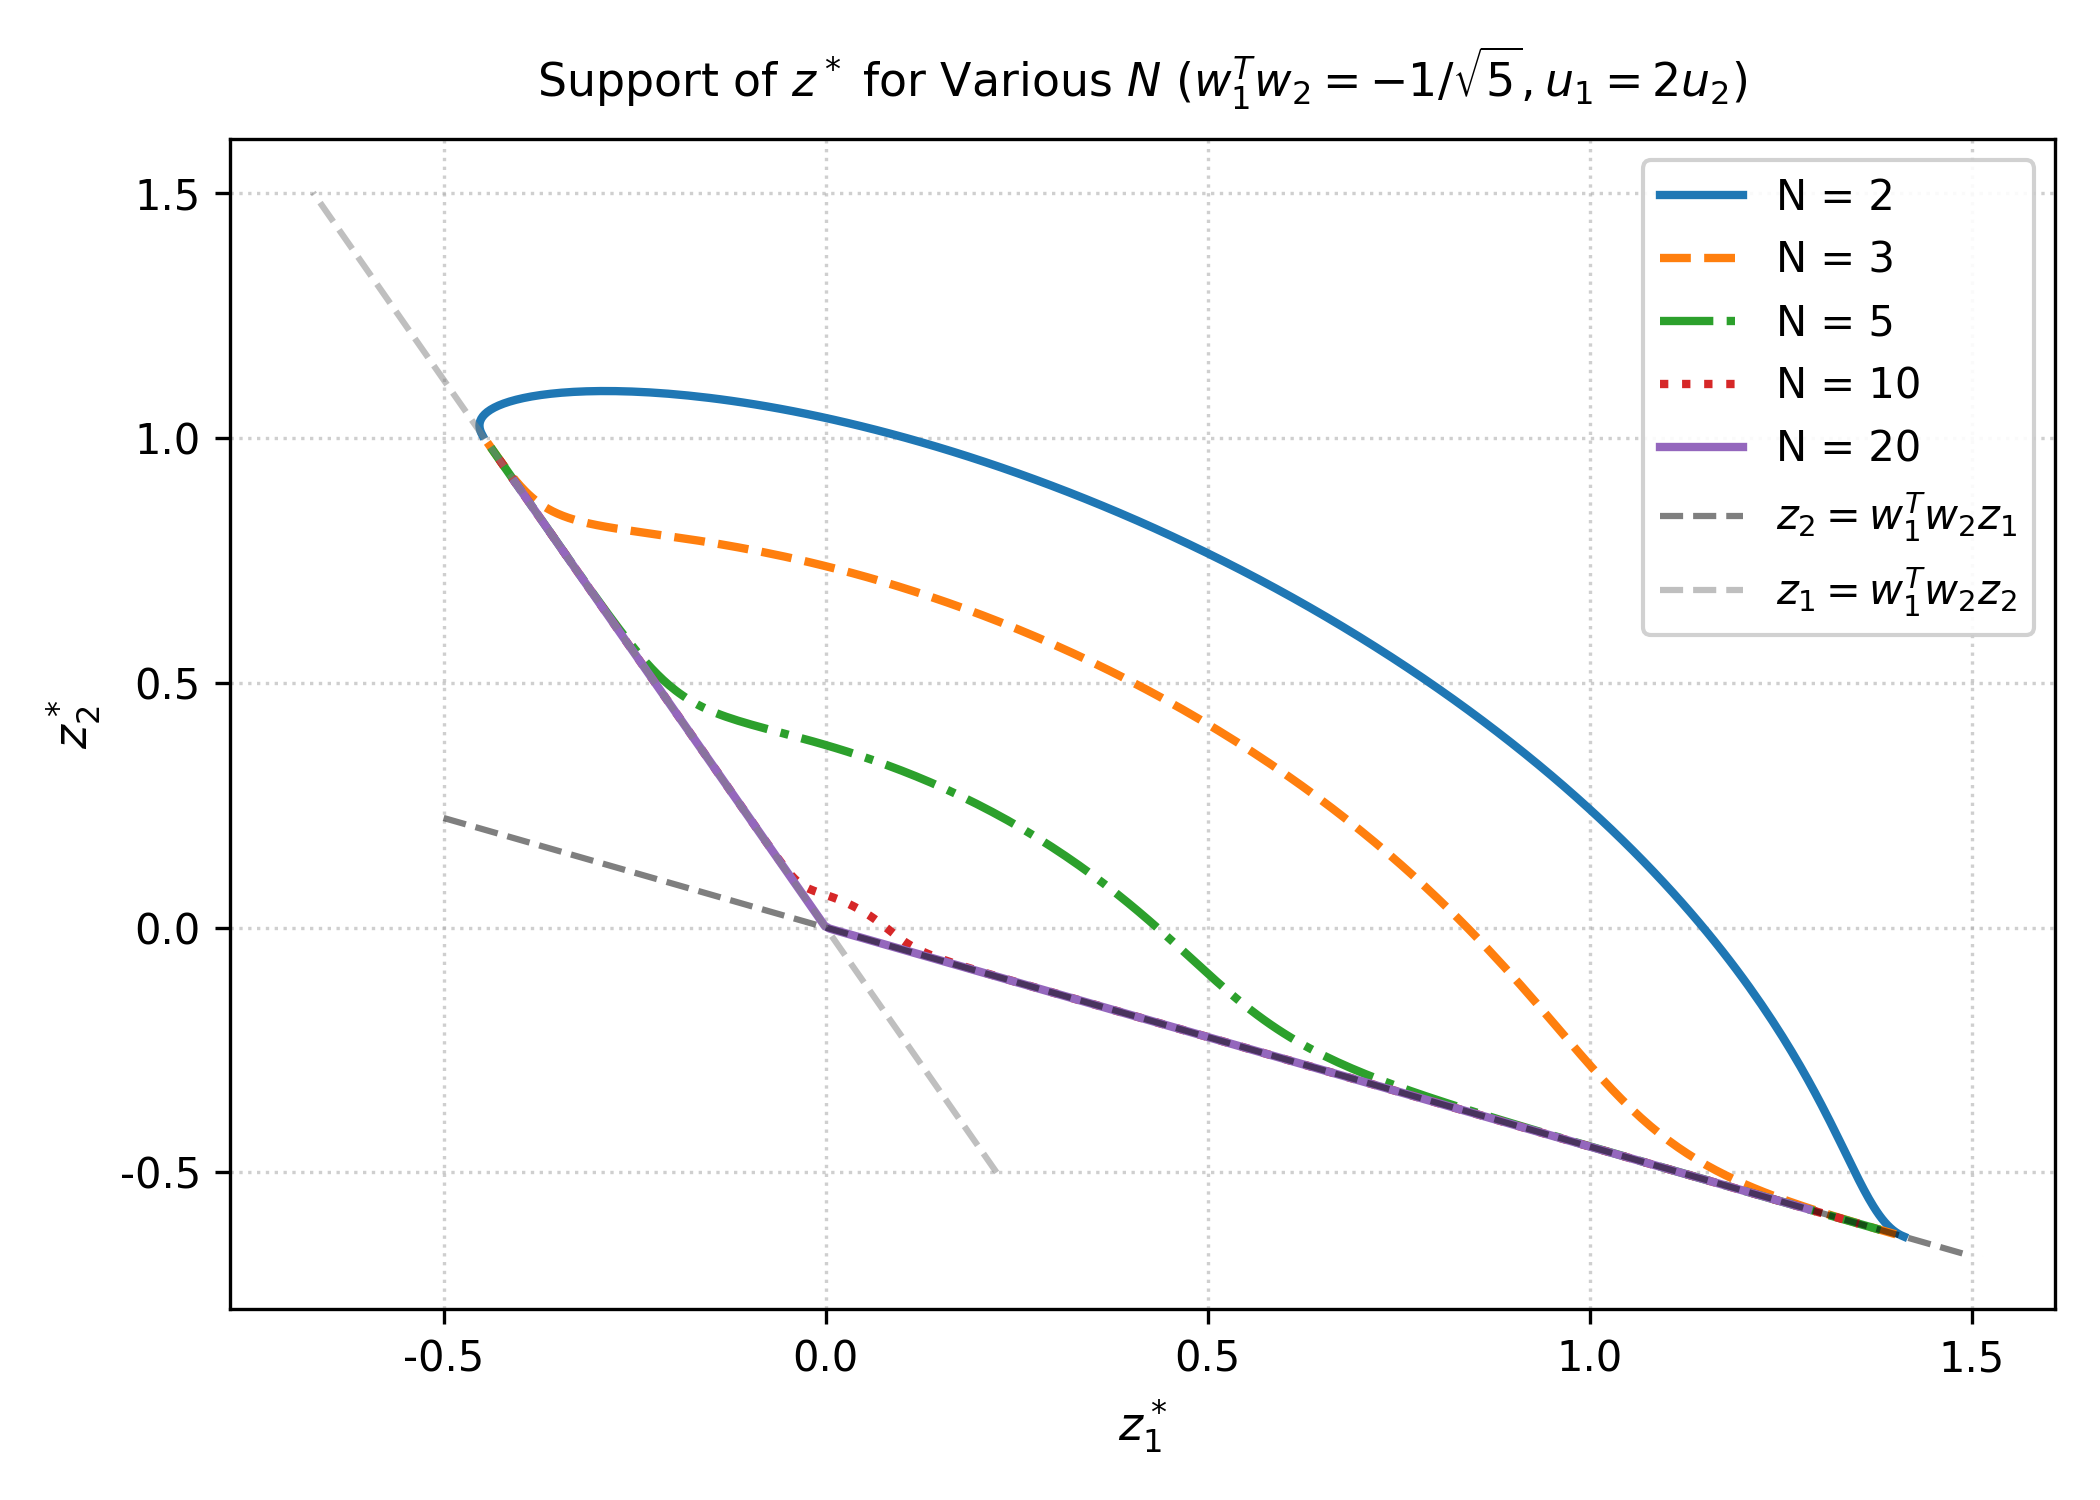
图 5:随着 从 2 递增至 20,负相关支持集曲线向边界射线 与 的收敛轨迹
【图 5 经济学含义】当竞争者数量极多时,两头兼顾的边际获胜概率极度微弱,试图在两场冲突竞赛中同时维持中等得分的成本远超收益。因此,参赛者在博弈演化中彻底抛弃了中间椭圆策略,转而将全部精力极端押注在单一赛道(专精特新),另一赛道得分则被迫降至最低。
五、随机干扰与不确定性竞赛下的博弈演化
现实中的竞赛往往伴随着不可预测的环境扰动或个人临场状态波动,即 ,其中 为噪声尺度参数, 为独立同分布的随机变量。
5.1 命题 6 & 11:高随机性下的纯策略纳什均衡
🎯 Proposition 6 & 11:高不确定性下的确定性纯策略纳什均衡 【命题内容】当噪声尺度 充分大时,由于外部环境的不确定性本身已为博弈提供了充足的随机性,参赛者无需再通过混合策略自我随机化。此时博弈存在唯一的确定性纯策略纳什均衡: 其中常数 仅由噪声分布的先验形态决定。 |
|---|
5.2 命题 7 & 8:均匀噪声下的离散有限支持集均衡
🎲 Proposition 7 & 8:噪声临界阈值与离散有限点混合策略 【命题内容】设单一竞赛中 ,存在临界噪声阈值 : 1. 若 ,存在唯一纯策略均衡 ; 2. 若 ,存在唯一的整数 使得 ,博弈均衡为具有 个离散点的混合策略: 【双竞赛拓展(Proposition 8)】对于正相关对称双竞赛,临界阈值为 ,均衡策略在对角线 上同样呈现出从纯策略向 离散点的离散混合策略过渡。 |
|---|
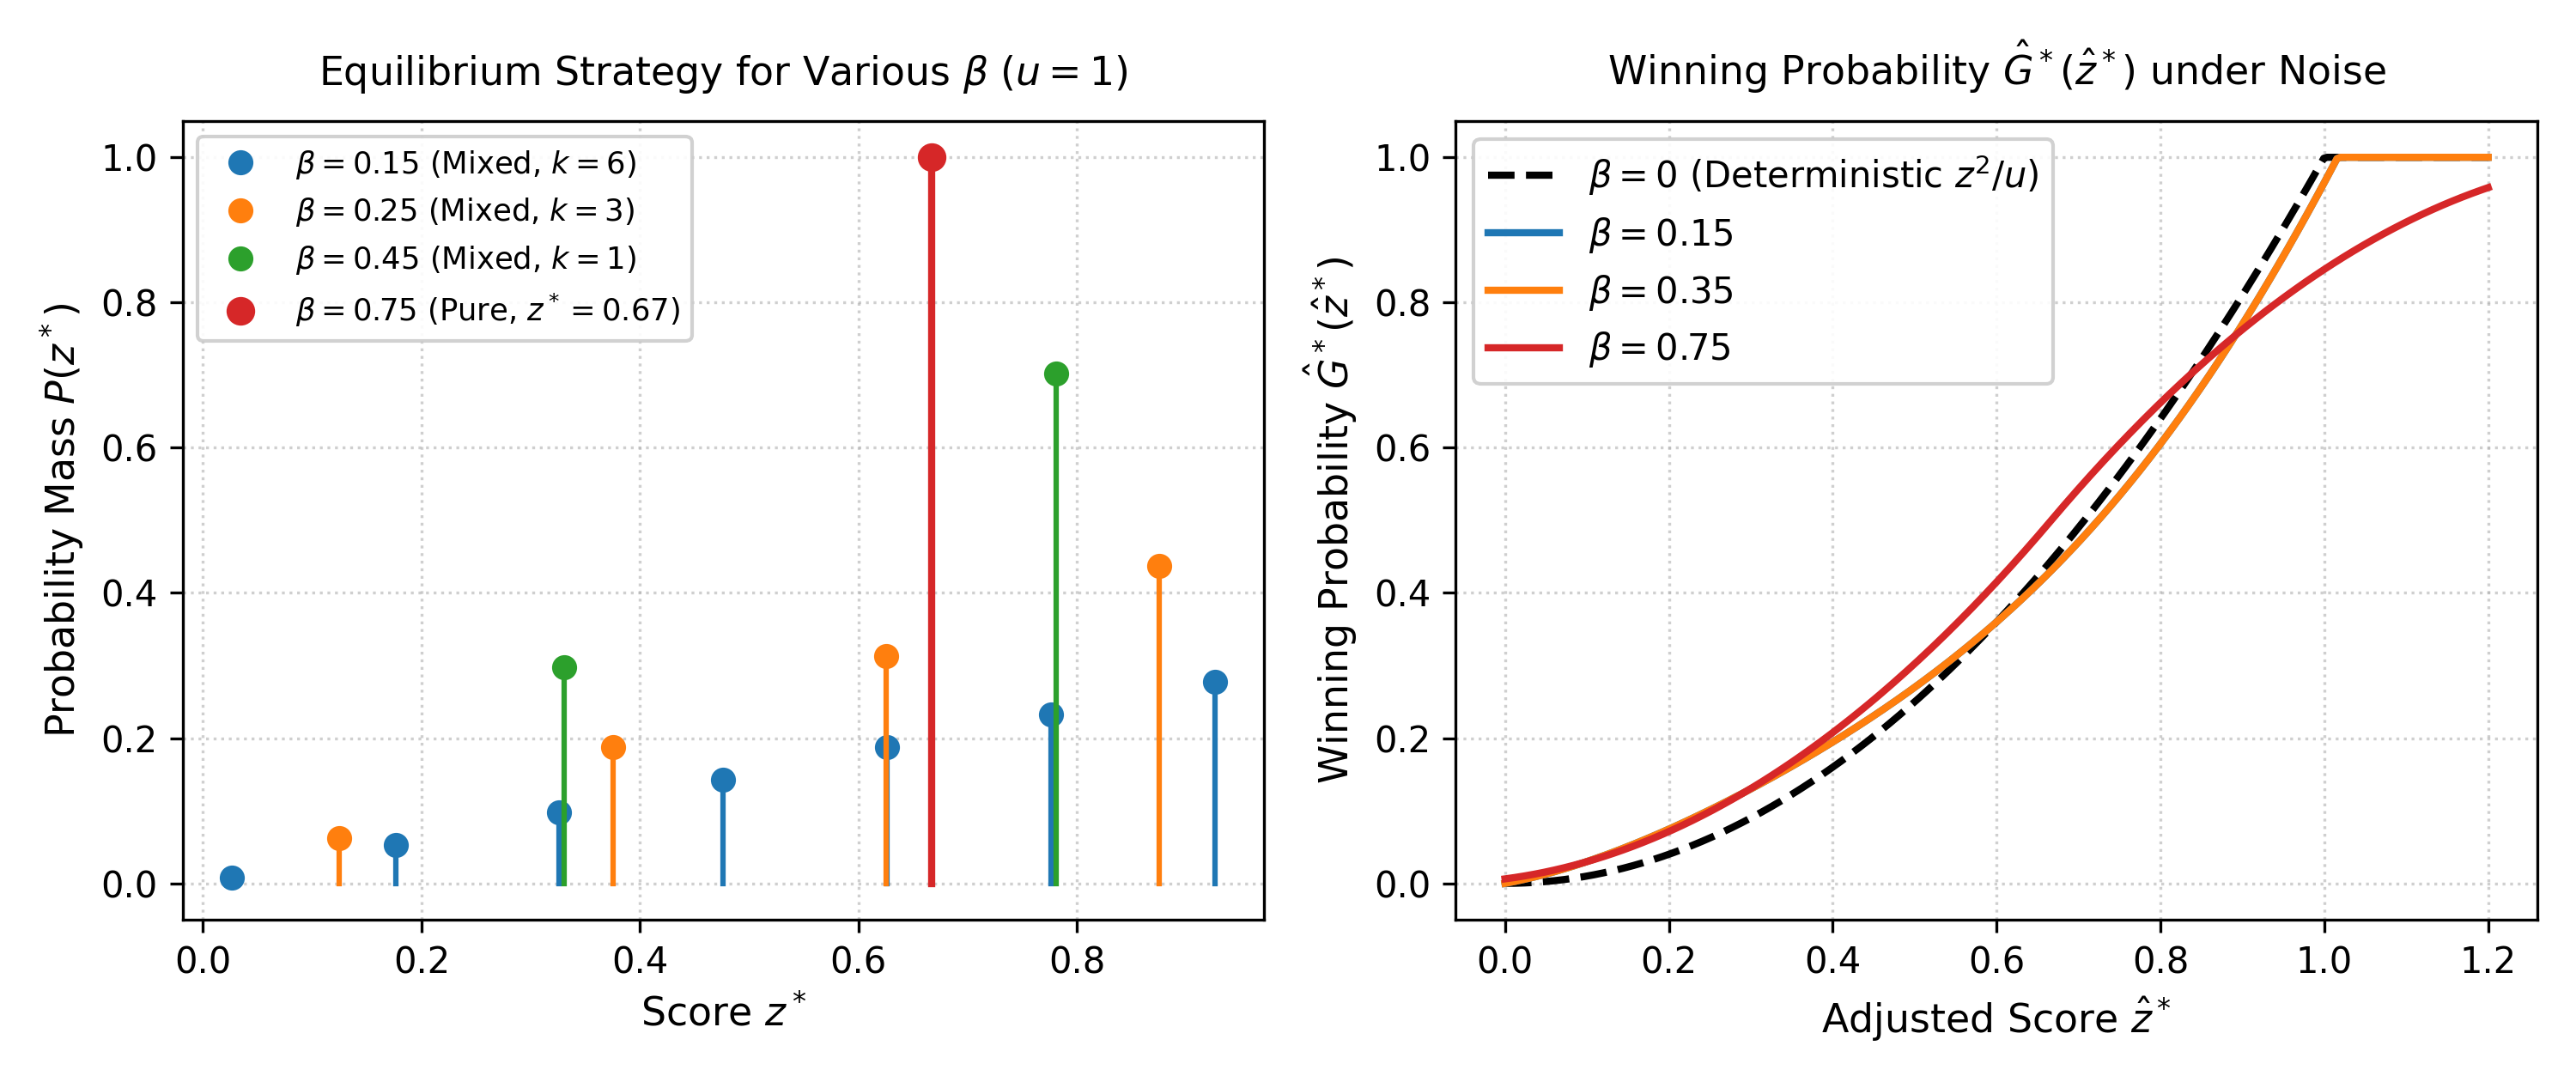
图 6:均匀噪声下单竞赛离散混合策略概率分布(左)与卷积胜率函数 (右)
【图 6 核心启示】图 6 完美解答了博弈论中长期存在的经典难题:随着环境噪声 从大到小变化,均衡策略如何从纯策略单点平滑演进到连续混合策略。当 逐渐减小时,离散点数 阶梯式增加,参赛者在努力上展现出更丰富的多样性,其卷积胜率函数 则始终紧密贴合确定性基准 。
六、异质性拓展与信息结构对博弈的纯化
现实中参赛者的技能天赋和学习成本存在天然差异。设参赛者 具有独特的正定成本矩阵 ,其在两场竞赛中的个性化感知相关性为 。为隔离干扰,假设各参赛者在两场竞赛中的单项竞争力相同(),仅在两竞赛正相关性程度 上存在差异。
6.1 命题 9:完全信息博弈下的冷酷“挤出效应”
🚫 Proposition 9:完全信息透明下的赢家通吃与冷酷挤出效应 【命题内容】若所有参赛者的成本矩阵 为公开信息,将参赛者按相关性从大到小排序,第 高相关性记为 ,对应群体记为 Class : 1. 若最高梯队 Class 1 仅有 人:仅 Class 1 和 Class 2 参赛者付出努力,其边际分布为: 其余所有 Class () 劣势参赛者完全不付出任何努力(),彻底退出竞争! 2. 若最高梯队 Class 1 有 人:则连 Class 2 也会被彻底挤出,仅 Class 1 内部进行博弈,,其余所有人完全退出。 |
|---|
6.2 命题 10:不完全信息下的“纯化定理”与全员积极参与
✨ Proposition 10:不完全信息下的贝叶斯纳什纯策略与全员激活机制 【命题内容】若参赛者仅知晓自己的相关性 ,而仅知对手的相关性是从公共连续分布 中独立抽取的先验变量: 所有参赛者在确定性博弈均衡下均采用确定性的纯策略(Pure Strategy): 【经济学纯化机制】该公式表明,期望得分 是自身私有天赋 的单调递增连续函数。由于对手无法窥探我的具体天赋,我基于私有信息的确定性纯策略,在对手看来自然呈现为服从分布 的混合随机化策略!信息不对称天然消除了挤出效应,促使全员积极参与。 |
|---|
七、多竞赛博弈模型与启发式聚类合并算法
当竞赛数量拓展至 时,属性矩阵为 。针对线性相关竞赛,命题 12 证明可通过引入权重为 的虚拟属性构造正规化矩阵,其极限 严格收敛到原问题均衡。
7.1 极端相关网络下的解析均衡(命题 13 & 14)
🌐 Proposition 13 & 14:多竞赛非负等价合并与非正射线分散均衡 【命题 13(两两非负相关)】若所有竞赛满足 (),多竞赛博弈可完美规约为单一合成等价竞赛,其合成属性权重通过求解正定非线性方程组 获得。 【命题 14(两两非正相关)】若所有竞赛满足 (),则对于任意 ,存在一个极其优美的 -纳什均衡: 参赛者以均等概率 随机挑选其中一场竞赛,并沿着该竞赛的最有效属性射线进行努力投资(支持集为 条射线的并集)。 |
|---|
7.2 一般相关性多竞赛网络的“启发式聚类合并算法”
针对兼具正负相关性的复杂多竞赛网络,论文提出了一套基于相关性贪心聚合的四步算法:
• 第一步:计算所有剩余竞赛两两之间的相关系数矩阵 ;\n• 第二步:搜寻相关系数最大且为正的一对竞赛 ,利用命题 13 的两两等价合并技术将其融合为单一等价竞赛,并合并其奖酬;\n• 第三步:重复上述贪心合并,直到剩余所有等价竞赛集群之间两两皆为非正相关();\n• 第四步:针对最终残余的非正相关等价竞赛集群,直接执行命题 14 的 射线分散 -均衡策略。
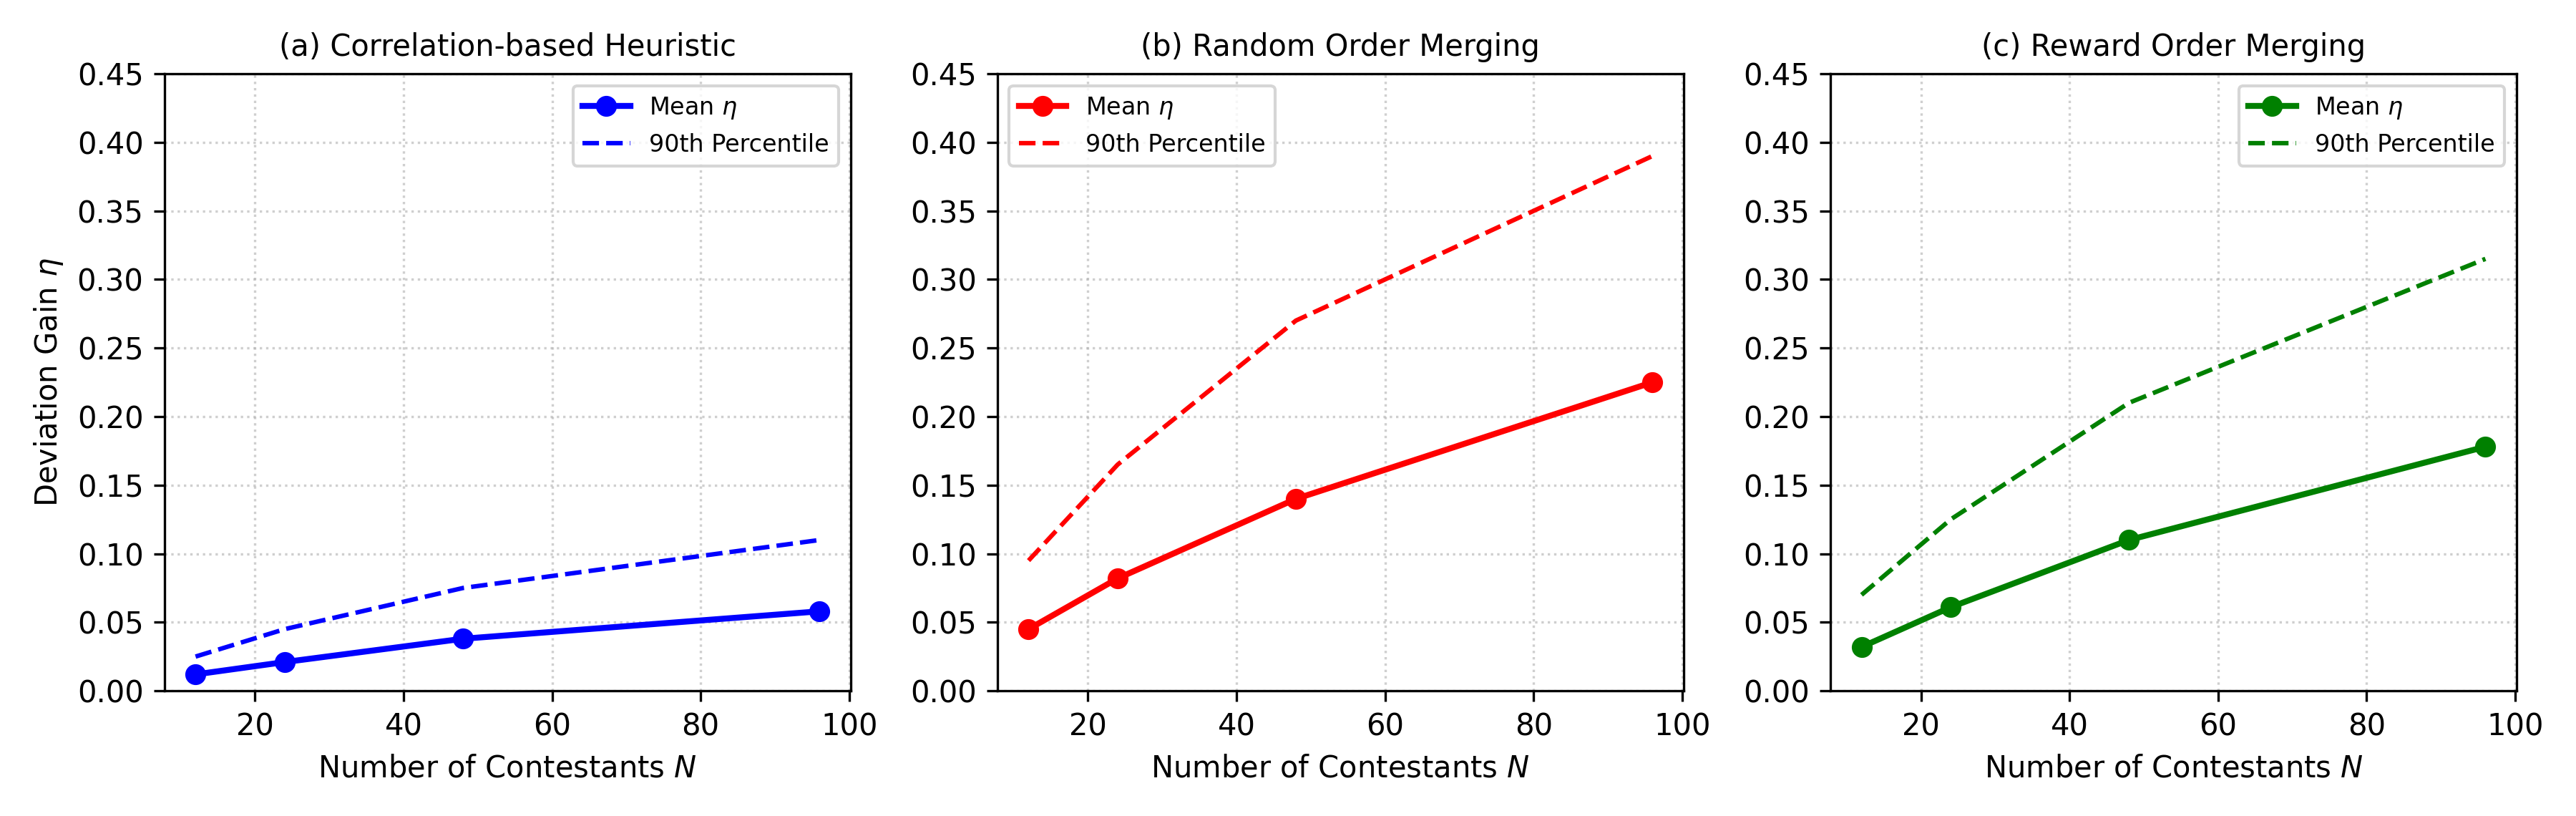
图 7:多竞赛启发式算法偏离收益率 对比((a) 基于相关性贪心合并 vs (b) 随机合并 vs (c) 奖酬降序合并)
【数值实验结论】在 1000 次随机生成的 蒙特卡洛实验中,参赛者偏离该算法的最大相对获益 平均仅为 1%~5%,且显著优于随机合并和按奖金降序合并,证明了相关性维度在多任务决策中的绝对主导地位。
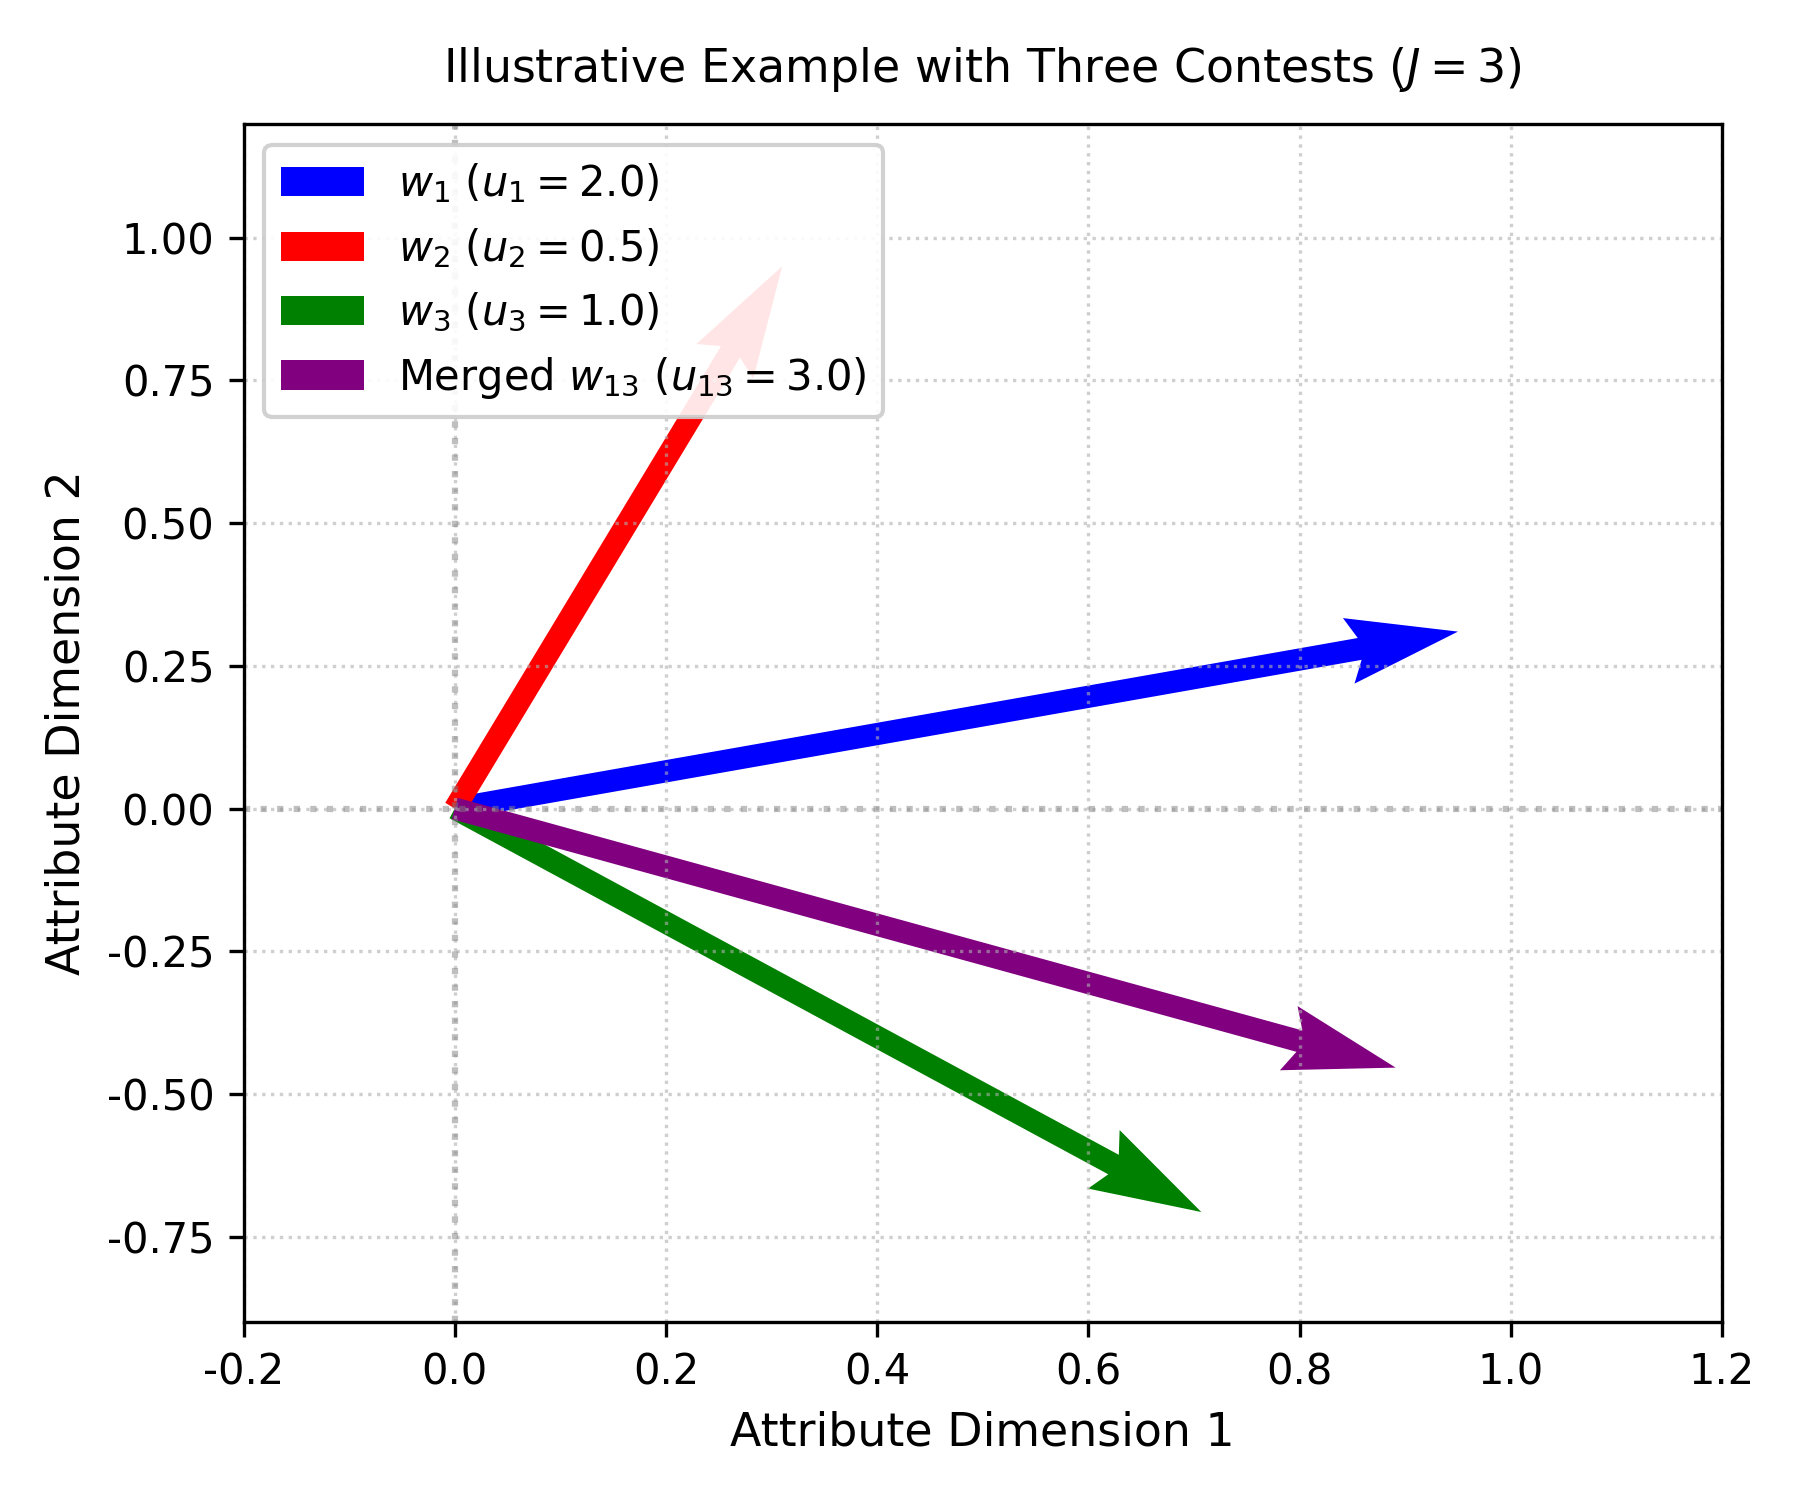
图 8:三竞赛示例():弱正相关合并导致与第三竞赛相关性发生符号突变反转的几何拓扑
八、竞赛设计者的最优奖励分配机制
除了微观参赛者的策略选择,论文更进一步从顶层平台或组织者(Organizer)的视角,探讨了如何设计两场竞赛的相对奖酬分配,以最大化参赛者的总期望产出表现(最高得分)并扣除奖金支出。
🏆 Proposition 15:组织者最优奖金设计与正相关溢出下的奖金压缩法则 【命题 15 内容】在 、确定性且正相关的两场竞赛中,设竞赛 组织者的目标函数为 。组织者博弈的最优对称均衡奖励闭式解为: 【核心单调性与经济机制】最优奖励 是竞赛正相关系数 的严格单调递减函数! 数理根源:当两场竞赛属性高度正相关时,努力具有强大的正向外溢效应,参赛者为了在竞赛 1 中获胜而付出的努力天然提升了竞赛 2 的得分。组织者敏锐地捕获到了这一内生动力,从而可以顺水推舟主动压缩单项奖金额度,以极低的奖金成本撬动极高的全员产出,有效防止了过度激励造成的租金消散。 |
|---|
九、组织管理启示与决策建议
9.1 多任务绩效考核与岗位技能设计
在现代企业管理中,员工往往身兼数职。如果多项工作底层所需的核心技能(如大客户销售与客户售后维护)是高度正相关的,管理层应采用综合打包考核与合并奖金制度,激励员工朝最优属性方向线性提升努力;反之,如果工作要求高度排他冲突(如严格质量把关与极速交期),管理层切忌采取模糊的综合考评,而应设置分立的专项考核,或在激烈竞争环境中引导员工专精单一细分赛道(命题 5 极限射线聚焦)。
9.2 研发平台与创新竞赛的信息透明度控制
命题 9 与命题 10 的对比为创新平台与政府招标提供了极具颠覆性的洞见:完全透明的信息披露(公开所有竞争者的底牌与特长)会造成严重的挤出效应,使广大中游参与者彻底丧失动力(躺平);相反,平台策略性地保留信息壁垒,使得每个人都基于私有优势持有获胜期望,反而能将博弈“纯化”为全员高水平努力的纯策略纳什均衡。
9.3 跨部门奖金池的全局协同联动
根据命题 15 的最优机制设计,奖金分配绝非孤立决策。对于具有技术共享与技能溢出的跨业务板块,应适度调低单一板块的超额奖金,利用内生协同效应为企业节省预算;而对于完全独立的硬科技攻坚,则必须设立高额专项悬赏。
十、全景核心结论与命题特征速查表
为了便于读者系统查阅和直观对比不同相关性与不确定性环境下的博弈特征,下表汇总了本文的核心理论命题与均衡性质:
| 相关性与环境类型 | 数学定义 / 适用条件 | 纳什均衡策略特征 | 支持集几何形态 | 核心代表命题 |
|---|---|---|---|---|
| 正相关竞赛 (Positive) | (确定性环境) | 努力方向高度协同,严格等价于单一合成竞赛;参赛者随机化努力强度 | 穿过原点的一维线性线段 () | Proposition 1 Proposition 13 |
| 零相关竞赛 (Uncorrelated) | (确定性环境) | 两场竞赛完全独立分配,边际分布随 增加由线性向凸减形态演化 | 矩形正交支持集空间 | Proposition 2 |
| 负相关竞赛 (Negative) | (确定性环境) | 两场竞赛排他拉扯,选手兼顾两头,边际概率密度呈倒 U 型隆起 | 非线性向外弯曲椭圆弧段 (极坐标 ODE 解) | Proposition 4 Proposition 5 |
| 完全相反竞赛 (Opposite) | (确定性环境) | 朝一边努力必然损害另一边。 且 时产生全员零努力纯策略 | 一维负斜率线性线段 () | Proposition 3 |
| 高随机性竞赛 (High Noise) | 充分大 (随机噪声环境) | 外部噪声提供天然随机源,参赛者无需混合,直接采取确定性纯策略 | 单一孤立确定性坐标点 (Pure Strategy) | Proposition 6 Proposition 11 |
| 低均匀噪声竞赛 (Uniform Noise) | (随机噪声环境) | 博弈退化为具有 个离散点的混合策略,随 逼近连续分布 | 对角线或轴上的离散点集 (Discrete Points) | Proposition 7 Proposition 8 |
| 完全信息异质性 (Full Info) | 异质成本矩阵 全部参赛者公开 | 产生冷酷挤出效应,仅 Class 1 与 Class 2 参赛,其余全部付出零努力退出 | 低维优势参赛者支持集 (Crowding-out) | Proposition 9 |
| 不完全信息异质性 (Partial Info) | 私有相关性 ,对手服从分布 | 信息不对称扮演纯化器,全员采用关于私有天赋单调递增的纯策略 | 确定性单调递增连续曲线 (Purification) | Proposition 10 |
| 多竞赛非正相关 (Nonpositive) | ( 复杂网络) | 参赛者以 均等概率随机选择单一赛道专攻,形成稳健 -均衡 | 条最有效射线的并集 (Ray Union) | Proposition 14 |
| 组织者奖金设计 (Optimal Reward) | , 确定性正相关双竞赛 | 最优奖金随正相关系数增加而单调递减,组织者借力外溢效应节约成本 | 封闭对称最优解析解 (Optimal ) | Proposition 15 |
He, Jiahao, Jiheng Zhang, and Rachel Q. Zhang. “Effort Decisions in Contests with Shared Attributes.” Mathematics of Operations Research 51(3): 1794–1823.
原文 DOI ↗Google Scholar ↗